


Мы используем файлы cookie и системы аналитики для улучшения работы сайта. Продолжая использовать сайт, Вы соглашаетесь с обработкой персональных данных, собираемых посредством Яндекс Метрика, в целях аналитики посещаемости сайта, Политика обработки персональных данных.
БлогАвторы
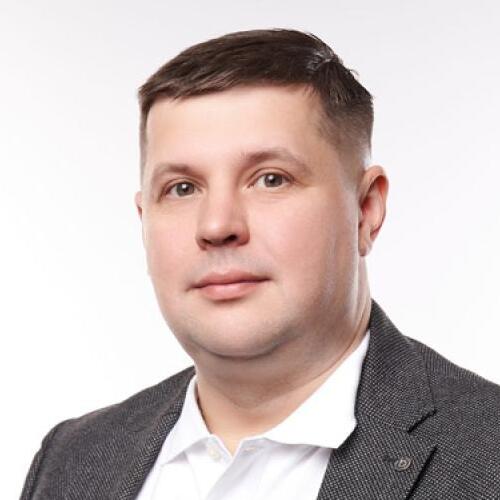
Тимофеев Кирилл
ИТ-директор ОБИТ
Поделиться:
Краткая биография
Выпускник Санкт-Петербургского политехнического университета Петра Великого. Опыт работы в сфере ИТ — свыше 20 лет. Прошел путь от системного администратора до C-level, сформировав экспертизу в управлении ИТ на уровне бизнеса. Специализация — трансформация ИТ: повышение эффективности, внедрение ITSM, масштабирование цифровых инициатив. В команде эксперта свыше 100 специалистов. Обладатель степени MBA в области «Управление в ИТ». Входит в топ-100 ИТ-лидеров по версии Global CIO.
В числе реализованных проектов:
Автоматизация исходящих обзвонов для контакт-центра ГК «Самолет», организация публичной Wi-Fi-сети уровня Enterprise на территории катка у «Газпром-Арены».
Ключевые компетенции
- Управление ИТ на уровне бизнеса: трансформация ИТ-функции, повышение эффективности процессов
- Внедрение ITSM-практик и масштабирование цифровых инициатив в крупных компаниях
- Управление большими ИТ-командами (100+ специалистов) и сложными распределёнными проектами
- Проектирование Enterprise-инфраструктуры: сети, Wi-Fi, контакт-центры для крупного бизнеса
- Автоматизация бизнес-процессов — от обзвонов контакт-центра до цифровых сервисов.
Статьи автора
27.10.2026
Почему крупные компании отдают ИТ на аутсорсинг: основные причины и популярные сценарии из практики
Array
(
[ID] => 3606
[~ID] => 3606
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 101
[~IBLOCK_SECTION_ID] => 101
[NAME] => Почему крупные компании отдают ИТ на аутсорсинг: основные причины и популярные сценарии из практики
[~NAME] => Почему крупные компании отдают ИТ на аутсорсинг: основные причины и популярные сценарии из практики
[ACTIVE_FROM_X] => 2026-10-27 00:00:00
[~ACTIVE_FROM_X] => 2026-10-27 00:00:00
[ACTIVE_FROM] => 27.10.2026
[~ACTIVE_FROM] => 27.10.2026
[TIMESTAMP_X] => 27.10.2026 18:44:42
[~TIMESTAMP_X] => 27.10.2026 18:44:42
[DETAIL_PAGE_URL] => /blog/it-autsorsing/pochemu-krupnye-kompanii-otdayut-it-na-autsorsing-osnovnye-prichiny-i-populyarnye-stsenarii-iz-prakt/
[~DETAIL_PAGE_URL] => /blog/it-autsorsing/pochemu-krupnye-kompanii-otdayut-it-na-autsorsing-osnovnye-prichiny-i-populyarnye-stsenarii-iz-prakt/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] => Логика «ИТ-аутсорсинг нужен тем, у кого нет своего ИТ отдела» выглядит убедительно, пока не посмотреть, кто за эти услуги платит. По исследованию B1 за 2026 год ИТ-поддержка оказалась самой передаваемой наружу функцией: её отдают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Бюджеты такого размера бывают у компаний с тысячами рабочих мест, а не у офиса на двадцать человек.
Ниже — зачем подрядчик компании, у которой есть и свой ИТ-департамент, и собственная разработка, какие сценарии передачи встречаются чаще всего и что крупный бизнес не отдаёт наружу ни при каких условиях. Статья пригодится ИТ-директорам и руководителям ИТ-отделов, которым нужно обосновать такое решение внутри компании.
Кто на самом деле покупает ИТ-аутсорсинг
Крупный бизнес — основной заказчик ИТ-аутсорсинга. Закономерность обратная той, что звучит в мифе: чем больше компания, тем меньше процентная доля ИТ-функций, которую она отдаёт наружу, и тем больше денег она на эти функции тратит.
Удобнее всего это видно на банках, самом регулируемом секторе, где к подрядчикам относятся настороженнее, чем где-либо. По оценкам «Информзащиты», которые приводит «Коммерсантъ» в 2026 году, доля переданных наружу ИТ- и ИБ-функций выглядит так.
Сегмент
2024
2025
Прогноз на 2026
Крупные банки
32–42%
снижение относительно 2024 года
20–30%
Средние банки
42–52%
35–45%
30–40%
Небольшие банки
52–67%
48–62%
45–60%
Даже в сегменте, где Банк России с октября 2025 года рекомендовал отказаться от передачи критичных процессов, у крупных игроков наружу уходит от пятой части до трети работ. От небольших банков крупные отличаются долей переданного, но подрядчики есть и у тех, и у других.
Мотивы при этом меняются. В исследовании B1 экономическую эффективность как причину передачи функций называют 70% компаний, а доступ к внешним знаниям и опыту — 62% против 44% годом раньше. Одновременно доля компаний, которые пытаются закрыть проблему эффективности только наймом, упала с 33 до 23%. Аутсорсинг перестал быть способом сэкономить на штате и стал способом получить то, чего в штате нет.
Почему у крупной компании есть и свой ИТ, и подрядчик
С масштабом вопрос перестаёт звучать как «свои или внешние». Он звучит как «что именно оставить себе».
Крупные российские компании вкладываются в собственное ИТ как никогда раньше. По оценке MWS Cloud, которую в марте 2026 года приводил «Коммерсантъ», выручка дочерних ИТ-структур корпораций в 2025 году составила 1,964 трлн рублей, что на 21% больше, чем годом раньше, и примерно втрое больше, чем четыре года назад. Больше всех вложили финансы и страхование (около 754 млрд рублей), нефтегаз (397 млрд) и ритейл (307 млрд).
Это и есть то самое «держат всё в штате», оформленное отдельной компанией вместо отдела. Занимаются такие структуры разработкой, платформами и продуктами материнского бизнеса. Поддержкой рабочих мест на складе в другом регионе они не занимаются, и строить под это филиальную сеть инженеров никто не планирует.
Дальше начинается арифметика ёмкости. Своя команда ограничена не бюджетом, а количеством часов, которые она способна отработать. Каждый час, потраченный сильным инженером на замену диска в удалённом офисе, это час, не потраченный на интеграцию, миграцию или задачу, которую снаружи вообще никто не сделает. Поэтому крупные компании редко передают ИТ целиком и почти всегда передают его слоями.
Основные причины передачи ИТ на аутсорсинг
Причины, которые в крупном бизнесе срабатывают чаще остальных, разбираем по порядку.
География
У компании с филиалами в тридцати городах два варианта: держать инженера в каждом городе или покупать выезды там, где своих людей нет. Первый вариант означает штат, который 80% времени не загружен. Второй — контракт с подрядчиком, у которого в этих городах есть присутствие.
Проблема в том, что присутствие есть не у всех. По данным B1, качественные аутсорсинговые услуги доступны 33% респондентов из регионов против 78% из Москвы и Санкт-Петербурга. Разница больше чем в два раза, и для распределённой компании это означает, что подрядчика выбирают прежде всего по карте покрытия, а цена идёт вторым вопросом.
Пики и проектные волны
ИТ-нагрузка в крупной компании неровная. Открытие сорока точек за квартал, переезд офиса, миграция на отечественный стек, инвентаризация перед аудитом: всё это требует людей на несколько месяцев, а потом не требует вовсе.
Нанять под такую волну нельзя, потому что пока человек выйдет и войдёт в контекст, волна закончится. Поэтому проектную ёмкость покупают, а постоянную держат в штате.
Компетенции, которые невыгодно держать в штате
Специалист по СХД конкретного производителя, инженер по промышленным сетям, администратор платформы виртуализации, которая стоит в одном контуре из десяти. Такому человеку в компании нашлось бы работы на несколько дней в месяц, а зарплату он хочет за полный.
При этом в момент аварии он нужен немедленно и с опытом десятков похожих инцидентов. Это ровно та позиция, которую экономически оправданно держать на стороне подрядчика, где она загружена проектами нескольких заказчиков.
Круглосуточный режим
Смена из трёх инженеров покрывает рабочий день. Чтобы покрыть 24/7 с подменами, отпусками и больничными, нужно от пяти-шести человек только на дежурство, и это без учёта того, что ночью они в основном ждут. Для производства с непрерывным циклом или ритейла, который работает до 23:00, круглосуточная линия нужна, а собственная выходит дороже покупной.
Предсказуемость и ответственность по договору
Мотив, о котором редко говорят вслух, хотя в крупных компаниях он весит много. У штатной службы нет обязательств: если сервис лежал четыре часа, претензию предъявлять некому и вычитать не из чего. У подрядчика есть договор с метриками, отчётностью и финансовой ответственностью за их нарушение.
Для ИТ-директора это ещё и способ перевести расходы в понятный формат. Вместо фонда оплаты труда, переработок, обучения и закупки инструментов появляется фиксированная сумма за измеримый уровень сервиса, которую легко защитить перед финансовым блоком.
Кадровый дефицит
Нехватку кадров в исследовании B1 называют проблемой 81% компаний, и крупных это касается не меньше: за линейного инженера в регионе они конкурируют с теми же работодателями, что и все остальные.
На практике это значит, что закрыть вакансию бывает дольше, чем заключить контракт на обслуживание. А ещё найденного инженера нужно удержать, и рутина первой линии в этом не помогает.
Популярные сценарии: что именно уходит наружу
Набор того, что крупные компании передают подрядчику, довольно устойчив. Ниже сценарии, которые встречаются чаще всего.
Поддержка рабочих мест в распределённой сети
Самый массовый сценарий. Рабочие места, оргтехника, периферия, установка и переустановка ПО, замена вышедшего из строя железа. Работы однотипные, их много, они размазаны по географии, и ни одна из них не требует особой квалификации.
Масштабы здесь бывают такие, что своими силами задача не решается в принципе. В Татарстане миграцию более 100 тыс. рабочих станций в 82 организациях, включая министерства, ведомства и органы местного самоуправления, Минцифры республики вело вместе с ICL Services. По опубликованному подрядчиком описанию проекта, он собирал данные об оборудовании и приложениях, проверял совместимость, автоматизировал установку и обучал администраторов.
Выездное обслуживание в точках без своих специалистов
Магазины, склады, ПВЗ, производственные площадки, небольшие филиалы. Своего инженера там нет и не будет, а касса, сканер и сетевое оборудование ломаются. Подрядчик закрывает такие площадки выездами по заявке, а своя команда управляет этим процессом, не выезжая.
Здесь важен не сам выезд, а норматив на него. Для магазина простой кассы считается в потерянной выручке за час, поэтому в договоре фиксируют время прибытия по категориям площадок и запас подменного оборудования на складе подрядчика в регионе. Без этих двух пунктов выездная модель превращается в ожидание инженера из соседней области.
Первая линия и дежурная смена
Сценарий, в котором внутренняя команда сознательно отдаёт верхний слой. Приём обращений, типовые операции, восстановление доступов и маршрутизация уходят наружу. Вторая и третья линия, где нужно знание именно вашего ландшафта, остаются внутри. Так свои инженеры перестают разбирать очередь из однотипных заявок и занимаются системами.
Эксплуатация инфраструктуры при своём развитии
Разделение, которое чаще всего встречается в компаниях с собственной ИТ-дочкой или крупным департаментом разработки: развитие, архитектура и прикладные системы остаются своими, эксплуатация инфраструктуры и мониторинг уходят подрядчику. Своя команда при таком раскладе не отвлекается на поддержание работоспособности того, что уже внедрено.
Читайте также
Системы мониторинга ИТ-инфраструктуры
Если собрать эти сценарии в одну картину, граница в крупной компании обычно проходит так.
Слой ИТ
Обычно остаётся внутри
Обычно уходит подрядчику
Рабочие места и оргтехника
стандарты, политики, выбор моделей
установка, ремонт, выезды, замена, перенос данных
Сетевая инфраструктура
архитектура сети, контур ЦОД
обслуживание оборудования филиалов, первая линия по сети
Серверы, СХД, виртуализация
проектирование, ёмкостное планирование
регламентные работы, мониторинг, реагирование на инциденты
Прикладные и отраслевые системы
развитие, доработки, бизнес-логика
поддержка платформ, обновления, администрирование
Информационная безопасность
политики, реагирование на критичные инциденты
аудиты, настройка средств защиты, сопровождение
Управление и архитектура
целиком
не передаётся
Что крупные компании наружу не отдают
У аутсорсинга в крупном бизнесе есть довольно жёсткие границы, и продиктованы они требованиями регуляторов и устройством самого бизнеса.
Первыми идут процессы, которые регулятор требует держать внутри. В банках после рекомендаций Банка России от октября 2025 года в штат и в дочерние структуры уходят мониторинг и реагирование на инциденты, криптография, системы цифрового рубля и ключевая инфраструктура. У интеграторов при этом остаются разработка и поддержка фронтальных систем, аудиты, соответствие PCI DSS и антифрод.
Дальше идёт всё, вокруг чего построено конкурентное преимущество. Платформа, которая отличает компанию от конкурентов, остаётся своей, и вложения в дочерние ИТ-структуры это прямо подтверждают.
Третья граница проходит по архитектурным решениям и ответственности за них. Подрядчик может предложить, посчитать и внедрить, но решение о том, на чём стоит компания, принимает её ИТ-руководитель. Передавать наружу выбор стека — верный способ через два года обнаружить инфраструктуру, которую никто внутри не понимает.
Отдельная тема — привилегированный доступ. В исследовании B1 главными рисками аутсорсинга компании называют утечку корпоративных данных и недостаточную квалификацию исполнителей, по 53% каждый. Основания есть: по данным Cross Technologies, которые приводил «Коммерсантъ», на атаки через поставщиков и подрядчиков в 2025 году пришлось 25–30% киберинцидентов. Отсюда следуют требования к тому, как устроен доступ: отдельные учётные записи для подрядчика, PAM, журналирование его действий и регулярная ревизия выданных прав.
«Чаще всего граница проходит не по системам, а по ответственности. Мы просим заказчика до договора нарисовать карту функций и напротив каждой написать, кто принимает решение и кто отвечает за результат. На этом этапе обычно и выясняется, что половину спорных мест внутри компании понимают по-разному», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как это организуют, чтобы работало
Передача ИТ в крупной компании проваливается не из-за квалификации подрядчика. Она проваливается на стыках, и работа начинается задолго до подписания договора.
Карта функций и граница ответственности. Список всех ИТ-функций с пометкой, какие остаются внутри, какие уходят, какие делятся. Без этого списка на третий месяц появляются заявки, которые не берёт ни одна из сторон.
Документация и доступы. У кого лежит схема сети, кто ведёт реестр активов, что происходит с паролями при смене подрядчика. По нашему опыту это самое уязвимое место: инфраструктура обслуживается нормально, а знание о ней остаётся у внешних инженеров.
SLA, привязанный к последствиям простоя. «Реакция за 15 минут» ничего не говорит о том, когда заработает касса. Работающая метрика привязана к бизнес-процессу: время восстановления критичного сервиса, доступность в часы пик, срок закрытия заявки по категориям.
Одна система заявок. Если внутренняя команда работает в своём трекере, а подрядчик в своём, через полгода никто не сможет ответить, сколько времени реально живёт заявка. В исследовании B1, кстати, видно, как быстро этот участок исправляется, когда им занимаются: жалобы на низкий уровень управления проектами у заказчиков аутсорсинга упали с 47 до 17% за год, а общая удовлетворённость выросла с 71 до 84%.
«Ошибка, которую мы видим чаще всего, — передать подрядчику участок и оставить внутри единственного человека, который понимает, как он связан с остальным. Пока этот человек на месте, всё работает. Поэтому процессы на стыке нужно описывать не для подрядчика, а для себя», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как подойти к решению
Утверждение, что ИТ-аутсорсинг нужен только небольшим компаниям, не подтверждается ни статистикой, ни практикой. Крупный бизнес — главный заказчик этих услуг: ИТ-поддержку передают 75% компаний, а даже в банковском секторе с его требованиями наружу уходит от 20 до 42% ИТ- и ИБ-функций. Размер компании определяет не сам факт аутсорсинга, а его состав: с ростом масштаба процентная доля переданного падает, объём работ и денег растёт, и наружу уходят массовые, географически размазанные и круглосуточные задачи, а ответственность и архитектура остаются внутри.
Первый шаг здесь — инвентаризация: что в вашем ИТ-ландшафте есть, сколько часов на что уходит и какие из этих часов тратятся на то, что ваша команда делает лучше всех. Функции, которые в этот список не попали, и есть кандидаты на передачу.
Если такая задача у вас есть, приходите на бесплатную консультацию: разберём ваш контур, посчитаем, что выгодно оставить внутри, и покажем, как выглядит договор и SLA под ваш режим работы.
Часто задаваемые вопросы (FAQ)
-
Правда ли, что ИТ-аутсорсинг нужен только небольшим компаниям?
Нет. По исследованию B1 за 2026 год ИТ-поддержку передают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Даже в банковском секторе, где регулятор ограничивает передачу критичных процессов, у крупных игроков наружу уходит от 20 до 42% ИТ- и ИБ-функций. С ростом компании меняется не наличие подрядчиков, а их доля и состав работ.
-
Зачем подрядчик компании, у которой есть свой ИТ-департамент?
Свой департамент ограничен количеством часов, которые он может отработать. Массовые однотипные работы, выезды в регионы, круглосуточные дежурства и редкие узкие компетенции съедают эти часы без отдачи для бизнеса. Подрядчик закрывает именно такие слои, а внутренняя команда остаётся на развитии, архитектуре и прикладных системах.
-
Что крупная компания не должна отдавать на аутсорсинг?
Архитектурные решения и ответственность за выбор стека, системы, вокруг которых построено конкурентное преимущество, и процессы, которые регулятор требует держать внутри. В банках после рекомендаций Банка России от октября 2025 года это мониторинг и реагирование на инциденты, криптография и ключевая инфраструктура. Всё остальное передаётся при условии, что зафиксированы границы ответственности и правила доступа.
-
Можно ли передать только часть ИТ и сохранить свой отдел?
Это и есть основная модель в крупном бизнесе. Чаще всего наружу уходит верхний слой: первая линия, поддержка рабочих мест, выезды на удалённые площадки, регламентные работы и мониторинг. Вторая и третья линия, развитие и управление остаются внутри. Разделение фиксируется картой функций, где напротив каждой написано, кто принимает решение и кто отвечает за результат.
-
Как защититься от утечки данных через подрядчика?
Риск реальный: по данным Cross Technologies, которые приводил «Коммерсантъ», на атаки через поставщиков и подрядчиков в 2025 году пришлось 25–30% киберинцидентов. Закрывается он организацией доступа, а не отказом от аутсорсинга: отдельные учётные записи для внешних инженеров, контроль привилегированного доступа через PAM, журналирование действий, ревизия прав по расписанию и обязательства по NDA в договоре.
-
Что нужно подготовить со своей стороны до старта?
Минимум три вещи: перечень ИТ-функций с пометкой, что передаётся, актуальный список активов и площадок, схему сети и контакты владельцев систем. Если инвентаризации давно не было, её делают первым этапом вместе с подрядчиком. По нашему опыту дольше всего занимает не технический переход, а согласование границы ответственности внутри компании.
-
Как измерять работу подрядчика, чтобы это было честно?
Метрики привязываются к бизнес-процессу, а не к скорости ответа в чате. Работают время восстановления критичного сервиса, доступность в часы пик, время прибытия на площадку по её категории и срок закрытия заявок по типам. Заявки при этом должны жить в одной системе у обеих сторон, иначе через полгода никто не сможет посчитать реальные сроки.
[~DETAIL_TEXT] => Логика «ИТ-аутсорсинг нужен тем, у кого нет своего ИТ отдела» выглядит убедительно, пока не посмотреть, кто за эти услуги платит. По исследованию B1 за 2026 год ИТ-поддержка оказалась самой передаваемой наружу функцией: её отдают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Бюджеты такого размера бывают у компаний с тысячами рабочих мест, а не у офиса на двадцать человек.
Ниже — зачем подрядчик компании, у которой есть и свой ИТ-департамент, и собственная разработка, какие сценарии передачи встречаются чаще всего и что крупный бизнес не отдаёт наружу ни при каких условиях. Статья пригодится ИТ-директорам и руководителям ИТ-отделов, которым нужно обосновать такое решение внутри компании.
Кто на самом деле покупает ИТ-аутсорсинг
Крупный бизнес — основной заказчик ИТ-аутсорсинга. Закономерность обратная той, что звучит в мифе: чем больше компания, тем меньше процентная доля ИТ-функций, которую она отдаёт наружу, и тем больше денег она на эти функции тратит.
Удобнее всего это видно на банках, самом регулируемом секторе, где к подрядчикам относятся настороженнее, чем где-либо. По оценкам «Информзащиты», которые приводит «Коммерсантъ» в 2026 году, доля переданных наружу ИТ- и ИБ-функций выглядит так.
Сегмент
2024
2025
Прогноз на 2026
Крупные банки
32–42%
снижение относительно 2024 года
20–30%
Средние банки
42–52%
35–45%
30–40%
Небольшие банки
52–67%
48–62%
45–60%
Даже в сегменте, где Банк России с октября 2025 года рекомендовал отказаться от передачи критичных процессов, у крупных игроков наружу уходит от пятой части до трети работ. От небольших банков крупные отличаются долей переданного, но подрядчики есть и у тех, и у других.
Мотивы при этом меняются. В исследовании B1 экономическую эффективность как причину передачи функций называют 70% компаний, а доступ к внешним знаниям и опыту — 62% против 44% годом раньше. Одновременно доля компаний, которые пытаются закрыть проблему эффективности только наймом, упала с 33 до 23%. Аутсорсинг перестал быть способом сэкономить на штате и стал способом получить то, чего в штате нет.
Почему у крупной компании есть и свой ИТ, и подрядчик
С масштабом вопрос перестаёт звучать как «свои или внешние». Он звучит как «что именно оставить себе».
Крупные российские компании вкладываются в собственное ИТ как никогда раньше. По оценке MWS Cloud, которую в марте 2026 года приводил «Коммерсантъ», выручка дочерних ИТ-структур корпораций в 2025 году составила 1,964 трлн рублей, что на 21% больше, чем годом раньше, и примерно втрое больше, чем четыре года назад. Больше всех вложили финансы и страхование (около 754 млрд рублей), нефтегаз (397 млрд) и ритейл (307 млрд).
Это и есть то самое «держат всё в штате», оформленное отдельной компанией вместо отдела. Занимаются такие структуры разработкой, платформами и продуктами материнского бизнеса. Поддержкой рабочих мест на складе в другом регионе они не занимаются, и строить под это филиальную сеть инженеров никто не планирует.
Дальше начинается арифметика ёмкости. Своя команда ограничена не бюджетом, а количеством часов, которые она способна отработать. Каждый час, потраченный сильным инженером на замену диска в удалённом офисе, это час, не потраченный на интеграцию, миграцию или задачу, которую снаружи вообще никто не сделает. Поэтому крупные компании редко передают ИТ целиком и почти всегда передают его слоями.
Основные причины передачи ИТ на аутсорсинг
Причины, которые в крупном бизнесе срабатывают чаще остальных, разбираем по порядку.
География
У компании с филиалами в тридцати городах два варианта: держать инженера в каждом городе или покупать выезды там, где своих людей нет. Первый вариант означает штат, который 80% времени не загружен. Второй — контракт с подрядчиком, у которого в этих городах есть присутствие.
Проблема в том, что присутствие есть не у всех. По данным B1, качественные аутсорсинговые услуги доступны 33% респондентов из регионов против 78% из Москвы и Санкт-Петербурга. Разница больше чем в два раза, и для распределённой компании это означает, что подрядчика выбирают прежде всего по карте покрытия, а цена идёт вторым вопросом.
Пики и проектные волны
ИТ-нагрузка в крупной компании неровная. Открытие сорока точек за квартал, переезд офиса, миграция на отечественный стек, инвентаризация перед аудитом: всё это требует людей на несколько месяцев, а потом не требует вовсе.
Нанять под такую волну нельзя, потому что пока человек выйдет и войдёт в контекст, волна закончится. Поэтому проектную ёмкость покупают, а постоянную держат в штате.
Компетенции, которые невыгодно держать в штате
Специалист по СХД конкретного производителя, инженер по промышленным сетям, администратор платформы виртуализации, которая стоит в одном контуре из десяти. Такому человеку в компании нашлось бы работы на несколько дней в месяц, а зарплату он хочет за полный.
При этом в момент аварии он нужен немедленно и с опытом десятков похожих инцидентов. Это ровно та позиция, которую экономически оправданно держать на стороне подрядчика, где она загружена проектами нескольких заказчиков.
Круглосуточный режим
Смена из трёх инженеров покрывает рабочий день. Чтобы покрыть 24/7 с подменами, отпусками и больничными, нужно от пяти-шести человек только на дежурство, и это без учёта того, что ночью они в основном ждут. Для производства с непрерывным циклом или ритейла, который работает до 23:00, круглосуточная линия нужна, а собственная выходит дороже покупной.
Предсказуемость и ответственность по договору
Мотив, о котором редко говорят вслух, хотя в крупных компаниях он весит много. У штатной службы нет обязательств: если сервис лежал четыре часа, претензию предъявлять некому и вычитать не из чего. У подрядчика есть договор с метриками, отчётностью и финансовой ответственностью за их нарушение.
Для ИТ-директора это ещё и способ перевести расходы в понятный формат. Вместо фонда оплаты труда, переработок, обучения и закупки инструментов появляется фиксированная сумма за измеримый уровень сервиса, которую легко защитить перед финансовым блоком.
Кадровый дефицит
Нехватку кадров в исследовании B1 называют проблемой 81% компаний, и крупных это касается не меньше: за линейного инженера в регионе они конкурируют с теми же работодателями, что и все остальные.
На практике это значит, что закрыть вакансию бывает дольше, чем заключить контракт на обслуживание. А ещё найденного инженера нужно удержать, и рутина первой линии в этом не помогает.
Популярные сценарии: что именно уходит наружу
Набор того, что крупные компании передают подрядчику, довольно устойчив. Ниже сценарии, которые встречаются чаще всего.
Поддержка рабочих мест в распределённой сети
Самый массовый сценарий. Рабочие места, оргтехника, периферия, установка и переустановка ПО, замена вышедшего из строя железа. Работы однотипные, их много, они размазаны по географии, и ни одна из них не требует особой квалификации.
Масштабы здесь бывают такие, что своими силами задача не решается в принципе. В Татарстане миграцию более 100 тыс. рабочих станций в 82 организациях, включая министерства, ведомства и органы местного самоуправления, Минцифры республики вело вместе с ICL Services. По опубликованному подрядчиком описанию проекта, он собирал данные об оборудовании и приложениях, проверял совместимость, автоматизировал установку и обучал администраторов.
Выездное обслуживание в точках без своих специалистов
Магазины, склады, ПВЗ, производственные площадки, небольшие филиалы. Своего инженера там нет и не будет, а касса, сканер и сетевое оборудование ломаются. Подрядчик закрывает такие площадки выездами по заявке, а своя команда управляет этим процессом, не выезжая.
Здесь важен не сам выезд, а норматив на него. Для магазина простой кассы считается в потерянной выручке за час, поэтому в договоре фиксируют время прибытия по категориям площадок и запас подменного оборудования на складе подрядчика в регионе. Без этих двух пунктов выездная модель превращается в ожидание инженера из соседней области.
Первая линия и дежурная смена
Сценарий, в котором внутренняя команда сознательно отдаёт верхний слой. Приём обращений, типовые операции, восстановление доступов и маршрутизация уходят наружу. Вторая и третья линия, где нужно знание именно вашего ландшафта, остаются внутри. Так свои инженеры перестают разбирать очередь из однотипных заявок и занимаются системами.
Эксплуатация инфраструктуры при своём развитии
Разделение, которое чаще всего встречается в компаниях с собственной ИТ-дочкой или крупным департаментом разработки: развитие, архитектура и прикладные системы остаются своими, эксплуатация инфраструктуры и мониторинг уходят подрядчику. Своя команда при таком раскладе не отвлекается на поддержание работоспособности того, что уже внедрено.
Читайте также
Системы мониторинга ИТ-инфраструктуры
Если собрать эти сценарии в одну картину, граница в крупной компании обычно проходит так.
Слой ИТ
Обычно остаётся внутри
Обычно уходит подрядчику
Рабочие места и оргтехника
стандарты, политики, выбор моделей
установка, ремонт, выезды, замена, перенос данных
Сетевая инфраструктура
архитектура сети, контур ЦОД
обслуживание оборудования филиалов, первая линия по сети
Серверы, СХД, виртуализация
проектирование, ёмкостное планирование
регламентные работы, мониторинг, реагирование на инциденты
Прикладные и отраслевые системы
развитие, доработки, бизнес-логика
поддержка платформ, обновления, администрирование
Информационная безопасность
политики, реагирование на критичные инциденты
аудиты, настройка средств защиты, сопровождение
Управление и архитектура
целиком
не передаётся
Что крупные компании наружу не отдают
У аутсорсинга в крупном бизнесе есть довольно жёсткие границы, и продиктованы они требованиями регуляторов и устройством самого бизнеса.
Первыми идут процессы, которые регулятор требует держать внутри. В банках после рекомендаций Банка России от октября 2025 года в штат и в дочерние структуры уходят мониторинг и реагирование на инциденты, криптография, системы цифрового рубля и ключевая инфраструктура. У интеграторов при этом остаются разработка и поддержка фронтальных систем, аудиты, соответствие PCI DSS и антифрод.
Дальше идёт всё, вокруг чего построено конкурентное преимущество. Платформа, которая отличает компанию от конкурентов, остаётся своей, и вложения в дочерние ИТ-структуры это прямо подтверждают.
Третья граница проходит по архитектурным решениям и ответственности за них. Подрядчик может предложить, посчитать и внедрить, но решение о том, на чём стоит компания, принимает её ИТ-руководитель. Передавать наружу выбор стека — верный способ через два года обнаружить инфраструктуру, которую никто внутри не понимает.
Отдельная тема — привилегированный доступ. В исследовании B1 главными рисками аутсорсинга компании называют утечку корпоративных данных и недостаточную квалификацию исполнителей, по 53% каждый. Основания есть: по данным Cross Technologies, которые приводил «Коммерсантъ», на атаки через поставщиков и подрядчиков в 2025 году пришлось 25–30% киберинцидентов. Отсюда следуют требования к тому, как устроен доступ: отдельные учётные записи для подрядчика, PAM, журналирование его действий и регулярная ревизия выданных прав.
«Чаще всего граница проходит не по системам, а по ответственности. Мы просим заказчика до договора нарисовать карту функций и напротив каждой написать, кто принимает решение и кто отвечает за результат. На этом этапе обычно и выясняется, что половину спорных мест внутри компании понимают по-разному», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как это организуют, чтобы работало
Передача ИТ в крупной компании проваливается не из-за квалификации подрядчика. Она проваливается на стыках, и работа начинается задолго до подписания договора.
Карта функций и граница ответственности. Список всех ИТ-функций с пометкой, какие остаются внутри, какие уходят, какие делятся. Без этого списка на третий месяц появляются заявки, которые не берёт ни одна из сторон.
Документация и доступы. У кого лежит схема сети, кто ведёт реестр активов, что происходит с паролями при смене подрядчика. По нашему опыту это самое уязвимое место: инфраструктура обслуживается нормально, а знание о ней остаётся у внешних инженеров.
SLA, привязанный к последствиям простоя. «Реакция за 15 минут» ничего не говорит о том, когда заработает касса. Работающая метрика привязана к бизнес-процессу: время восстановления критичного сервиса, доступность в часы пик, срок закрытия заявки по категориям.
Одна система заявок. Если внутренняя команда работает в своём трекере, а подрядчик в своём, через полгода никто не сможет ответить, сколько времени реально живёт заявка. В исследовании B1, кстати, видно, как быстро этот участок исправляется, когда им занимаются: жалобы на низкий уровень управления проектами у заказчиков аутсорсинга упали с 47 до 17% за год, а общая удовлетворённость выросла с 71 до 84%.
«Ошибка, которую мы видим чаще всего, — передать подрядчику участок и оставить внутри единственного человека, который понимает, как он связан с остальным. Пока этот человек на месте, всё работает. Поэтому процессы на стыке нужно описывать не для подрядчика, а для себя», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как подойти к решению
Утверждение, что ИТ-аутсорсинг нужен только небольшим компаниям, не подтверждается ни статистикой, ни практикой. Крупный бизнес — главный заказчик этих услуг: ИТ-поддержку передают 75% компаний, а даже в банковском секторе с его требованиями наружу уходит от 20 до 42% ИТ- и ИБ-функций. Размер компании определяет не сам факт аутсорсинга, а его состав: с ростом масштаба процентная доля переданного падает, объём работ и денег растёт, и наружу уходят массовые, географически размазанные и круглосуточные задачи, а ответственность и архитектура остаются внутри.
Первый шаг здесь — инвентаризация: что в вашем ИТ-ландшафте есть, сколько часов на что уходит и какие из этих часов тратятся на то, что ваша команда делает лучше всех. Функции, которые в этот список не попали, и есть кандидаты на передачу.
Если такая задача у вас есть, приходите на бесплатную консультацию: разберём ваш контур, посчитаем, что выгодно оставить внутри, и покажем, как выглядит договор и SLA под ваш режим работы.
Часто задаваемые вопросы (FAQ)
-
Правда ли, что ИТ-аутсорсинг нужен только небольшим компаниям?
Нет. По исследованию B1 за 2026 год ИТ-поддержку передают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Даже в банковском секторе, где регулятор ограничивает передачу критичных процессов, у крупных игроков наружу уходит от 20 до 42% ИТ- и ИБ-функций. С ростом компании меняется не наличие подрядчиков, а их доля и состав работ.
-
Зачем подрядчик компании, у которой есть свой ИТ-департамент?
Свой департамент ограничен количеством часов, которые он может отработать. Массовые однотипные работы, выезды в регионы, круглосуточные дежурства и редкие узкие компетенции съедают эти часы без отдачи для бизнеса. Подрядчик закрывает именно такие слои, а внутренняя команда остаётся на развитии, архитектуре и прикладных системах.
-
Что крупная компания не должна отдавать на аутсорсинг?
Архитектурные решения и ответственность за выбор стека, системы, вокруг которых построено конкурентное преимущество, и процессы, которые регулятор требует держать внутри. В банках после рекомендаций Банка России от октября 2025 года это мониторинг и реагирование на инциденты, криптография и ключевая инфраструктура. Всё остальное передаётся при условии, что зафиксированы границы ответственности и правила доступа.
-
Можно ли передать только часть ИТ и сохранить свой отдел?
Это и есть основная модель в крупном бизнесе. Чаще всего наружу уходит верхний слой: первая линия, поддержка рабочих мест, выезды на удалённые площадки, регламентные работы и мониторинг. Вторая и третья линия, развитие и управление остаются внутри. Разделение фиксируется картой функций, где напротив каждой написано, кто принимает решение и кто отвечает за результат.
-
Как защититься от утечки данных через подрядчика?
Риск реальный: по данным Cross Technologies, которые приводил «Коммерсантъ», на атаки через поставщиков и подрядчиков в 2025 году пришлось 25–30% киберинцидентов. Закрывается он организацией доступа, а не отказом от аутсорсинга: отдельные учётные записи для внешних инженеров, контроль привилегированного доступа через PAM, журналирование действий, ревизия прав по расписанию и обязательства по NDA в договоре.
-
Что нужно подготовить со своей стороны до старта?
Минимум три вещи: перечень ИТ-функций с пометкой, что передаётся, актуальный список активов и площадок, схему сети и контакты владельцев систем. Если инвентаризации давно не было, её делают первым этапом вместе с подрядчиком. По нашему опыту дольше всего занимает не технический переход, а согласование границы ответственности внутри компании.
-
Как измерять работу подрядчика, чтобы это было честно?
Метрики привязываются к бизнес-процессу, а не к скорости ответа в чате. Работают время восстановления критичного сервиса, доступность в часы пик, время прибытия на площадку по её категории и срок закрытия заявок по типам. Заявки при этом должны жить в одной системе у обеих сторон, иначе через полгода никто не сможет посчитать реальные сроки.
[DETAIL_TEXT_TYPE] => html
[~DETAIL_TEXT_TYPE] => html
[PREVIEW_TEXT] => Логика «ИТ-аутсорсинг нужен тем, у кого нет своего ИТ отдела» выглядит убедительно, пока не посмотреть, кто за эти услуги платит. По исследованию B1 за 2026 год ИТ-поддержка оказалась самой передаваемой наружу функцией: её отдают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Бюджеты такого размера бывают у компаний с тысячами рабочих мест, а не у офиса на двадцать человек.
[~PREVIEW_TEXT] => Логика «ИТ-аутсорсинг нужен тем, у кого нет своего ИТ отдела» выглядит убедительно, пока не посмотреть, кто за эти услуги платит. По исследованию B1 за 2026 год ИТ-поддержка оказалась самой передаваемой наружу функцией: её отдают подрядчикам 75% компаний, а 23% направляют на ИТ-аутсорсинг больше 90% бюджета по этой статье расходов. Бюджеты такого размера бывают у компаний с тысячами рабочих мест, а не у офиса на двадцать человек.
[PREVIEW_TEXT_TYPE] => text
[~PREVIEW_TEXT_TYPE] => text
[PREVIEW_PICTURE] =>
[~PREVIEW_PICTURE] =>
[LANG_DIR] => /
[~LANG_DIR] => /
[CODE] => pochemu-krupnye-kompanii-otdayut-it-na-autsorsing-osnovnye-prichiny-i-populyarnye-stsenarii-iz-prakt
[~CODE] => pochemu-krupnye-kompanii-otdayut-it-na-autsorsing-osnovnye-prichiny-i-populyarnye-stsenarii-iz-prakt
[EXTERNAL_ID] => 3606
[~EXTERNAL_ID] => 3606
[IBLOCK_TYPE_ID] => content
[~IBLOCK_TYPE_ID] => content
[IBLOCK_CODE] =>
[~IBLOCK_CODE] =>
[IBLOCK_EXTERNAL_ID] =>
[~IBLOCK_EXTERNAL_ID] =>
[LID] => s1
[~LID] => s1
[EDIT_LINK] =>
[DELETE_LINK] =>
[DISPLAY_ACTIVE_FROM] => 27.10.2026
[FIELDS] => Array
(
)
[DISPLAY_PROPERTIES] => Array
(
)
[IPROPERTY_VALUES] => Array
(
[ELEMENT_META_TITLE] => Почему крупные компании отдают ИТ на аутсорсинг: основные причины и популярные сценарии из практики
[ELEMENT_META_DESCRIPTION] => ИТ-поддержку передают подрядчикам 75% компаний, а крупные банки — до 42% ИТ-функций. Зачем ИТ-аутсорсинг нужен крупному бизнесу и что он не отдаёт наружу.
)
)
1
Читать
ИТ-аутсорсинг
27.10.2026
Vendor lock-in в ИТ-аутсорсинге: как не попасть в зависимость от подрядчика и сохранить контроль над инфраструктурой
Array
(
[ID] => 3605
[~ID] => 3605
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 101
[~IBLOCK_SECTION_ID] => 101
[NAME] => Vendor lock-in в ИТ-аутсорсинге: как не попасть в зависимость от подрядчика и сохранить контроль над инфраструктурой
[~NAME] => Vendor lock-in в ИТ-аутсорсинге: как не попасть в зависимость от подрядчика и сохранить контроль над инфраструктурой
[ACTIVE_FROM_X] => 2026-10-27 00:00:00
[~ACTIVE_FROM_X] => 2026-10-27 00:00:00
[ACTIVE_FROM] => 27.10.2026
[~ACTIVE_FROM] => 27.10.2026
[TIMESTAMP_X] => 27.10.2026 18:35:22
[~TIMESTAMP_X] => 27.10.2026 18:35:22
[DETAIL_PAGE_URL] => /blog/it-autsorsing/vendor-lock-in-v-it-autsorsinge-kak-ne-popast-v-zavisimost-ot-podryadchika-i-sokhranit-kontrol-nad-i/
[~DETAIL_PAGE_URL] => /blog/it-autsorsing/vendor-lock-in-v-it-autsorsinge-kak-ne-popast-v-zavisimost-ot-podryadchika-i-sokhranit-kontrol-nad-i/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] => Зависимость от поставщика в российском ИТ давно перестала быть теоретическим риском. По докладу Центра компетенций по импортозамещению в сфере ИКТ, который ЦКИТ представил в мае 2026 года, не меньше 30% крупных компаний продолжают работать на зарубежном корпоративном ПО, купленном до 2022 года, без поддержки и обновлений безопасности. По почте доля доходит до 50%, по виртуализации VMware держится около 40% против примерно 80% до 2022 года. Уйти дорого, остаться опасно, и это и есть lock-in в чистом виде.
Зависимость от ИТ-подрядчика устроена похоже, но заметить её гораздо труднее: она живёт не в лицензии, а в документации, доступах, правах на скрипты и в том, кто внутри компании вообще понимает, как всё работает. Ниже — из чего она складывается, как проверить себя до того, как придётся менять подрядчика, что для этого нужно в договоре и какие роли нельзя отдавать наружу ни при каком разделении.
Чем зависимость от подрядчика отличается от классического lock-in
Классический vendor lock-in привязывает компанию к продукту: форматы данных, лицензионная политика, экосистема вокруг платформы. Он виден в счёте и в условиях продления, поэтому его хотя бы обсуждают на бюджетном комитете. Чем он заканчивается, российский рынок уже посмотрел: в марте 2024 года Microsoft отключил российским юридическим лицам больше пятидесяти облачных сервисов, и у компаний, построивших на них процессы, вариантов в тот момент не было.
Зависимость от сервисного подрядчика в счёте не видна. Абонентская плата не меняется, отчёты приходят, заявки закрываются. Проблема в том, что ИТ-инфраструктура меняется каждый месяц: добавили виртуальную машину, поправили правила на межсетевом экране, перенесли ящики, настроили новое резервное копирование. Каждое такое изменение где-то фиксируется, и если фиксируется оно в системах подрядчика, то через два года актуальная картина вашей инфраструктуры существует только у него.
Дальше включается простая механика. Чем сложнее представить себе смену подрядчика, тем слабее ваша позиция на переговорах о цене и объёме работ, причём никто этим даже не пользуется специально. Достаточно того, что обе стороны понимают расстановку.
Стоимость выхода при этом недооценивают. В ГК Softline приводят оценку, по которой переход на нового подрядчика в среднем обходится втрое дороже той экономии, ради которой выбирали предыдущего, а адаптация команд к новой модели работы занимает до полутора лет.
Из чего складывается зависимость
Зависимость почти никогда не бывает одной. Обычно это пять слоёв, которые нарастают постепенно и каждый сам по себе выглядит безобидно.
Знания и документация
Схема сети, перечень активов, история изменений, причины, по которым пять лет назад сделали именно так. Если документацию ведёт подрядчик у себя, вы теряете её вместе с договором, а новой команде придётся восстанавливать картину по живой инфраструктуре.
Коварность этого слоя в том, что на старте всё обычно в порядке: передача ИТ наружу начинается с инвентаризации, и первая версия документации у заказчика есть. Расходиться она начинает со второго-третьего месяца, когда изменения идут потоком, а обязанности обновлять описание у подрядчика в договоре нет.
Инструменты подрядчика
Мониторинг, система заявок, средства удалённого управления, скрипты автоматизации. Работать на инструментах подрядчика удобно и обычно дешевле: он уже купил лицензии и настроил сценарии. Но вместе с договором уходят история инцидентов, пороги срабатывания и вся автоматизация, а отключение его агентов с ваших машин становится отдельным проектом.
Читайте также
Системы мониторинга ИТ-инфраструктуры
Права на то, что для вас сделали
Самый недооценённый слой. По статье 1297 Гражданского кодекса исключительное право на программу или базу данных, созданную при выполнении договора подряда, который прямо не предусматривал её создание, принадлежит подрядчику. Заказчик получает только простую неисключительную лицензию на использование в целях договора.
На практике это значит, что скрипты развёртывания, шаблоны виртуальных машин, сценарии автоматизации и дашборды, написанные в рамках обычного обслуживания, по умолчанию принадлежат не вам. Обратная ситуация описана в статье 1296: если создание программы было прямым предметом договора, исключительное право принадлежит заказчику, если в договоре не написано иное.
Коммерческое оформление
Проверьте, на какое юридическое лицо оформлены домены, SSL-сертификаты, лицензии на системное и прикладное ПО, аккаунты в облаках, учётные записи у регистраторов и платные подписки. Когда всё это оформлено на подрядчика «чтобы вам было удобнее», смена подрядчика превращается в переоформление десятков активов, половину из которых никто не помнит.
Отдельная история — оборудование в аренде у подрядчика. Межсетевой экран или сервер, которые уедут вместе с ним, стоит знать заранее.
Управление подрядчиком
Самый тихий слой. Договор подписан, отчёты приходят раз в месяц и никем не читаются, SLA не проверяется, перечень объектов обслуживания не актуализировался два года. Формально подрядчик управляется, фактически решения принимает он, потому что только он знает состояние дел.
Как проверить, насколько вы зависимы
Проверка занимает один рабочий день и не требует участия подрядчика. По каждому пункту отвечайте «да» только если можете показать это прямо сейчас, не спрашивая никого снаружи.
Что проверяем
Признак контроля
О чём говорит «нет»
Перечень активов и схема сети
лежат в вашей системе и обновлялись за последний месяц
картина инфраструктуры есть только у подрядчика
Пароли и ключи доступа
в вашем хранилище секретов: подрядчик имеет доступ, а не владение
отзыв доступов в день расторжения невозможен
История заявок и инцидентов
выгружается в читаемом виде вместе с вложениями
причины повторяющихся сбоев уйдут вместе с подрядчиком
Конфигурации и скрипты
в вашем репозитории, права закреплены договором
использовать своё же решение после расторжения нельзя
Домены, лицензии, облачные аккаунты
оформлены на вашу организацию
смена подрядчика превращается в переоформление активов
Мониторинг
ваша система либо в договоре есть условия замены
останетесь без наблюдения за инфраструктурой в день перехода
Резервные копии
хранятся на вашей стороне, восстановление проверялось
данные зависят от инфраструктуры подрядчика
План выхода
есть приложением к договору
срок и стоимость перехода неизвестны
Главная проверка не в таблице. Возьмите один критичный сервис и опишите на бумаге, что конкретно нужно сделать, чтобы его обслуживал кто-то другой: какие артефакты запросить, сколько времени займёт передача, что в этот период будет работать хуже. Если описание не складывается, зависимость уже есть, независимо от того, что написано в договоре.
Что об этом говорит регулятор
В банковском секторе управление зависимостью от подрядчика перестало быть вопросом зрелости и стало требованием. С 1 октября 2025 года в Положении Банка России № 716-П действует глава 8.1 об управлении риском аутсорсинга, и она довольно подробно описывает, как это устроено.
До передачи критически важного процесса организация обязана оценить риск зависимости от одного подрядчика или группы подрядчиков и возможность замены поставщика либо выполнения процесса своими силами. Стратегия прекращения предусматривает, что при невозможности выполнения процесса подрядчиком его выполняет сама организация. Для информационных систем требуются планы прекращения на случай, если уровень зависимости от одного поставщика превысит предельный.
Дальше по тексту главы: не реже раза в год анализируется целесообразность аутсорсинга, в том числе сравнением с предложениями других поставщиков. Порядок прекращения включает передачу организации накопленных данных, прекращение доступа поставщика к системам, уничтожение данных на его стороне под контролем представителей организации и акт о прекращении с взаиморасчётом.
Требование распространяется на кредитные организации, но как шаблон работает для любой компании. Если выбросить банковскую специфику, остаётся четыре вещи: оценить риск зависимости до передачи, заранее понимать, кто и как подхватит процесс, раз в год пересматривать решение и иметь описанный порядок выхода. Ни один из этих пунктов не требует лицензии.
Чем закрыть зависимость в договоре
Про документацию, доступы и переходный период при расторжении сейчас пишут довольно часто. Пункты ниже встречаются реже, а стоят дороже всего.
Права на результаты работ
Общая формулировка про конфиденциальность здесь не помогает. Нужна прямая запись о том, что исключительное право на конфигурации, скрипты, шаблоны и документацию, созданные в рамках договора, принадлежит заказчику, иначе действует общее правило статьи 1297 ГК РФ. Для критичных самописных решений в ГК Softline рекомендуют эскроу-соглашения: исходный код и критическая документация передаются на хранение третьей стороне и становятся доступны заказчику при наступлении оговорённых событий.
Условия замены инструментов подрядчика
Если обслуживание идёт на его мониторинге и его системе заявок, в договоре должно быть написано, что происходит при расторжении: выгрузка истории в оговорённом формате, срок, в который агенты снимаются с ваших машин, и возможность выкупить или продлить лицензии на переходный период.
План выхода как приложение
Полноценный документ вместо абзаца про тридцать дней: перечень передаваемых артефактов, ответственные с обеих сторон, порядок передачи доступов, длительность параллельной работы и критерий, по которому переход считается завершённым. Такой план стоит один раз прогнать на учениях, хотя бы по одному сервису: именно на прогоне выясняется, что выгрузка из системы заявок приходит без вложений, а половина скриптов тянет за собой библиотеку подрядчика.
О чём спросить до подписания
Четыре вопроса на этапе выбора показывают отношение подрядчика к зависимости лучше, чем любая презентация.
Первый: в чьей системе будет вестись документация и как она передаётся. Второй: что из инструментов обслуживания принадлежит подрядчику и на каких условиях остаётся у заказчика при расторжении. Третий: кому по договору принадлежат права на созданные конфигурации и скрипты. Четвёртый: есть ли у подрядчика типовой план выхода и готов ли он показать его до подписания.
Нормальный ответ на все четыре вопроса существует, и он не требует от подрядчика жертв. Если же вопросы вызывают раздражение или обещание «разберёмся по ходу», это и есть ответ.
«План выхода имеет смысл писать не в момент ссоры, а на старте, когда обе стороны настроены доброжелательно и готовы договариваться. Мы сами предлагаем заказчикам зафиксировать его в первом же договоре. Подрядчик, который отказывается обсуждать условия выхода, по сути сообщает, что рассчитывает на вашу неспособность уйти», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как не потерять экспертизу внутри компании
Вторая половина вопроса важнее первой. Договор защищает от резкого обрыва, но от медленной потери понимания собственной инфраструктуры он не защищает. Это делается организационно.
Роли, которые остаются внутри
Минимальный набор не зависит от того, сколько функций передано наружу. Нужен владелец ИТ-архитектуры, который принимает решения о том, на чём стоит компания. Нужен владелец доступов и данных: тот, кто ведёт хранилище секретов и утверждает выдачу прав. Нужен менеджер подрядчика, который читает отчёты, сверяет их с реальностью и ведёт перечень объектов обслуживания.
Последнюю роль чаще всего отдают «по совместительству», и именно здесь зависимость нарастает быстрее всего. Человек, у которого управление подрядчиком занимает четыре часа в месяц между основными задачами, через год просто подписывает акты.
Механика передачи знаний
Знания передаются через участие, и отчёты эту работу не делают. Работающие механики простые: ваш инженер присутствует на разборе крупных инцидентов, а не получает резюме; письменный разбор причин по критичным сбоям входит в состав услуги и принимается как результат; статьи базы знаний по типовым операциям пишет подрядчик, но хранятся они у вас и проверяются вашим человеком на читаемость.
Отдельно стоит договориться о доступе ваших сотрудников к системе заявок подрядчика на чтение. Это дешёвая мера, которая даёт ответ на вопрос, что в инфраструктуре ломается чаще всего, без запроса отчёта.
Чего не стоит делать
Передавать функцию целиком вместе с решениями по ней. Подрядчик может предлагать и обосновывать, но выбор между двумя платформами виртуализации, решение о переходе в облако и утверждение схемы резервного копирования остаются за вашим ИТ-руководителем. Иначе через три года инфраструктура будет оптимальна для подрядчика, а не для вас.
Если зависимость уже есть
Разбирается она в том же порядке, в котором нарастала, и обычно не быстро.
Начинается всё с инвентаризации: что есть в инфраструктуре, где это описано и у кого лежит. Дальше артефакты переносятся к вам, причём без расторжения договора: хранилище секретов, репозиторий конфигураций, перечень активов, выгрузка истории заявок. Параллельно переоформляются домены, лицензии и облачные аккаунты. Только после этого имеет смысл обсуждать смену подрядчика или перераспределение функций, потому что до этого момента любой разговор идёт с позиции слабого.
В исследовании B1 за 2026 год утечку корпоративных данных и недостаточную квалификацию исполнителей называют главными рисками аутсорсинга, по 53% каждый. Зависимость в этот список не попала, хотя именно она превращает остальные риски в неустранимые: предъявить требования подрядчику, которого нельзя заменить, довольно сложно.
«Мы несколько раз заходили на инфраструктуру после других подрядчиков и могу сказать, с чего в таких случаях начинается проект. Не с настройки, а с восстановления картины: что здесь есть, кто это ставил и почему. По нашему опыту на крупной распределённой инфраструктуре этот этап занимает недели, и это та работа, которую заказчик оплачивает дважды», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Не попасть в зависимость от подрядчика можно одним условием: владеть артефактами и решениями, а наружу отдавать работу. Документация, пароли, конфигурации, история изменений, права на созданное для вас и оформление активов остаются на вашей стороне, порядок выхода описан до начала работ, а внутри сохраняются три роли: архитектура, доступы и управление подрядчиком. Экспертиза при этом держится на участии ваших людей в разборе инцидентов и изменений.
Первый шаг — диагностика по таблице выше. Если по трём и более пунктам ответ отрицательный, начинать стоит с инвентаризации и приведения артефактов в порядок: разговор о смене подрядчика до этого преждевременен.
Если вы сейчас выбираете подрядчика или хотите проверить действующий договор на зависимость, приходите на бесплатную консультацию: разберём, что уже находится на вашей стороне, чего не хватает и как выглядит рабочий план выхода.
Часто задаваемые вопросы (FAQ)
-
Что такое vendor lock-in в ИТ-аутсорсинге?
Это состояние, в котором смена ИТ-подрядчика или возврат функций внутрь стоит непропорционально дорого или технически невозможен без его участия. В отличие от зависимости от программного продукта, здесь привязка держится на документации, доступах, истории изменений, правах на созданные конфигурации и на том, что внутри компании никто не понимает устройство инфраструктуры целиком.
-
Как понять, что компания уже зависит от ИТ-подрядчика?
Возьмите один критичный сервис и опишите, что нужно сделать, чтобы его обслуживал кто-то другой: какие артефакты запросить, сколько займёт передача, что будет работать хуже. Если описание не складывается, зависимость есть. Быстрая проверка — где лежат перечень активов, пароли, конфигурации и история заявок, и можете ли вы показать их прямо сейчас, не обращаясь к подрядчику.
-
Кому принадлежат скрипты и настройки, которые сделал подрядчик?
По умолчанию подрядчику. Статья 1297 ГК РФ отдаёт исключительное право на программу или базу данных, созданную при выполнении договора подряда, который прямо не предусматривал её создание, исполнителю; заказчик получает только неисключительную лицензию в целях договора. Если создание решения было прямым предметом договора, по статье 1296 право принадлежит заказчику. Поэтому принадлежность конфигураций, скриптов и шаблонов прописывают в договоре отдельным пунктом.
-
Что должно быть в плане выхода из договора на ИТ-аутсорсинг?
Перечень передаваемых артефактов (документация, конфигурации, выгрузки из систем мониторинга и заявок), ответственные с обеих сторон, порядок передачи и отзыва доступов, длительность параллельной работы и критерий завершения перехода. Полезно добавить порядок уничтожения ваших данных на стороне подрядчика с подтверждением. План стоит один раз прогнать на одном сервисе: на прогоне и выясняются неработающие места.
-
Можно ли работать на мониторинге и системе заявок подрядчика?
Можно, это нормальная и обычно более дешёвая схема. Условие одно: в договоре описано, что происходит при расторжении. Нужны выгрузка истории в оговорённом формате, срок снятия агентов с ваших машин и возможность продлить или выкупить лицензии на переходный период. Без этих пунктов в день перехода вы останетесь без наблюдения за инфраструктурой и без истории инцидентов.
-
Какие ИТ-роли нельзя передавать на аутсорсинг?
Три роли остаются внутри независимо от объёма передачи: владелец ИТ-архитектуры, который принимает решения о составе инфраструктуры; владелец доступов и данных, который ведёт хранилище секретов и утверждает выдачу прав; менеджер подрядчика, который читает отчёты, сверяет их с реальностью и актуализирует перечень объектов обслуживания. Последнюю роль нельзя держать «по совместительству»: именно так зависимость и нарастает.
-
Сколько стоит смена ИТ-подрядчика?
Точная сумма зависит от того, насколько инфраструктура описана и где лежат артефакты. В ГК Softline приводят оценку, по которой переход в среднем обходится втрое дороже той экономии, ради которой выбирали предыдущего подрядчика, а адаптация команд занимает до полутора лет. Основные статьи расходов — восстановление картины инфраструктуры, параллельная оплата двух подрядчиков в переходный период и работы вне действующего SLA.
[~DETAIL_TEXT] => Зависимость от поставщика в российском ИТ давно перестала быть теоретическим риском. По докладу Центра компетенций по импортозамещению в сфере ИКТ, который ЦКИТ представил в мае 2026 года, не меньше 30% крупных компаний продолжают работать на зарубежном корпоративном ПО, купленном до 2022 года, без поддержки и обновлений безопасности. По почте доля доходит до 50%, по виртуализации VMware держится около 40% против примерно 80% до 2022 года. Уйти дорого, остаться опасно, и это и есть lock-in в чистом виде.
Зависимость от ИТ-подрядчика устроена похоже, но заметить её гораздо труднее: она живёт не в лицензии, а в документации, доступах, правах на скрипты и в том, кто внутри компании вообще понимает, как всё работает. Ниже — из чего она складывается, как проверить себя до того, как придётся менять подрядчика, что для этого нужно в договоре и какие роли нельзя отдавать наружу ни при каком разделении.
Чем зависимость от подрядчика отличается от классического lock-in
Классический vendor lock-in привязывает компанию к продукту: форматы данных, лицензионная политика, экосистема вокруг платформы. Он виден в счёте и в условиях продления, поэтому его хотя бы обсуждают на бюджетном комитете. Чем он заканчивается, российский рынок уже посмотрел: в марте 2024 года Microsoft отключил российским юридическим лицам больше пятидесяти облачных сервисов, и у компаний, построивших на них процессы, вариантов в тот момент не было.
Зависимость от сервисного подрядчика в счёте не видна. Абонентская плата не меняется, отчёты приходят, заявки закрываются. Проблема в том, что ИТ-инфраструктура меняется каждый месяц: добавили виртуальную машину, поправили правила на межсетевом экране, перенесли ящики, настроили новое резервное копирование. Каждое такое изменение где-то фиксируется, и если фиксируется оно в системах подрядчика, то через два года актуальная картина вашей инфраструктуры существует только у него.
Дальше включается простая механика. Чем сложнее представить себе смену подрядчика, тем слабее ваша позиция на переговорах о цене и объёме работ, причём никто этим даже не пользуется специально. Достаточно того, что обе стороны понимают расстановку.
Стоимость выхода при этом недооценивают. В ГК Softline приводят оценку, по которой переход на нового подрядчика в среднем обходится втрое дороже той экономии, ради которой выбирали предыдущего, а адаптация команд к новой модели работы занимает до полутора лет.
Из чего складывается зависимость
Зависимость почти никогда не бывает одной. Обычно это пять слоёв, которые нарастают постепенно и каждый сам по себе выглядит безобидно.
Знания и документация
Схема сети, перечень активов, история изменений, причины, по которым пять лет назад сделали именно так. Если документацию ведёт подрядчик у себя, вы теряете её вместе с договором, а новой команде придётся восстанавливать картину по живой инфраструктуре.
Коварность этого слоя в том, что на старте всё обычно в порядке: передача ИТ наружу начинается с инвентаризации, и первая версия документации у заказчика есть. Расходиться она начинает со второго-третьего месяца, когда изменения идут потоком, а обязанности обновлять описание у подрядчика в договоре нет.
Инструменты подрядчика
Мониторинг, система заявок, средства удалённого управления, скрипты автоматизации. Работать на инструментах подрядчика удобно и обычно дешевле: он уже купил лицензии и настроил сценарии. Но вместе с договором уходят история инцидентов, пороги срабатывания и вся автоматизация, а отключение его агентов с ваших машин становится отдельным проектом.
Читайте также
Системы мониторинга ИТ-инфраструктуры
Права на то, что для вас сделали
Самый недооценённый слой. По статье 1297 Гражданского кодекса исключительное право на программу или базу данных, созданную при выполнении договора подряда, который прямо не предусматривал её создание, принадлежит подрядчику. Заказчик получает только простую неисключительную лицензию на использование в целях договора.
На практике это значит, что скрипты развёртывания, шаблоны виртуальных машин, сценарии автоматизации и дашборды, написанные в рамках обычного обслуживания, по умолчанию принадлежат не вам. Обратная ситуация описана в статье 1296: если создание программы было прямым предметом договора, исключительное право принадлежит заказчику, если в договоре не написано иное.
Коммерческое оформление
Проверьте, на какое юридическое лицо оформлены домены, SSL-сертификаты, лицензии на системное и прикладное ПО, аккаунты в облаках, учётные записи у регистраторов и платные подписки. Когда всё это оформлено на подрядчика «чтобы вам было удобнее», смена подрядчика превращается в переоформление десятков активов, половину из которых никто не помнит.
Отдельная история — оборудование в аренде у подрядчика. Межсетевой экран или сервер, которые уедут вместе с ним, стоит знать заранее.
Управление подрядчиком
Самый тихий слой. Договор подписан, отчёты приходят раз в месяц и никем не читаются, SLA не проверяется, перечень объектов обслуживания не актуализировался два года. Формально подрядчик управляется, фактически решения принимает он, потому что только он знает состояние дел.
Как проверить, насколько вы зависимы
Проверка занимает один рабочий день и не требует участия подрядчика. По каждому пункту отвечайте «да» только если можете показать это прямо сейчас, не спрашивая никого снаружи.
Что проверяем
Признак контроля
О чём говорит «нет»
Перечень активов и схема сети
лежат в вашей системе и обновлялись за последний месяц
картина инфраструктуры есть только у подрядчика
Пароли и ключи доступа
в вашем хранилище секретов: подрядчик имеет доступ, а не владение
отзыв доступов в день расторжения невозможен
История заявок и инцидентов
выгружается в читаемом виде вместе с вложениями
причины повторяющихся сбоев уйдут вместе с подрядчиком
Конфигурации и скрипты
в вашем репозитории, права закреплены договором
использовать своё же решение после расторжения нельзя
Домены, лицензии, облачные аккаунты
оформлены на вашу организацию
смена подрядчика превращается в переоформление активов
Мониторинг
ваша система либо в договоре есть условия замены
останетесь без наблюдения за инфраструктурой в день перехода
Резервные копии
хранятся на вашей стороне, восстановление проверялось
данные зависят от инфраструктуры подрядчика
План выхода
есть приложением к договору
срок и стоимость перехода неизвестны
Главная проверка не в таблице. Возьмите один критичный сервис и опишите на бумаге, что конкретно нужно сделать, чтобы его обслуживал кто-то другой: какие артефакты запросить, сколько времени займёт передача, что в этот период будет работать хуже. Если описание не складывается, зависимость уже есть, независимо от того, что написано в договоре.
Что об этом говорит регулятор
В банковском секторе управление зависимостью от подрядчика перестало быть вопросом зрелости и стало требованием. С 1 октября 2025 года в Положении Банка России № 716-П действует глава 8.1 об управлении риском аутсорсинга, и она довольно подробно описывает, как это устроено.
До передачи критически важного процесса организация обязана оценить риск зависимости от одного подрядчика или группы подрядчиков и возможность замены поставщика либо выполнения процесса своими силами. Стратегия прекращения предусматривает, что при невозможности выполнения процесса подрядчиком его выполняет сама организация. Для информационных систем требуются планы прекращения на случай, если уровень зависимости от одного поставщика превысит предельный.
Дальше по тексту главы: не реже раза в год анализируется целесообразность аутсорсинга, в том числе сравнением с предложениями других поставщиков. Порядок прекращения включает передачу организации накопленных данных, прекращение доступа поставщика к системам, уничтожение данных на его стороне под контролем представителей организации и акт о прекращении с взаиморасчётом.
Требование распространяется на кредитные организации, но как шаблон работает для любой компании. Если выбросить банковскую специфику, остаётся четыре вещи: оценить риск зависимости до передачи, заранее понимать, кто и как подхватит процесс, раз в год пересматривать решение и иметь описанный порядок выхода. Ни один из этих пунктов не требует лицензии.
Чем закрыть зависимость в договоре
Про документацию, доступы и переходный период при расторжении сейчас пишут довольно часто. Пункты ниже встречаются реже, а стоят дороже всего.
Права на результаты работ
Общая формулировка про конфиденциальность здесь не помогает. Нужна прямая запись о том, что исключительное право на конфигурации, скрипты, шаблоны и документацию, созданные в рамках договора, принадлежит заказчику, иначе действует общее правило статьи 1297 ГК РФ. Для критичных самописных решений в ГК Softline рекомендуют эскроу-соглашения: исходный код и критическая документация передаются на хранение третьей стороне и становятся доступны заказчику при наступлении оговорённых событий.
Условия замены инструментов подрядчика
Если обслуживание идёт на его мониторинге и его системе заявок, в договоре должно быть написано, что происходит при расторжении: выгрузка истории в оговорённом формате, срок, в который агенты снимаются с ваших машин, и возможность выкупить или продлить лицензии на переходный период.
План выхода как приложение
Полноценный документ вместо абзаца про тридцать дней: перечень передаваемых артефактов, ответственные с обеих сторон, порядок передачи доступов, длительность параллельной работы и критерий, по которому переход считается завершённым. Такой план стоит один раз прогнать на учениях, хотя бы по одному сервису: именно на прогоне выясняется, что выгрузка из системы заявок приходит без вложений, а половина скриптов тянет за собой библиотеку подрядчика.
О чём спросить до подписания
Четыре вопроса на этапе выбора показывают отношение подрядчика к зависимости лучше, чем любая презентация.
Первый: в чьей системе будет вестись документация и как она передаётся. Второй: что из инструментов обслуживания принадлежит подрядчику и на каких условиях остаётся у заказчика при расторжении. Третий: кому по договору принадлежат права на созданные конфигурации и скрипты. Четвёртый: есть ли у подрядчика типовой план выхода и готов ли он показать его до подписания.
Нормальный ответ на все четыре вопроса существует, и он не требует от подрядчика жертв. Если же вопросы вызывают раздражение или обещание «разберёмся по ходу», это и есть ответ.
«План выхода имеет смысл писать не в момент ссоры, а на старте, когда обе стороны настроены доброжелательно и готовы договариваться. Мы сами предлагаем заказчикам зафиксировать его в первом же договоре. Подрядчик, который отказывается обсуждать условия выхода, по сути сообщает, что рассчитывает на вашу неспособность уйти», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как не потерять экспертизу внутри компании
Вторая половина вопроса важнее первой. Договор защищает от резкого обрыва, но от медленной потери понимания собственной инфраструктуры он не защищает. Это делается организационно.
Роли, которые остаются внутри
Минимальный набор не зависит от того, сколько функций передано наружу. Нужен владелец ИТ-архитектуры, который принимает решения о том, на чём стоит компания. Нужен владелец доступов и данных: тот, кто ведёт хранилище секретов и утверждает выдачу прав. Нужен менеджер подрядчика, который читает отчёты, сверяет их с реальностью и ведёт перечень объектов обслуживания.
Последнюю роль чаще всего отдают «по совместительству», и именно здесь зависимость нарастает быстрее всего. Человек, у которого управление подрядчиком занимает четыре часа в месяц между основными задачами, через год просто подписывает акты.
Механика передачи знаний
Знания передаются через участие, и отчёты эту работу не делают. Работающие механики простые: ваш инженер присутствует на разборе крупных инцидентов, а не получает резюме; письменный разбор причин по критичным сбоям входит в состав услуги и принимается как результат; статьи базы знаний по типовым операциям пишет подрядчик, но хранятся они у вас и проверяются вашим человеком на читаемость.
Отдельно стоит договориться о доступе ваших сотрудников к системе заявок подрядчика на чтение. Это дешёвая мера, которая даёт ответ на вопрос, что в инфраструктуре ломается чаще всего, без запроса отчёта.
Чего не стоит делать
Передавать функцию целиком вместе с решениями по ней. Подрядчик может предлагать и обосновывать, но выбор между двумя платформами виртуализации, решение о переходе в облако и утверждение схемы резервного копирования остаются за вашим ИТ-руководителем. Иначе через три года инфраструктура будет оптимальна для подрядчика, а не для вас.
Если зависимость уже есть
Разбирается она в том же порядке, в котором нарастала, и обычно не быстро.
Начинается всё с инвентаризации: что есть в инфраструктуре, где это описано и у кого лежит. Дальше артефакты переносятся к вам, причём без расторжения договора: хранилище секретов, репозиторий конфигураций, перечень активов, выгрузка истории заявок. Параллельно переоформляются домены, лицензии и облачные аккаунты. Только после этого имеет смысл обсуждать смену подрядчика или перераспределение функций, потому что до этого момента любой разговор идёт с позиции слабого.
В исследовании B1 за 2026 год утечку корпоративных данных и недостаточную квалификацию исполнителей называют главными рисками аутсорсинга, по 53% каждый. Зависимость в этот список не попала, хотя именно она превращает остальные риски в неустранимые: предъявить требования подрядчику, которого нельзя заменить, довольно сложно.
«Мы несколько раз заходили на инфраструктуру после других подрядчиков и могу сказать, с чего в таких случаях начинается проект. Не с настройки, а с восстановления картины: что здесь есть, кто это ставил и почему. По нашему опыту на крупной распределённой инфраструктуре этот этап занимает недели, и это та работа, которую заказчик оплачивает дважды», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Не попасть в зависимость от подрядчика можно одним условием: владеть артефактами и решениями, а наружу отдавать работу. Документация, пароли, конфигурации, история изменений, права на созданное для вас и оформление активов остаются на вашей стороне, порядок выхода описан до начала работ, а внутри сохраняются три роли: архитектура, доступы и управление подрядчиком. Экспертиза при этом держится на участии ваших людей в разборе инцидентов и изменений.
Первый шаг — диагностика по таблице выше. Если по трём и более пунктам ответ отрицательный, начинать стоит с инвентаризации и приведения артефактов в порядок: разговор о смене подрядчика до этого преждевременен.
Если вы сейчас выбираете подрядчика или хотите проверить действующий договор на зависимость, приходите на бесплатную консультацию: разберём, что уже находится на вашей стороне, чего не хватает и как выглядит рабочий план выхода.
Часто задаваемые вопросы (FAQ)
-
Что такое vendor lock-in в ИТ-аутсорсинге?
Это состояние, в котором смена ИТ-подрядчика или возврат функций внутрь стоит непропорционально дорого или технически невозможен без его участия. В отличие от зависимости от программного продукта, здесь привязка держится на документации, доступах, истории изменений, правах на созданные конфигурации и на том, что внутри компании никто не понимает устройство инфраструктуры целиком.
-
Как понять, что компания уже зависит от ИТ-подрядчика?
Возьмите один критичный сервис и опишите, что нужно сделать, чтобы его обслуживал кто-то другой: какие артефакты запросить, сколько займёт передача, что будет работать хуже. Если описание не складывается, зависимость есть. Быстрая проверка — где лежат перечень активов, пароли, конфигурации и история заявок, и можете ли вы показать их прямо сейчас, не обращаясь к подрядчику.
-
Кому принадлежат скрипты и настройки, которые сделал подрядчик?
По умолчанию подрядчику. Статья 1297 ГК РФ отдаёт исключительное право на программу или базу данных, созданную при выполнении договора подряда, который прямо не предусматривал её создание, исполнителю; заказчик получает только неисключительную лицензию в целях договора. Если создание решения было прямым предметом договора, по статье 1296 право принадлежит заказчику. Поэтому принадлежность конфигураций, скриптов и шаблонов прописывают в договоре отдельным пунктом.
-
Что должно быть в плане выхода из договора на ИТ-аутсорсинг?
Перечень передаваемых артефактов (документация, конфигурации, выгрузки из систем мониторинга и заявок), ответственные с обеих сторон, порядок передачи и отзыва доступов, длительность параллельной работы и критерий завершения перехода. Полезно добавить порядок уничтожения ваших данных на стороне подрядчика с подтверждением. План стоит один раз прогнать на одном сервисе: на прогоне и выясняются неработающие места.
-
Можно ли работать на мониторинге и системе заявок подрядчика?
Можно, это нормальная и обычно более дешёвая схема. Условие одно: в договоре описано, что происходит при расторжении. Нужны выгрузка истории в оговорённом формате, срок снятия агентов с ваших машин и возможность продлить или выкупить лицензии на переходный период. Без этих пунктов в день перехода вы останетесь без наблюдения за инфраструктурой и без истории инцидентов.
-
Какие ИТ-роли нельзя передавать на аутсорсинг?
Три роли остаются внутри независимо от объёма передачи: владелец ИТ-архитектуры, который принимает решения о составе инфраструктуры; владелец доступов и данных, который ведёт хранилище секретов и утверждает выдачу прав; менеджер подрядчика, который читает отчёты, сверяет их с реальностью и актуализирует перечень объектов обслуживания. Последнюю роль нельзя держать «по совместительству»: именно так зависимость и нарастает.
-
Сколько стоит смена ИТ-подрядчика?
Точная сумма зависит от того, насколько инфраструктура описана и где лежат артефакты. В ГК Softline приводят оценку, по которой переход в среднем обходится втрое дороже той экономии, ради которой выбирали предыдущего подрядчика, а адаптация команд занимает до полутора лет. Основные статьи расходов — восстановление картины инфраструктуры, параллельная оплата двух подрядчиков в переходный период и работы вне действующего SLA.
[DETAIL_TEXT_TYPE] => html
[~DETAIL_TEXT_TYPE] => html
[PREVIEW_TEXT] => Зависимость от поставщика в российском ИТ давно перестала быть теоретическим риском. По докладу Центра компетенций по импортозамещению в сфере ИКТ, который ЦКИТ представил в мае 2026 года, не меньше 30% крупных компаний продолжают работать на зарубежном корпоративном ПО, купленном до 2022 года, без поддержки и обновлений безопасности. По почте доля доходит до 50%, по виртуализации VMware держится около 40% против примерно 80% до 2022 года. Уйти дорого, остаться опасно, и это и есть lock-in в чистом виде.
[~PREVIEW_TEXT] => Зависимость от поставщика в российском ИТ давно перестала быть теоретическим риском. По докладу Центра компетенций по импортозамещению в сфере ИКТ, который ЦКИТ представил в мае 2026 года, не меньше 30% крупных компаний продолжают работать на зарубежном корпоративном ПО, купленном до 2022 года, без поддержки и обновлений безопасности. По почте доля доходит до 50%, по виртуализации VMware держится около 40% против примерно 80% до 2022 года. Уйти дорого, остаться опасно, и это и есть lock-in в чистом виде.
[PREVIEW_TEXT_TYPE] => text
[~PREVIEW_TEXT_TYPE] => text
[PREVIEW_PICTURE] =>
[~PREVIEW_PICTURE] =>
[LANG_DIR] => /
[~LANG_DIR] => /
[CODE] => vendor-lock-in-v-it-autsorsinge-kak-ne-popast-v-zavisimost-ot-podryadchika-i-sokhranit-kontrol-nad-i
[~CODE] => vendor-lock-in-v-it-autsorsinge-kak-ne-popast-v-zavisimost-ot-podryadchika-i-sokhranit-kontrol-nad-i
[EXTERNAL_ID] => 3605
[~EXTERNAL_ID] => 3605
[IBLOCK_TYPE_ID] => content
[~IBLOCK_TYPE_ID] => content
[IBLOCK_CODE] =>
[~IBLOCK_CODE] =>
[IBLOCK_EXTERNAL_ID] =>
[~IBLOCK_EXTERNAL_ID] =>
[LID] => s1
[~LID] => s1
[EDIT_LINK] =>
[DELETE_LINK] =>
[DISPLAY_ACTIVE_FROM] => 27.10.2026
[FIELDS] => Array
(
)
[DISPLAY_PROPERTIES] => Array
(
)
[IPROPERTY_VALUES] => Array
(
[ELEMENT_META_TITLE] => Vendor lock-in в ИТ-аутсорсинге: как не попасть в зависимость от подрядчика и сохранить контроль над инфраструктурой
[ELEMENT_META_DESCRIPTION] => Пять видов зависимости от ИТ-подрядчика, таблица для самопроверки, права на скрипты по ст. 1297 ГК РФ и рабочий план выхода из договора.
)
)
1
Читать
ИТ-аутсорсинг
22.09.2026
Гибридная модель ИТ: как совместить свою команду и аутсорсера без конфликта зон ответственности
Array
(
[ID] => 3567
[~ID] => 3567
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 101
[~IBLOCK_SECTION_ID] => 101
[NAME] => Гибридная модель ИТ: как совместить свою команду и аутсорсера без конфликта зон ответственности
[~NAME] => Гибридная модель ИТ: как совместить свою команду и аутсорсера без конфликта зон ответственности
[ACTIVE_FROM_X] => 2026-09-22 00:00:00
[~ACTIVE_FROM_X] => 2026-09-22 00:00:00
[ACTIVE_FROM] => 22.09.2026
[~ACTIVE_FROM] => 22.09.2026
[TIMESTAMP_X] => 22.09.2026 17:46:28
[~TIMESTAMP_X] => 22.09.2026 17:46:28
[DETAIL_PAGE_URL] => /blog/it-autsorsing/gibridnaya-model-it-kak-sovmestit-svoyu-komandu-i-autsorsera-bez-konflikta-zon-otvetstvennosti/
[~DETAIL_PAGE_URL] => /blog/it-autsorsing/gibridnaya-model-it-kak-sovmestit-svoyu-komandu-i-autsorsera-bez-konflikta-zon-otvetstvennosti/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] =>
Гибридная модель — это схема, при которой часть ИТ-функций остаётся у собственной команды, а часть выполняет внешний подрядчик. В среднем и крупном бизнесе это самый распространённый вариант: полностью внутренний ИТ дорог и уязвим к кадровым провалам, полностью внешний лишает компанию контроля над развитием.
Решить, какие функции оставить, а какие отдать, обычно удаётся за одно совещание. Сложности начинаются потом. Инцидент происходит на границе двух зон, и каждая сторона уверена, что это не её задача. Внутренний администратор меняет настройку и не предупреждает подрядчика. Какая-то работа не попадает ни в одну зону и висит месяцами. Гибрид редко ломается из-за неправильного выбора функций — он ломается на стыках.
Разберём, какие бывают формы гибридной модели, где возникают конфликты и какая механика помогает от них избавиться: от матрицы ответственности до порядка согласования изменений и договорных условий.
Какие бывают формы гибридной модели
Общий принцип деления простой: внутри остаются управление, архитектура и владение критичными системами, наружу уходит исполнение. Но конкретная конструкция зависит от того, что у компании уже есть.
Форма
Что внутри
Что у подрядчика
Кому подходит
Передача эксплуатации
ИТ-директор, архитектура, развитие
Поддержка, администрирование, мониторинг
ИТ обслуживает бизнес, но не является продуктом
Усиление команды
Основной отдел со всеми функциями
Дежурства, пиковые нагрузки, узкие компетенции
Сильная команда, которой не хватает рук
Передача направления
Всё, кроме одного направления
Например, только телефония или только рабочие места
Одно направление требует непрофильных компетенций
Одна и та же компания может двигаться между формами. Часто всё начинается с передачи одного направления, дальше подрядчику отдают дежурства, а через год — всю эксплуатацию.
Хороший пример того, как гибрид устроен экономически, — центр мониторинга информационной безопасности. По оценкам, приведённым в отраслевом разборе на Codeby, запуск собственного SOC обходится в 40–60 млн рублей в год, подписка у внешнего провайдера — в 3–8 млн, а гибридная схема, где провайдер закрывает первую линию, а ядро работает внутри, — в 15–30 млн. Логика та же, что и в общем ИТ: массовое исполнение снаружи, экспертиза и решения внутри.
Где возникают конфликты
Инцидент на стыке зон
Самый частый сценарий. Пользователи не могут зайти в систему учёта. Подрядчик проверил сервер — работает. Внутренний администратор проверил приложение — работает. Проблема оказывается в сетевой настройке, за которую формально не отвечает никто. Пока выясняют, система лежит.
Корень проблемы в том, что ответственность описали по компонентам, а пользователь видит сервис целиком. Каждая сторона выполняет свой SLA, а бизнес стоит.
Изменения без согласования
Внутренний администратор открыл порт для нового подрядчика по разработке. Через неделю аутсорсер при плановой ревизии закрыл его как лишний. Интеграция сломалась, начались взаимные претензии. Ни одна сторона не нарушила своих правил — просто общих правил не было.
Ничьи задачи
Есть работа, которая не укладывается ни в одну зону: продление сертификата, который выпускался однажды пять лет назад, перенос данных уволенного сотрудника, обновление документации после изменений. Каждая сторона считает, что это делает другая, и задача всплывает только после того, как что-то сломалось.
Перекидывание заявок
Пользователь пишет внутреннему администратору, тот перенаправляет подрядчику, подрядчик отвечает, что это не входит в договор, и возвращает обратно. Время решения растёт, а в отчётах обеих сторон заявка закрыта вовремя.
Конкуренция вместо сотрудничества
Внутренняя команда воспринимает подрядчика как угрозу своим рабочим местам и не делится информацией. Подрядчик видит во внутренних специалистах источник проблем и старается свести контакт к минимуму. Формально всё работает, фактически две команды обслуживают одну инфраструктуру, не зная, что делает другая.
Матрица ответственности
Базовый инструмент, без которого гибрид не работает. Матрица RACI описывает для каждого процесса четыре роли: кто исполняет, кто отвечает за результат, кого консультируют и кого информируют.
Ключевое правило — у каждого процесса ровно один ответственный за результат. Если отвечают двое, не отвечает никто. Исполнителей может быть несколько, ответственный — один.
Процесс
Исполняет
Отвечает за результат
Консультирует или в курсе
Заявки пользователей
Подрядчик
Подрядчик по SLA
Руководитель ИТ получает отчёт
Инцидент в критичной системе
Подрядчик и внутренняя команда
Руководитель ИТ
Владелец системы
Изменение конфигурации
Подрядчик
Руководитель ИТ согласует
Служба ИБ
Выдача прав доступа
Подрядчик
Владелец данных
Служба ИБ
Резервное копирование и проверка восстановления
Подрядчик
Подрядчик
Руководитель ИТ получает отчёт
Развитие архитектуры
Внутренняя команда
ИТ-директор
Подрядчик консультирует
Это пример, а не шаблон: распределение зависит от формы гибрида и зрелости сторон. Важно другое — матрица должна описывать процессы, а не компоненты. «Серверы — подрядчику, приложения — нам» порождает ровно тот конфликт на стыке, который описан выше. «Восстановление сервиса после инцидента — отвечает руководитель ИТ, исполняют обе стороны» — нет.
Документ получается компактным, на одну-две страницы, и пересматривается при каждом изменении формы сотрудничества.
Механика взаимодействия с подрядчиком
Единая точка входа
Все заявки поступают в одну систему, независимо от того, кто будет их исполнять. Пользователь не должен знать, какая функция передана подрядчику: он пишет в одно место, а маршрутизация происходит внутри. Общая ITSM-система с доступом обеих команд решает сразу две проблемы — перекидывание заявок становится видимым, а история работ хранится в одном месте.
Исследователи мультивендорного аутсорсинга формулируют это жёстко: без общей сервисной модели с едиными процессами, правилами эскалации и сквозными показателями локальные SLA выполняются формально, а важная для бизнеса система остаётся недоступной.
Правила эскалации
Заранее описано, что происходит, если заявка не решена в срок или затрагивает обе зоны. Кто принимает решение, кого привлекают, через сколько времени вопрос поднимается на уровень выше. Для критичных инцидентов — отдельный канал связи и дежурные контакты с обеих сторон.
Управление изменениями
Любое изменение конфигурации проходит через общий журнал: кто меняет, что, зачем, когда и кто согласовал. Это не бюрократия ради бюрократии. Именно отсутствие такого журнала порождает историю с открытым и закрытым портом. Для стандартных изменений достаточно уведомления, для рискованных — согласования ответственного.
Общая документация и доступы
Схемы, конфигурации, пароли от сервисных учётных записей и история инцидентов хранятся у компании и доступны обеим командам. Подрядчик обновляет документацию после своих изменений, внутренняя команда — после своих. Если документация живёт только в системе одной стороны, вторая работает вслепую.
Регулярные встречи и отчётность
Еженедельная короткая сверка по текущим задачам и ежемесячный разбор показателей: выполнение SLA, накопившиеся задачи, причины повторных обращений, статус критичных изменений, риски. На таких встречах всплывают ничьи задачи и назревающие конфликты, пока они ещё не стали инцидентами.
Читайте также Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Люди: как сделать так, чтобы команды работали вместе
Позиционирование подрядчика
Как внутренняя команда воспримет подрядчика, определяется в первую неделю. Если его представить как «теперь у нас будет нормальная поддержка», внутренние специалисты услышат оценку своей работы и займут оборону. Если как «берём на себя дежурства и рутину, чтобы у вас появилось время на проекты», — услышат помощь.
Внутренних специалистов стоит включать в выбор подрядчика и в формирование матрицы ответственности. Люди поддерживают то, что создавали сами.
Владелец отношений
Со стороны компании нужен один человек, который отвечает за работу с подрядчиком: ставит приоритеты, принимает работы, решает спорные вопросы. Обычно это руководитель ИТ. Без этой роли отношения распадаются на десятки частных контактов, в которых теряется общая картина.
Обмен знаниями
Подрядчик приносит опыт других компаний, внутренняя команда — знание бизнеса. Если обмена нет, каждая сторона остаётся со своей половиной. Совместные разборы крупных инцидентов, где обе команды восстанавливают картину и договариваются, что менять, — лучший способ превратить две команды в одну.
«Сильнее всего гибрид работает там, где внутренняя команда перестаёт тратить время на дежурства и заявки и начинает заниматься тем, ради чего её нанимали, — развитием. В таких проектах через полгода уже никто не вспоминает, что у подрядчика и у штата разные работодатели. Хуже всего, когда подрядчика приводят как упрёк своим. Тогда никакая матрица не поможет», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Что зафиксировать в договоре
Договор с подрядчиком в гибридной модели сложнее, чем при полной передаче, потому что описывает не только зону исполнителя, но и точки пересечения. В нём должны быть:
- матрица ответственности как приложение, с порядком её пересмотра;
- правила эскалации и порядок работы с инцидентами, затрагивающими обе зоны;
- порядок согласования изменений: какие достаточно уведомить, какие требуют одобрения, кто одобряет;
- обязанность подрядчика вести и обновлять документацию, хранящуюся у заказчика;
- формат и периодичность отчётности: выполнение SLA, накопленные задачи, повторные обращения, риски;
- порядок обработки задач, не попавших ни в одну зону, — кто решает, чья это задача, и в какой срок;
- процедура выхода: как передаются доступы, документация и история при расторжении.
Пункт про ничьи задачи почти всегда отсутствует в типовых договорах, а именно он снимает большую часть конфликтов. Достаточно записать, что спорную задачу распределяет руководитель ИТ заказчика в течение одного рабочего дня.
«Мы советуем тратить на матрицу ответственности и порядок изменений больше времени, чем на согласование цены. Цену относительно просто пересмотреть, а неописанные стыки превращаются в конфликты, которые портят рабочие процессы. Хорошая матрица — это две страницы, но за ними месяцы спокойной работы», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Гибридная модель — это схема, в которой собственная ИТ-команда сохраняет управление, архитектуру и владение критичными системами, а внешний подрядчик берёт на себя исполнение: поддержку пользователей, администрирование, мониторинг, дежурства или отдельные направления. Задачи делятся не по компонентам инфраструктуры, а по процессам и слоям: решения внутри, исполнение снаружи. Бывает три основных формы — передача эксплуатации, усиление команды и передача отдельного направления.
Работает гибрид тогда, когда описаны стыки. Для этого нужны матрица ответственности с одним ответственным на каждый процесс, единая точка входа для заявок, общие правила эскалации и изменений, документация, доступная обеим сторонам, и регулярная сверка. Без этой механики каждая сторона формально выполняет свои обязательства, а сервис для бизнеса всё равно ломается на границе.
Практический первый шаг — взять пять-шесть ключевых процессов и для каждого ответить на вопрос, кто отвечает за результат. Если хотя бы на один ответ звучит как «мы вместе» или «зависит от ситуации», это и есть будущий конфликт, и его стоит решить до подписания договора.
Если рассматриваете гибридную модель или уже работаете с подрядчиком, но стыки даются тяжело, приходите на бесплатную консультацию — поможем выбрать форму сотрудничества и выстроить распределение ответственности.
Часто задаваемые вопросы (FAQ)
-
Что такое гибридная модель ИТ?Это схема, при которой часть ИТ-функций выполняет собственная команда, а часть — внешний подрядчик. Обычно внутри остаются управление, архитектура и владение критичными системами, а подрядчику передаётся исполнение: поддержка пользователей, администрирование, мониторинг, дежурства или отдельные направления. В среднем и крупном бизнесе это самый распространённый вариант организации ИТ.
-
Как делятся задачи между своим отделом и подрядчиком?По процессам и слоям, а не по компонентам инфраструктуры. Решения и ответственность за результат по критичным процессам остаются внутри, исполнение передаётся наружу. Распределение фиксируется в матрице ответственности RACI, где для каждого процесса указаны исполнитель, единственный ответственный за результат, а также кого консультируют и информируют.
-
Какие бывают формы гибридной модели?Три основные: передача эксплуатации, когда внутри остаются ИТ-директор и развитие, а поддержку и администрирование ведёт подрядчик; усиление команды, когда подрядчик берёт дежурства, пиковые нагрузки и узкие компетенции; и передача одного направления, например телефонии или рабочих мест.
-
Почему в гибридной модели возникают конфликты?Из-за неописанных стыков. Инциденты на границе зон, которые каждая сторона считает не своими; изменения конфигурации без согласования; задачи, не попавшие ни в одну зону; перекидывание заявок между командами; конкуренция внутренних специалистов с подрядчиком. Каждая сторона при этом формально выполняет свой SLA, а сервис для бизнеса не работает.
-
Что такое матрица RACI и зачем она нужна?Это документ, где для каждого процесса указано, кто его исполняет, кто отвечает за результат, кого консультируют и кого информируют. Главное правило — у каждого процесса ровно один ответственный за результат. Матрица должна описывать процессы, а не компоненты, иначе конфликты на стыках сохранятся. Документ обычно занимает одну-две страницы.
-
Нужна ли общая система заявок?Да. Все заявки должны поступать в одну систему, доступную обеим командам, а пользователь не должен знать, какая функция передана подрядчику. Это делает перекидывание заявок видимым, сохраняет историю работ в одном месте и позволяет измерять сквозное время решения, а не только выполнение SLA каждой стороны.
-
Как сделать, чтобы внутренняя команда не конфликтовала с подрядчиком?Представить подрядчика как помощь, которая освобождает время на проекты, а не как оценку работы внутренних специалистов. Включить свою команду в выбор подрядчика и составление матрицы ответственности. Назначить одного владельца отношений со стороны компании. И проводить совместные разборы крупных инцидентов, где обе стороны договариваются, что менять.
-
Что прописать в договоре при гибридной модели?Матрицу ответственности с порядком её пересмотра, правила эскалации и работы с инцидентами на стыке зон, порядок согласования изменений, обязанность вести документацию на стороне заказчика, формат отчётности, порядок распределения задач, не попавших ни в одну зону, и процедуру выхода с передачей доступов и документации.
Гибридная модель — это схема, при которой часть ИТ-функций остаётся у собственной команды, а часть выполняет внешний подрядчик. В среднем и крупном бизнесе это самый распространённый вариант: полностью внутренний ИТ дорог и уязвим к кадровым провалам, полностью внешний лишает компанию контроля над развитием.
Решить, какие функции оставить, а какие отдать, обычно удаётся за одно совещание. Сложности начинаются потом. Инцидент происходит на границе двух зон, и каждая сторона уверена, что это не её задача. Внутренний администратор меняет настройку и не предупреждает подрядчика. Какая-то работа не попадает ни в одну зону и висит месяцами. Гибрид редко ломается из-за неправильного выбора функций — он ломается на стыках.
Разберём, какие бывают формы гибридной модели, где возникают конфликты и какая механика помогает от них избавиться: от матрицы ответственности до порядка согласования изменений и договорных условий.
Какие бывают формы гибридной модели
Общий принцип деления простой: внутри остаются управление, архитектура и владение критичными системами, наружу уходит исполнение. Но конкретная конструкция зависит от того, что у компании уже есть.
|
Форма |
Что внутри |
Что у подрядчика |
Кому подходит |
|
Передача эксплуатации |
ИТ-директор, архитектура, развитие |
Поддержка, администрирование, мониторинг |
ИТ обслуживает бизнес, но не является продуктом |
|
Усиление команды |
Основной отдел со всеми функциями |
Дежурства, пиковые нагрузки, узкие компетенции |
Сильная команда, которой не хватает рук |
|
Передача направления |
Всё, кроме одного направления |
Например, только телефония или только рабочие места |
Одно направление требует непрофильных компетенций |
Одна и та же компания может двигаться между формами. Часто всё начинается с передачи одного направления, дальше подрядчику отдают дежурства, а через год — всю эксплуатацию.
Хороший пример того, как гибрид устроен экономически, — центр мониторинга информационной безопасности. По оценкам, приведённым в отраслевом разборе на Codeby, запуск собственного SOC обходится в 40–60 млн рублей в год, подписка у внешнего провайдера — в 3–8 млн, а гибридная схема, где провайдер закрывает первую линию, а ядро работает внутри, — в 15–30 млн. Логика та же, что и в общем ИТ: массовое исполнение снаружи, экспертиза и решения внутри.
Где возникают конфликты
Инцидент на стыке зон
Самый частый сценарий. Пользователи не могут зайти в систему учёта. Подрядчик проверил сервер — работает. Внутренний администратор проверил приложение — работает. Проблема оказывается в сетевой настройке, за которую формально не отвечает никто. Пока выясняют, система лежит.
Корень проблемы в том, что ответственность описали по компонентам, а пользователь видит сервис целиком. Каждая сторона выполняет свой SLA, а бизнес стоит.
Изменения без согласования
Внутренний администратор открыл порт для нового подрядчика по разработке. Через неделю аутсорсер при плановой ревизии закрыл его как лишний. Интеграция сломалась, начались взаимные претензии. Ни одна сторона не нарушила своих правил — просто общих правил не было.
Ничьи задачи
Есть работа, которая не укладывается ни в одну зону: продление сертификата, который выпускался однажды пять лет назад, перенос данных уволенного сотрудника, обновление документации после изменений. Каждая сторона считает, что это делает другая, и задача всплывает только после того, как что-то сломалось.
Перекидывание заявок
Пользователь пишет внутреннему администратору, тот перенаправляет подрядчику, подрядчик отвечает, что это не входит в договор, и возвращает обратно. Время решения растёт, а в отчётах обеих сторон заявка закрыта вовремя.
Конкуренция вместо сотрудничества
Внутренняя команда воспринимает подрядчика как угрозу своим рабочим местам и не делится информацией. Подрядчик видит во внутренних специалистах источник проблем и старается свести контакт к минимуму. Формально всё работает, фактически две команды обслуживают одну инфраструктуру, не зная, что делает другая.
Матрица ответственности
Базовый инструмент, без которого гибрид не работает. Матрица RACI описывает для каждого процесса четыре роли: кто исполняет, кто отвечает за результат, кого консультируют и кого информируют.
Ключевое правило — у каждого процесса ровно один ответственный за результат. Если отвечают двое, не отвечает никто. Исполнителей может быть несколько, ответственный — один.
|
Процесс |
Исполняет |
Отвечает за результат |
Консультирует или в курсе |
|
Заявки пользователей |
Подрядчик |
Подрядчик по SLA |
Руководитель ИТ получает отчёт |
|
Инцидент в критичной системе |
Подрядчик и внутренняя команда |
Руководитель ИТ |
Владелец системы |
|
Изменение конфигурации |
Подрядчик |
Руководитель ИТ согласует |
Служба ИБ |
|
Выдача прав доступа |
Подрядчик |
Владелец данных |
Служба ИБ |
|
Резервное копирование и проверка восстановления |
Подрядчик |
Подрядчик |
Руководитель ИТ получает отчёт |
|
Развитие архитектуры |
Внутренняя команда |
ИТ-директор |
Подрядчик консультирует |
Это пример, а не шаблон: распределение зависит от формы гибрида и зрелости сторон. Важно другое — матрица должна описывать процессы, а не компоненты. «Серверы — подрядчику, приложения — нам» порождает ровно тот конфликт на стыке, который описан выше. «Восстановление сервиса после инцидента — отвечает руководитель ИТ, исполняют обе стороны» — нет.
Документ получается компактным, на одну-две страницы, и пересматривается при каждом изменении формы сотрудничества.
Механика взаимодействия с подрядчиком
Единая точка входа
Все заявки поступают в одну систему, независимо от того, кто будет их исполнять. Пользователь не должен знать, какая функция передана подрядчику: он пишет в одно место, а маршрутизация происходит внутри. Общая ITSM-система с доступом обеих команд решает сразу две проблемы — перекидывание заявок становится видимым, а история работ хранится в одном месте.
Исследователи мультивендорного аутсорсинга формулируют это жёстко: без общей сервисной модели с едиными процессами, правилами эскалации и сквозными показателями локальные SLA выполняются формально, а важная для бизнеса система остаётся недоступной.
Правила эскалации
Заранее описано, что происходит, если заявка не решена в срок или затрагивает обе зоны. Кто принимает решение, кого привлекают, через сколько времени вопрос поднимается на уровень выше. Для критичных инцидентов — отдельный канал связи и дежурные контакты с обеих сторон.
Управление изменениями
Любое изменение конфигурации проходит через общий журнал: кто меняет, что, зачем, когда и кто согласовал. Это не бюрократия ради бюрократии. Именно отсутствие такого журнала порождает историю с открытым и закрытым портом. Для стандартных изменений достаточно уведомления, для рискованных — согласования ответственного.
Общая документация и доступы
Схемы, конфигурации, пароли от сервисных учётных записей и история инцидентов хранятся у компании и доступны обеим командам. Подрядчик обновляет документацию после своих изменений, внутренняя команда — после своих. Если документация живёт только в системе одной стороны, вторая работает вслепую.
Регулярные встречи и отчётность
Еженедельная короткая сверка по текущим задачам и ежемесячный разбор показателей: выполнение SLA, накопившиеся задачи, причины повторных обращений, статус критичных изменений, риски. На таких встречах всплывают ничьи задачи и назревающие конфликты, пока они ещё не стали инцидентами.
Читайте также Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Люди: как сделать так, чтобы команды работали вместе
Позиционирование подрядчика
Как внутренняя команда воспримет подрядчика, определяется в первую неделю. Если его представить как «теперь у нас будет нормальная поддержка», внутренние специалисты услышат оценку своей работы и займут оборону. Если как «берём на себя дежурства и рутину, чтобы у вас появилось время на проекты», — услышат помощь.
Внутренних специалистов стоит включать в выбор подрядчика и в формирование матрицы ответственности. Люди поддерживают то, что создавали сами.
Владелец отношений
Со стороны компании нужен один человек, который отвечает за работу с подрядчиком: ставит приоритеты, принимает работы, решает спорные вопросы. Обычно это руководитель ИТ. Без этой роли отношения распадаются на десятки частных контактов, в которых теряется общая картина.
Обмен знаниями
Подрядчик приносит опыт других компаний, внутренняя команда — знание бизнеса. Если обмена нет, каждая сторона остаётся со своей половиной. Совместные разборы крупных инцидентов, где обе команды восстанавливают картину и договариваются, что менять, — лучший способ превратить две команды в одну.
«Сильнее всего гибрид работает там, где внутренняя команда перестаёт тратить время на дежурства и заявки и начинает заниматься тем, ради чего её нанимали, — развитием. В таких проектах через полгода уже никто не вспоминает, что у подрядчика и у штата разные работодатели. Хуже всего, когда подрядчика приводят как упрёк своим. Тогда никакая матрица не поможет», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Что зафиксировать в договоре
Договор с подрядчиком в гибридной модели сложнее, чем при полной передаче, потому что описывает не только зону исполнителя, но и точки пересечения. В нём должны быть:
- матрица ответственности как приложение, с порядком её пересмотра;
- правила эскалации и порядок работы с инцидентами, затрагивающими обе зоны;
- порядок согласования изменений: какие достаточно уведомить, какие требуют одобрения, кто одобряет;
- обязанность подрядчика вести и обновлять документацию, хранящуюся у заказчика;
- формат и периодичность отчётности: выполнение SLA, накопленные задачи, повторные обращения, риски;
- порядок обработки задач, не попавших ни в одну зону, — кто решает, чья это задача, и в какой срок;
- процедура выхода: как передаются доступы, документация и история при расторжении.
Пункт про ничьи задачи почти всегда отсутствует в типовых договорах, а именно он снимает большую часть конфликтов. Достаточно записать, что спорную задачу распределяет руководитель ИТ заказчика в течение одного рабочего дня.
«Мы советуем тратить на матрицу ответственности и порядок изменений больше времени, чем на согласование цены. Цену относительно просто пересмотреть, а неописанные стыки превращаются в конфликты, которые портят рабочие процессы. Хорошая матрица — это две страницы, но за ними месяцы спокойной работы», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Гибридная модель — это схема, в которой собственная ИТ-команда сохраняет управление, архитектуру и владение критичными системами, а внешний подрядчик берёт на себя исполнение: поддержку пользователей, администрирование, мониторинг, дежурства или отдельные направления. Задачи делятся не по компонентам инфраструктуры, а по процессам и слоям: решения внутри, исполнение снаружи. Бывает три основных формы — передача эксплуатации, усиление команды и передача отдельного направления.
Работает гибрид тогда, когда описаны стыки. Для этого нужны матрица ответственности с одним ответственным на каждый процесс, единая точка входа для заявок, общие правила эскалации и изменений, документация, доступная обеим сторонам, и регулярная сверка. Без этой механики каждая сторона формально выполняет свои обязательства, а сервис для бизнеса всё равно ломается на границе.
Практический первый шаг — взять пять-шесть ключевых процессов и для каждого ответить на вопрос, кто отвечает за результат. Если хотя бы на один ответ звучит как «мы вместе» или «зависит от ситуации», это и есть будущий конфликт, и его стоит решить до подписания договора.
Если рассматриваете гибридную модель или уже работаете с подрядчиком, но стыки даются тяжело, приходите на бесплатную консультацию — поможем выбрать форму сотрудничества и выстроить распределение ответственности.
Часто задаваемые вопросы (FAQ)
-
Что такое гибридная модель ИТ?Это схема, при которой часть ИТ-функций выполняет собственная команда, а часть — внешний подрядчик. Обычно внутри остаются управление, архитектура и владение критичными системами, а подрядчику передаётся исполнение: поддержка пользователей, администрирование, мониторинг, дежурства или отдельные направления. В среднем и крупном бизнесе это самый распространённый вариант организации ИТ.
-
Как делятся задачи между своим отделом и подрядчиком?По процессам и слоям, а не по компонентам инфраструктуры. Решения и ответственность за результат по критичным процессам остаются внутри, исполнение передаётся наружу. Распределение фиксируется в матрице ответственности RACI, где для каждого процесса указаны исполнитель, единственный ответственный за результат, а также кого консультируют и информируют.
-
Какие бывают формы гибридной модели?Три основные: передача эксплуатации, когда внутри остаются ИТ-директор и развитие, а поддержку и администрирование ведёт подрядчик; усиление команды, когда подрядчик берёт дежурства, пиковые нагрузки и узкие компетенции; и передача одного направления, например телефонии или рабочих мест.
-
Почему в гибридной модели возникают конфликты?Из-за неописанных стыков. Инциденты на границе зон, которые каждая сторона считает не своими; изменения конфигурации без согласования; задачи, не попавшие ни в одну зону; перекидывание заявок между командами; конкуренция внутренних специалистов с подрядчиком. Каждая сторона при этом формально выполняет свой SLA, а сервис для бизнеса не работает.
-
Что такое матрица RACI и зачем она нужна?Это документ, где для каждого процесса указано, кто его исполняет, кто отвечает за результат, кого консультируют и кого информируют. Главное правило — у каждого процесса ровно один ответственный за результат. Матрица должна описывать процессы, а не компоненты, иначе конфликты на стыках сохранятся. Документ обычно занимает одну-две страницы.
-
Нужна ли общая система заявок?Да. Все заявки должны поступать в одну систему, доступную обеим командам, а пользователь не должен знать, какая функция передана подрядчику. Это делает перекидывание заявок видимым, сохраняет историю работ в одном месте и позволяет измерять сквозное время решения, а не только выполнение SLA каждой стороны.
-
Как сделать, чтобы внутренняя команда не конфликтовала с подрядчиком?Представить подрядчика как помощь, которая освобождает время на проекты, а не как оценку работы внутренних специалистов. Включить свою команду в выбор подрядчика и составление матрицы ответственности. Назначить одного владельца отношений со стороны компании. И проводить совместные разборы крупных инцидентов, где обе стороны договариваются, что менять.
-
Что прописать в договоре при гибридной модели?Матрицу ответственности с порядком её пересмотра, правила эскалации и работы с инцидентами на стыке зон, порядок согласования изменений, обязанность вести документацию на стороне заказчика, формат отчётности, порядок распределения задач, не попавших ни в одну зону, и процедуру выхода с передачей доступов и документации.
Решить, какие функции оставить, а какие отдать, обычно удаётся за одно совещание. Сложности начинаются потом. Инцидент происходит на границе двух зон, и каждая сторона уверена, что это не её задача. Внутренний администратор меняет настройку и не предупреждает подрядчика. Какая-то работа не попадает ни в одну зону и висит месяцами. Гибрид редко ломается из-за неправильного выбора функций — он ломается на стыках. [~PREVIEW_TEXT] => Гибридная модель — это схема, при которой часть ИТ-функций остаётся у собственной команды, а часть выполняет внешний подрядчик. В среднем и крупном бизнесе это самый распространённый вариант: полностью внутренний ИТ дорог и уязвим к кадровым провалам, полностью внешний лишает компанию контроля над развитием. Решить, какие функции оставить, а какие отдать, обычно удаётся за одно совещание. Сложности начинаются потом. Инцидент происходит на границе двух зон, и каждая сторона уверена, что это не её задача. Внутренний администратор меняет настройку и не предупреждает подрядчика. Какая-то работа не попадает ни в одну зону и висит месяцами. Гибрид редко ломается из-за неправильного выбора функций — он ломается на стыках. [PREVIEW_TEXT_TYPE] => text [~PREVIEW_TEXT_TYPE] => text [PREVIEW_PICTURE] => [~PREVIEW_PICTURE] => [LANG_DIR] => / [~LANG_DIR] => / [CODE] => gibridnaya-model-it-kak-sovmestit-svoyu-komandu-i-autsorsera-bez-konflikta-zon-otvetstvennosti [~CODE] => gibridnaya-model-it-kak-sovmestit-svoyu-komandu-i-autsorsera-bez-konflikta-zon-otvetstvennosti [EXTERNAL_ID] => 3567 [~EXTERNAL_ID] => 3567 [IBLOCK_TYPE_ID] => content [~IBLOCK_TYPE_ID] => content [IBLOCK_CODE] => [~IBLOCK_CODE] => [IBLOCK_EXTERNAL_ID] => [~IBLOCK_EXTERNAL_ID] => [LID] => s1 [~LID] => s1 [EDIT_LINK] => [DELETE_LINK] => [DISPLAY_ACTIVE_FROM] => 22.09.2026 [FIELDS] => Array ( ) [DISPLAY_PROPERTIES] => Array ( ) [IPROPERTY_VALUES] => Array ( [ELEMENT_META_TITLE] => Гибридная модель ИТ: как совместить свою команду и аутсорсера без конфликта зон ответственности [ELEMENT_META_DESCRIPTION] => Что такое гибридная модель ИТ, как делятся задачи между своим отделом и подрядчиком, где возникают конфликты и какая механика помогает их избежать: RACI, эскалация, изменения. ) ) 1 Читать
ИТ-аутсорсинг
22.09.2026
Внешний ИТ-аудит: чего не видно изнутри и в каких случаях нужна проверка
Array
(
[ID] => 3566
[~ID] => 3566
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 101
[~IBLOCK_SECTION_ID] => 101
[NAME] => Внешний ИТ-аудит: чего не видно изнутри и в каких случаях нужна проверка
[~NAME] => Внешний ИТ-аудит: чего не видно изнутри и в каких случаях нужна проверка
[ACTIVE_FROM_X] => 2026-09-22 00:00:00
[~ACTIVE_FROM_X] => 2026-09-22 00:00:00
[ACTIVE_FROM] => 22.09.2026
[~ACTIVE_FROM] => 22.09.2026
[TIMESTAMP_X] => 22.09.2026 16:43:05
[~TIMESTAMP_X] => 22.09.2026 16:43:05
[DETAIL_PAGE_URL] => /blog/it-autsorsing/vneshniy-it-audit-chego-ne-vidno-iznutri-i-v-kakikh-sluchayakh-nuzhna-proverka/
[~DETAIL_PAGE_URL] => /blog/it-autsorsing/vneshniy-it-audit-chego-ne-vidno-iznutri-i-v-kakikh-sluchayakh-nuzhna-proverka/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] =>
«Зачем платить за аудит, если наш администратор и так всё знает?» — вопрос справедливый, и задают его обычно не от непонимания. Чаще всего так формулирует собственник или финансовый директор, которому администратор говорит, что в инфраструктуре всё в порядке. А иногда и сам администратор, который воспринимает внешнюю проверку как недоверие к своей работе.
Ответ в том, что знать инфраструктуру и объективно её оценить — разные задачи. Хороший администратор действительно знает, где что стоит и как работает. Но он видит свою инфраструктуру изнутри, без сравнения с другими, с годами накопленного привыкания и без времени на ревизию собственных решений. Внешний аудит нужен не потому, что админ плохой, а потому, что некоторые вещи изнутри не видны в принципе.
Разберём, что именно не видно изнутри, почему администратор выигрывает от аудита больше других, в каких ситуациях внешняя проверка нужна и когда без неё можно обойтись.
Что не видно изнутри
Нет эталона для сравнения
Администратор, который пять лет работает в одной компании, видел одну инфраструктуру. Он знает её досконально, но не знает, как она выглядит на фоне других компаний того же размера. Что здесь нормально, а что давно отстало от практики рынка, — вопрос, на который изнутри ответить невозможно.
Внешний аудитор приходит после десятков подобных обследований. Он с первого дня видит, что схема резервирования типична для компаний пятилетней давности, а нагрузка на хранилище выше, чем обычно бывает при таком количестве пользователей.
Привыкание к временным решениям
В любой инфраструктуре есть решения, принятые «на время»: сервер, поднятый под срочную задачу, правило в межсетевом экране для подрядчика, скрипт, который запускается вручную раз в неделю. Через год они перестают восприниматься как временные. Через три — как проблема.
Тот, кто их создал, помнит, почему они появились, и не видит в них риска. Внешний взгляд видит просто нестандартное решение без документации и без владельца.
Оценка собственной работы
Человек не может беспристрастно оценить то, что сам построил, — и не обязан. Это не вопрос честности, а вопрос того, как устроено восприятие. Архитектурные решения, которые администратор когда-то принимал с серьёзными основаниями, для него остаются правильными, даже если основания давно исчезли.
Знания без документации
Фраза «админ и так всё знает» сама по себе описывает риск. Если схема сети, пароли от сервисных учётных записей и история решений существуют только в голове одного человека, компания зависит от него полностью. Отпуск, болезнь или увольнение превращают знание в проблему, а при медианном сроке закрытия ИТ-вакансии в 44,5 дня, по данным «Поток Рекрутмент», замена найдётся не скоро.
Изнутри этот риск не ощущается, потому что пока человек на месте, всё работает. Внешний аудит фиксирует его первым.
Непроверенные допущения
Самая опасная категория. Администратор уверен, что резервные копии делаются, — и они действительно делаются. Но восстанавливались ли когда-нибудь? По данным исследования Veeam Data Protection Report 2021, в 58% случаев восстановить данные из резервных копий не удаётся. В российской части исследования Veeam 2022 года в среднем 16% данных компаний оставались вообще без защиты.
С лицензиями то же. Администратор знает, что ПО легальное, но не отслеживает, сколько оплаченного реально используется. Даже зрелые ИТ-команды, по отчёту Flexera State of ITAM 2024, оценивают потери на настольном ПО в 30%, на серверном — в 22%, на облачных сервисах — в 20–21%. Больше половины опрошенных признали, что не имеют полной видимости своих ИТ-активов.
Нет времени на ревизию
Операционка съедает всё. Администратор закрывает заявки, чинит сломавшееся, обновляет, настраивает. Сесть и неделю методично пройтись по собственной инфраструктуре с вопросом «что здесь не так» ему просто некогда — и никто этого времени не выделяет.
Что находит внешний аудит
Почему это не видно изнутри
Резервные копии, из которых нельзя восстановиться
Копии создаются без ошибок, а восстановление никогда не проверялось
Единые точки отказа
Система годами работает без сбоев, и риск не ощущается
Неиспользуемые лицензии и подписки
Администратор отвечает за легальность, а не за утилизацию
Устаревшая архитектура
Нет сравнения с тем, как такие задачи решают сейчас
Забытые серверы и сервисы
Временные решения стали постоянными и выпали из внимания
Зависимость от одного человека
Пока он на месте, всё работает
Читайте также Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Почему администратор выигрывает от аудита больше всех
Самое распространённое опасение — что внешний аудит станет проверкой администратора. На практике выходит наоборот.
Аудит легитимизирует его просьбы
У большинства администраторов есть список того, что нужно обновить, заменить или купить. Они годами просят бюджет на резервную СХД, на замену коммутаторов с истёкшей поддержкой, на нормальную систему мониторинга — и годами получают отказ, потому что руководство не может оценить, насколько это срочно.
Независимый аудитор с конкретными рисками и приоритетами в отчёте делает то, что администратору изнутри сделать почти невозможно: переводит технические просьбы на язык рисков для бизнеса. По нашему опыту, после аудита бюджет на давно назревшие закупки согласуется в разы быстрее.
Аудит снимает единоличную ответственность
Пока администратор единственный, кто знает инфраструктуру, он единственный и отвечает за всё. Документация, составленная в ходе аудита, и зафиксированные риски распределяют эту ответственность: руководство знает о проблемах и само принимает решение, какие из них закрывать.
Как провести, чтобы не превратить в проверку
Администратор должен узнать об аудите не последним, а первым. Цель формулируется как оценка инфраструктуры, а не работы конкретного человека. Администратора включают в проект как главного эксперта: он даёт контекст, объясняет, почему решения принимались именно так, и первым видит выводы. Тогда отчёт становится его аргументом, а не претензией к нему.
«Я сам руковожу внутренней ИТ-командой и хорошо понимаю, как выглядит предложение позвать внешних аудиторов. Первая реакция — оборона. Но лучшие администраторы, с которыми мы работали, после аудита становились его главными сторонниками: наконец появился документ, в котором систематизировано то, о чём они говорили годами. Это сильно помогает в работе.», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Когда внешний аудит нужен
Ситуация
Почему нужен именно внешний взгляд
Перед крупной модернизацией или переездом в облако
Решение на годы вперёд лучше принимать с независимой оценкой вариантов
Регулярные сбои без понятной причины
Своя команда уже проверила очевидное и ничего не нашла
Смена администратора, руководителя ИТ или подрядчика
Новому человеку нужна честная картина того, что он принимает
Руководство не понимает, на что уходит ИТ-бюджет
Нужен независимый голос между ИТ и финансами
Вся инфраструктура держится на одном человеке
Документация, составленная аудитом, снижает зависимость
Слияние, покупка компании, привлечение инвестиций
Оценка ИТ-активов должна быть независимой от сторон сделки
Последний аудит был больше двух лет назад или не проводился вовсе
Инфраструктура изменилась, накопленные решения никто не пересматривал
Когда можно обойтись без внешнего аудита
Внешний аудит нужен не всегда, и честно сказать об этом полезнее, чем продавать проверку каждому.
Небольшая и простая инфраструктура. Десяток рабочих мест, облачные сервисы, один сервер под файлы. Здесь мало что может скрываться, и экспресс-проверки собственными силами по чек-листу обычно достаточно.
Инфраструктура недавно построена с нуля по проекту. Если год назад интегратор спроектировал и развернул всё по документации, и с тех пор ничего существенного не менялось, аудит преждевременен. Картина свежая и описана.
В компании работает зрелая ИТ-функция с внутренним контролем. Есть актуальная документация, регулярная проверка восстановления из резервных копий, учёт активов и лицензий, мониторинг с понятной реакцией. Такой команде внешний аудит нужен реже — скорее раз в два-три года или перед крупными изменениями.
Нет готовности действовать по итогам. Если бюджет на следующий год уже распределён и менять в инфраструктуре ничего не планируется, отчёт ляжет в папку. Разумнее провести аудит тогда, когда по его результатам можно будет принять решения.
Хороший ориентир: если на вопросы «когда последний раз восстанавливали систему из резервной копии», «сколько лицензий мы оплачиваем и сколько используем» и «что будет, если администратор уйдёт завтра» у вас есть точные ответы, внешний аудит, скорее всего, может подождать.
«Внутренний контроль и внешний аудит не конкурируют. Внутренний работает постоянно и ловит текущие проблемы, внешний раз в год-два проверяет то, что изнутри не видно: устаревшие допущения, архитектуру, зависимость от людей. Сильная команда использует внешний аудит как сверку, а не как экзамен», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Внешний ИТ-аудит нужен не потому, что свой администратор плохо знает инфраструктуру. Он нужен потому, что изнутри не видно шести вещей: как инфраструктура выглядит на фоне других компаний, какие временные решения превратились в постоянные риски, насколько объективны собственные архитектурные решения, какие знания существуют только в голове одного человека, какие допущения ни разу не проверялись — от восстановления из резервных копий до реального использования лицензий, — и на что никогда не хватало времени.
Проверка оправдана перед модернизацией, при сбоях без понятной причины, при смене ключевых людей или подрядчика, когда руководство не понимает структуру ИТ-расходов и когда инфраструктура держится на одном человеке. Обойтись без неё можно при простой или недавно построенной инфраструктуре и при зрелой ИТ-функции с внутренним контролем.
Практический первый шаг — ответить на три вопроса: когда последний раз проверялось восстановление из резервных копий, сколько оплаченных лицензий реально используется и что будет с инфраструктурой, если администратор завтра уйдёт. Если хотя бы на один ответа нет, внешний взгляд вам пригодится. И обязательно обсудите аудит с администратором до того, как его заказывать: он должен стать участником проекта, а не его объектом.
Если хотите понять, нужен ли аудит в вашей ситуации и какого объёма, приходите на бесплатную консультацию — разберём задачу и честно скажем, если проверка пока преждевременна.
Часто задаваемые вопросы (FAQ)
-
Зачем нужен внешний аудит, если свой администратор знает инфраструктуру?
Потому что знать инфраструктуру и объективно её оценить — разные задачи. Изнутри не видно, как инфраструктура выглядит на фоне других компаний, какие временные решения стали постоянными рисками, какие допущения ни разу не проверялись и насколько компания зависит от одного человека. Администратор оценивает собственные решения и занят операционкой, поэтому на ревизию у него обычно нет ни времени, ни дистанции.
-
Что внешний аудит находит чаще всего?
Резервные копии, из которых невозможно восстановиться, потому что восстановление никогда не проверялось. Единые точки отказа в критичных системах. Оплаченные и неиспользуемые лицензии. Забытые серверы и сервисы. Устаревшие архитектурные решения. И зависимость от одного человека, у которого в голове хранится вся схема инфраструктуры.
-
Не станет ли аудит проверкой нашего администратора?
Не должен. Цель формулируется как оценка инфраструктуры, а не работы человека. Администратора включают в проект как главного эксперта: он объясняет контекст решений и первым видит выводы. На практике он чаще всего выигрывает от аудита больше других — отчёт переводит его давние просьбы о бюджете на язык рисков для бизнеса.
-
Когда внешний ИТ-аудит действительно нужен?
Перед крупной модернизацией или переездом в облако, при регулярных сбоях без понятной причины, при смене администратора, руководителя ИТ или подрядчика, когда руководство не понимает структуру ИТ-расходов, когда инфраструктура держится на одном человеке, при слиянии или покупке компании и если аудит не проводился больше двух лет.
-
Когда можно обойтись без внешнего аудита?
Если инфраструктура небольшая и простая, если она недавно построена с нуля по проекту и с тех пор существенно не менялась, если в компании работает зрелая ИТ-функция с актуальной документацией, регулярной проверкой восстановления и учётом активов. И если по итогам аудита вы не готовы ничего менять — тогда разумнее отложить его до момента, когда можно будет принять решения.
-
Насколько часто резервные копии оказываются нерабочими?
По данным исследования Veeam Data Protection Report 2021, в 58% случаев восстановить данные из резервных копий не удаётся. Причины — ошибки при копировании, выход за окно резервирования, отсутствие регулярных проверок восстановления. Сам факт того, что копии создаются без ошибок, не гарантирует, что из них можно восстановиться.
-
Сколько денег обычно теряется на неиспользуемых лицензиях?
По отчёту Flexera State of ITAM 2024, даже зрелые ИТ-команды оценивают потери на настольном ПО в 30%, на серверном — в 22%, на облачных платформах и SaaS — в 20–21%. Больше половины опрошенных организаций не имеют полной видимости своих ИТ-активов. Инвентаризация лицензий в ходе аудита часто окупает его сама по себе.
-
Как совмещать внутренний контроль и внешний аудит?
Они не конкурируют, а дополняют друг друга. Внутренний контроль работает постоянно и ловит текущие проблемы: мониторинг, проверка резервных копий, учёт активов. Внешний аудит раз в год-два проверяет то, что изнутри не видно: устаревшие допущения, архитектуру, зависимость от людей. Чем зрелее внутренний контроль, тем реже нужен внешний аудит.
[~DETAIL_TEXT] =>
«Зачем платить за аудит, если наш администратор и так всё знает?» — вопрос справедливый, и задают его обычно не от непонимания. Чаще всего так формулирует собственник или финансовый директор, которому администратор говорит, что в инфраструктуре всё в порядке. А иногда и сам администратор, который воспринимает внешнюю проверку как недоверие к своей работе.
Ответ в том, что знать инфраструктуру и объективно её оценить — разные задачи. Хороший администратор действительно знает, где что стоит и как работает. Но он видит свою инфраструктуру изнутри, без сравнения с другими, с годами накопленного привыкания и без времени на ревизию собственных решений. Внешний аудит нужен не потому, что админ плохой, а потому, что некоторые вещи изнутри не видны в принципе.
Разберём, что именно не видно изнутри, почему администратор выигрывает от аудита больше других, в каких ситуациях внешняя проверка нужна и когда без неё можно обойтись.
Что не видно изнутри
Нет эталона для сравнения
Администратор, который пять лет работает в одной компании, видел одну инфраструктуру. Он знает её досконально, но не знает, как она выглядит на фоне других компаний того же размера. Что здесь нормально, а что давно отстало от практики рынка, — вопрос, на который изнутри ответить невозможно.
Внешний аудитор приходит после десятков подобных обследований. Он с первого дня видит, что схема резервирования типична для компаний пятилетней давности, а нагрузка на хранилище выше, чем обычно бывает при таком количестве пользователей.
Привыкание к временным решениям
В любой инфраструктуре есть решения, принятые «на время»: сервер, поднятый под срочную задачу, правило в межсетевом экране для подрядчика, скрипт, который запускается вручную раз в неделю. Через год они перестают восприниматься как временные. Через три — как проблема.
Тот, кто их создал, помнит, почему они появились, и не видит в них риска. Внешний взгляд видит просто нестандартное решение без документации и без владельца.
Оценка собственной работы
Человек не может беспристрастно оценить то, что сам построил, — и не обязан. Это не вопрос честности, а вопрос того, как устроено восприятие. Архитектурные решения, которые администратор когда-то принимал с серьёзными основаниями, для него остаются правильными, даже если основания давно исчезли.
Знания без документации
Фраза «админ и так всё знает» сама по себе описывает риск. Если схема сети, пароли от сервисных учётных записей и история решений существуют только в голове одного человека, компания зависит от него полностью. Отпуск, болезнь или увольнение превращают знание в проблему, а при медианном сроке закрытия ИТ-вакансии в 44,5 дня, по данным «Поток Рекрутмент», замена найдётся не скоро.
Изнутри этот риск не ощущается, потому что пока человек на месте, всё работает. Внешний аудит фиксирует его первым.
Непроверенные допущения
Самая опасная категория. Администратор уверен, что резервные копии делаются, — и они действительно делаются. Но восстанавливались ли когда-нибудь? По данным исследования Veeam Data Protection Report 2021, в 58% случаев восстановить данные из резервных копий не удаётся. В российской части исследования Veeam 2022 года в среднем 16% данных компаний оставались вообще без защиты.
С лицензиями то же. Администратор знает, что ПО легальное, но не отслеживает, сколько оплаченного реально используется. Даже зрелые ИТ-команды, по отчёту Flexera State of ITAM 2024, оценивают потери на настольном ПО в 30%, на серверном — в 22%, на облачных сервисах — в 20–21%. Больше половины опрошенных признали, что не имеют полной видимости своих ИТ-активов.
Нет времени на ревизию
Операционка съедает всё. Администратор закрывает заявки, чинит сломавшееся, обновляет, настраивает. Сесть и неделю методично пройтись по собственной инфраструктуре с вопросом «что здесь не так» ему просто некогда — и никто этого времени не выделяет.
Что находит внешний аудит
Почему это не видно изнутри
Резервные копии, из которых нельзя восстановиться
Копии создаются без ошибок, а восстановление никогда не проверялось
Единые точки отказа
Система годами работает без сбоев, и риск не ощущается
Неиспользуемые лицензии и подписки
Администратор отвечает за легальность, а не за утилизацию
Устаревшая архитектура
Нет сравнения с тем, как такие задачи решают сейчас
Забытые серверы и сервисы
Временные решения стали постоянными и выпали из внимания
Зависимость от одного человека
Пока он на месте, всё работает
Читайте также Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Почему администратор выигрывает от аудита больше всех
Самое распространённое опасение — что внешний аудит станет проверкой администратора. На практике выходит наоборот.
Аудит легитимизирует его просьбы
У большинства администраторов есть список того, что нужно обновить, заменить или купить. Они годами просят бюджет на резервную СХД, на замену коммутаторов с истёкшей поддержкой, на нормальную систему мониторинга — и годами получают отказ, потому что руководство не может оценить, насколько это срочно.
Независимый аудитор с конкретными рисками и приоритетами в отчёте делает то, что администратору изнутри сделать почти невозможно: переводит технические просьбы на язык рисков для бизнеса. По нашему опыту, после аудита бюджет на давно назревшие закупки согласуется в разы быстрее.
Аудит снимает единоличную ответственность
Пока администратор единственный, кто знает инфраструктуру, он единственный и отвечает за всё. Документация, составленная в ходе аудита, и зафиксированные риски распределяют эту ответственность: руководство знает о проблемах и само принимает решение, какие из них закрывать.
Как провести, чтобы не превратить в проверку
Администратор должен узнать об аудите не последним, а первым. Цель формулируется как оценка инфраструктуры, а не работы конкретного человека. Администратора включают в проект как главного эксперта: он даёт контекст, объясняет, почему решения принимались именно так, и первым видит выводы. Тогда отчёт становится его аргументом, а не претензией к нему.
«Я сам руковожу внутренней ИТ-командой и хорошо понимаю, как выглядит предложение позвать внешних аудиторов. Первая реакция — оборона. Но лучшие администраторы, с которыми мы работали, после аудита становились его главными сторонниками: наконец появился документ, в котором систематизировано то, о чём они говорили годами. Это сильно помогает в работе.», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Когда внешний аудит нужен
Ситуация
Почему нужен именно внешний взгляд
Перед крупной модернизацией или переездом в облако
Решение на годы вперёд лучше принимать с независимой оценкой вариантов
Регулярные сбои без понятной причины
Своя команда уже проверила очевидное и ничего не нашла
Смена администратора, руководителя ИТ или подрядчика
Новому человеку нужна честная картина того, что он принимает
Руководство не понимает, на что уходит ИТ-бюджет
Нужен независимый голос между ИТ и финансами
Вся инфраструктура держится на одном человеке
Документация, составленная аудитом, снижает зависимость
Слияние, покупка компании, привлечение инвестиций
Оценка ИТ-активов должна быть независимой от сторон сделки
Последний аудит был больше двух лет назад или не проводился вовсе
Инфраструктура изменилась, накопленные решения никто не пересматривал
Когда можно обойтись без внешнего аудита
Внешний аудит нужен не всегда, и честно сказать об этом полезнее, чем продавать проверку каждому.
Небольшая и простая инфраструктура. Десяток рабочих мест, облачные сервисы, один сервер под файлы. Здесь мало что может скрываться, и экспресс-проверки собственными силами по чек-листу обычно достаточно.
Инфраструктура недавно построена с нуля по проекту. Если год назад интегратор спроектировал и развернул всё по документации, и с тех пор ничего существенного не менялось, аудит преждевременен. Картина свежая и описана.
В компании работает зрелая ИТ-функция с внутренним контролем. Есть актуальная документация, регулярная проверка восстановления из резервных копий, учёт активов и лицензий, мониторинг с понятной реакцией. Такой команде внешний аудит нужен реже — скорее раз в два-три года или перед крупными изменениями.
Нет готовности действовать по итогам. Если бюджет на следующий год уже распределён и менять в инфраструктуре ничего не планируется, отчёт ляжет в папку. Разумнее провести аудит тогда, когда по его результатам можно будет принять решения.
Хороший ориентир: если на вопросы «когда последний раз восстанавливали систему из резервной копии», «сколько лицензий мы оплачиваем и сколько используем» и «что будет, если администратор уйдёт завтра» у вас есть точные ответы, внешний аудит, скорее всего, может подождать.
«Внутренний контроль и внешний аудит не конкурируют. Внутренний работает постоянно и ловит текущие проблемы, внешний раз в год-два проверяет то, что изнутри не видно: устаревшие допущения, архитектуру, зависимость от людей. Сильная команда использует внешний аудит как сверку, а не как экзамен», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
С чего начать
Внешний ИТ-аудит нужен не потому, что свой администратор плохо знает инфраструктуру. Он нужен потому, что изнутри не видно шести вещей: как инфраструктура выглядит на фоне других компаний, какие временные решения превратились в постоянные риски, насколько объективны собственные архитектурные решения, какие знания существуют только в голове одного человека, какие допущения ни разу не проверялись — от восстановления из резервных копий до реального использования лицензий, — и на что никогда не хватало времени.
Проверка оправдана перед модернизацией, при сбоях без понятной причины, при смене ключевых людей или подрядчика, когда руководство не понимает структуру ИТ-расходов и когда инфраструктура держится на одном человеке. Обойтись без неё можно при простой или недавно построенной инфраструктуре и при зрелой ИТ-функции с внутренним контролем.
Практический первый шаг — ответить на три вопроса: когда последний раз проверялось восстановление из резервных копий, сколько оплаченных лицензий реально используется и что будет с инфраструктурой, если администратор завтра уйдёт. Если хотя бы на один ответа нет, внешний взгляд вам пригодится. И обязательно обсудите аудит с администратором до того, как его заказывать: он должен стать участником проекта, а не его объектом.
Если хотите понять, нужен ли аудит в вашей ситуации и какого объёма, приходите на бесплатную консультацию — разберём задачу и честно скажем, если проверка пока преждевременна.
Часто задаваемые вопросы (FAQ)
-
Зачем нужен внешний аудит, если свой администратор знает инфраструктуру?
Потому что знать инфраструктуру и объективно её оценить — разные задачи. Изнутри не видно, как инфраструктура выглядит на фоне других компаний, какие временные решения стали постоянными рисками, какие допущения ни разу не проверялись и насколько компания зависит от одного человека. Администратор оценивает собственные решения и занят операционкой, поэтому на ревизию у него обычно нет ни времени, ни дистанции.
-
Что внешний аудит находит чаще всего?
Резервные копии, из которых невозможно восстановиться, потому что восстановление никогда не проверялось. Единые точки отказа в критичных системах. Оплаченные и неиспользуемые лицензии. Забытые серверы и сервисы. Устаревшие архитектурные решения. И зависимость от одного человека, у которого в голове хранится вся схема инфраструктуры.
-
Не станет ли аудит проверкой нашего администратора?
Не должен. Цель формулируется как оценка инфраструктуры, а не работы человека. Администратора включают в проект как главного эксперта: он объясняет контекст решений и первым видит выводы. На практике он чаще всего выигрывает от аудита больше других — отчёт переводит его давние просьбы о бюджете на язык рисков для бизнеса.
-
Когда внешний ИТ-аудит действительно нужен?
Перед крупной модернизацией или переездом в облако, при регулярных сбоях без понятной причины, при смене администратора, руководителя ИТ или подрядчика, когда руководство не понимает структуру ИТ-расходов, когда инфраструктура держится на одном человеке, при слиянии или покупке компании и если аудит не проводился больше двух лет.
-
Когда можно обойтись без внешнего аудита?
Если инфраструктура небольшая и простая, если она недавно построена с нуля по проекту и с тех пор существенно не менялась, если в компании работает зрелая ИТ-функция с актуальной документацией, регулярной проверкой восстановления и учётом активов. И если по итогам аудита вы не готовы ничего менять — тогда разумнее отложить его до момента, когда можно будет принять решения.
-
Насколько часто резервные копии оказываются нерабочими?
По данным исследования Veeam Data Protection Report 2021, в 58% случаев восстановить данные из резервных копий не удаётся. Причины — ошибки при копировании, выход за окно резервирования, отсутствие регулярных проверок восстановления. Сам факт того, что копии создаются без ошибок, не гарантирует, что из них можно восстановиться.
-
Сколько денег обычно теряется на неиспользуемых лицензиях?
По отчёту Flexera State of ITAM 2024, даже зрелые ИТ-команды оценивают потери на настольном ПО в 30%, на серверном — в 22%, на облачных платформах и SaaS — в 20–21%. Больше половины опрошенных организаций не имеют полной видимости своих ИТ-активов. Инвентаризация лицензий в ходе аудита часто окупает его сама по себе.
-
Как совмещать внутренний контроль и внешний аудит?
Они не конкурируют, а дополняют друг друга. Внутренний контроль работает постоянно и ловит текущие проблемы: мониторинг, проверка резервных копий, учёт активов. Внешний аудит раз в год-два проверяет то, что изнутри не видно: устаревшие допущения, архитектуру, зависимость от людей. Чем зрелее внутренний контроль, тем реже нужен внешний аудит.
[DETAIL_TEXT_TYPE] => html
[~DETAIL_TEXT_TYPE] => html
[PREVIEW_TEXT] => «Зачем платить за аудит, если наш администратор и так всё знает?» — вопрос справедливый, и задают его обычно не от непонимания. Чаще всего так формулирует собственник или финансовый директор, которому администратор говорит, что в инфраструктуре всё в порядке. А иногда и сам администратор, который воспринимает внешнюю проверку как недоверие к своей работе.
[~PREVIEW_TEXT] => «Зачем платить за аудит, если наш администратор и так всё знает?» — вопрос справедливый, и задают его обычно не от непонимания. Чаще всего так формулирует собственник или финансовый директор, которому администратор говорит, что в инфраструктуре всё в порядке. А иногда и сам администратор, который воспринимает внешнюю проверку как недоверие к своей работе.
[PREVIEW_TEXT_TYPE] => text
[~PREVIEW_TEXT_TYPE] => text
[PREVIEW_PICTURE] =>
[~PREVIEW_PICTURE] =>
[LANG_DIR] => /
[~LANG_DIR] => /
[CODE] => vneshniy-it-audit-chego-ne-vidno-iznutri-i-v-kakikh-sluchayakh-nuzhna-proverka
[~CODE] => vneshniy-it-audit-chego-ne-vidno-iznutri-i-v-kakikh-sluchayakh-nuzhna-proverka
[EXTERNAL_ID] => 3566
[~EXTERNAL_ID] => 3566
[IBLOCK_TYPE_ID] => content
[~IBLOCK_TYPE_ID] => content
[IBLOCK_CODE] =>
[~IBLOCK_CODE] =>
[IBLOCK_EXTERNAL_ID] =>
[~IBLOCK_EXTERNAL_ID] =>
[LID] => s1
[~LID] => s1
[EDIT_LINK] =>
[DELETE_LINK] =>
[DISPLAY_ACTIVE_FROM] => 22.09.2026
[FIELDS] => Array
(
)
[DISPLAY_PROPERTIES] => Array
(
)
[IPROPERTY_VALUES] => Array
(
[ELEMENT_META_TITLE] => Внешний ИТ-аудит: чего не видно изнутри и в каких случаях нужна проверка
[ELEMENT_META_DESCRIPTION] => Зачем нужен внешний ИТ-аудит, если свой администратор знает инфраструктуру: что не видно изнутри, когда проверка нужна, а когда без неё можно обойтись.
)
)
1
Читать
ИТ-аутсорсинг
15.09.2026
Полная стоимость владения штатным ИТ-отделом: чего не видно в ФОТ
Array
(
[ID] => 3553
[~ID] => 3553
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 101
[~IBLOCK_SECTION_ID] => 101
[NAME] => Полная стоимость владения штатным ИТ-отделом: чего не видно в ФОТ
[~NAME] => Полная стоимость владения штатным ИТ-отделом: чего не видно в ФОТ
[ACTIVE_FROM_X] => 2026-09-15 00:00:00
[~ACTIVE_FROM_X] => 2026-09-15 00:00:00
[ACTIVE_FROM] => 15.09.2026
[~ACTIVE_FROM] => 15.09.2026
[TIMESTAMP_X] => 15.09.2026 14:22:23
[~TIMESTAMP_X] => 15.09.2026 14:22:23
[DETAIL_PAGE_URL] => /blog/it-autsorsing/polnaya-stoimost-vladeniya-shtatnym-it-otdelom-chego-ne-vidno-v-fot/
[~DETAIL_PAGE_URL] => /blog/it-autsorsing/polnaya-stoimost-vladeniya-shtatnym-it-otdelom-chego-ne-vidno-v-fot/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] => Когда финансовый директор спрашивает, во сколько компании обходится ИТ-отдел, обычно называют фонд оплаты труда. Иногда добавляют страховые взносы. На этом расчёт заканчивается, и дальше с этой цифрой сравнивают предложения подрядчиков, считают бюджет на следующий год и решают, можно ли позволить себе ещё одного инженера.
Проблема в том, что эта цифра занижена примерно вдвое. Остальные расходы живут в бюджетах HR, АХО и финансового блока, и ни один из них не подписан словом «ИТ». В результате компания принимает решения по числу, которое не отражает реальность.
Разберём полную структуру затрат на штатный ИТ-отдел, посчитаем конкретный пример и выведем коэффициент, на который стоит умножать оклады, чтобы получить честную цифру. Материал пригодится тем, кто готовит ИТ-бюджет или обосновывает его перед руководством.
Что входит в полную стоимость
Полная стоимость владения ИТ-отделом считается по простой формуле: прямые расходы на персонал плюс сопутствующие расходы на его содержание плюс потери от того, что люди не работают непрерывно.
Первую группу видит любой бухгалтер. Вторая размазана по другим статьям бюджета. Третья не отражается в учёте вообще, хотя стоит дороже первых двух в отдельные годы.
Прямые расходы: то, что видно
Оклады и реальный уровень рынка
Здесь компании чаще всего ошибаются в меньшую сторону, ориентируясь на зарплаты, которые платят сейчас, а не на те, за которые придётся нанимать замену.
По данным зарплатного исследования Хабр Карьеры за первое полугодие 2026 года, построенного на 45 226 зарплатах, медианный доход ИТ-специалиста в России составил 191 000 рублей: 235 000 в Москве, 200 000 в Санкт-Петербурге и 160 000 в остальных регионах. Для сравнения, по данным Росстата средняя зарплата по стране за тот же период — около 107 000 рублей.
Важная деталь: медиана по вакансиям и медиана по фактическим выплатам расходятся сильно. У hh.ru медианная зарплата в активных вакансиях системного администратора за 2025 год — 82 601 рубль, и эта цифра ниже реальных выплат по рынку, потому что в вакансиях указывают нижнюю границу вилки. Планируя бюджет по объявлениям конкурентов, вы закладываете сумму, на которую специалист нужной квалификации не придёт.
Рост при этом замедлился: те же 4% за полугодие при прогнозе инфляции ЦБ в 4,5–5,5%. Эпоха ежегодного пересмотра окладов на 20% закончилась, но индексацию в расчёт закладывать всё равно нужно.
Страховые взносы
С 2026 года большинство компаний платят 30% с выплат в пределах предельной базы 2 979 000 рублей на человека в год и 15,1% с суммы сверх неё. Льготный тариф 15%, которым раньше пользовалось подавляющее большинство малого и среднего бизнеса, с января 2026 года сохранился только для компаний из правительственного перечня приоритетных отраслей.
Для ИТ-бюджета это означает простую вещь: специалист подорожал примерно на 15% без всякого повышения оклада. Если бюджет на 2026 год верстался по прошлогодней логике, в нём дыра.
Скрытые расходы: то, что не попадает в ИТ-бюджет
Фактическое рабочее время
В году около 1970 рабочих часов. Из них 28 календарных дней уходит на отпуск, ещё несколько дней на больничные, плюс обучение, плюс государственные праздники, которые уже учтены в производственном календаре. Реально сотрудник доступен примерно 1750–1800 часов.
Это значит, что стоимость часа работы штатного специалиста примерно на 10–12% выше, чем получается при делении годового оклада на календарные рабочие часы. А если администратор в отделе один, эти дни инфраструктура живёт вообще без присмотра — и здесь начинается второй, скрытый счёт.
Подбор и замена
Самая недооценённая статья. По оценке SHRM, закрытие вакансии обходится в 50–60% годового дохода специалиста, а в ИТ из-за дефицита кадров стоимость замены может превысить его годовую зарплату.
Складывается она из доступа к базам резюме и размещения вакансий — минимальный бюджет на работные сайты для ИТ-подбора начинается от 45 000 рублей в месяц, — работы рекрутера, комиссии агентства при внешнем подборе, времени руководителя на собеседования и потерь от того, что позиция стоит открытой. А стоит она долго: по данным «Поток Рекрутмент», проанализировавшего 1762 ИТ-вакансии, медианный срок закрытия составляет 44,5 дня. На рынке, где Минтруд оценивает дефицит ИТ-специалистов в 740 тысяч — миллион человек, эти сроки не сокращаются.
Адаптация
Новый сотрудник выходит на полную производительность не сразу. В первые один-три месяца его продуктивность оценивают в 0–50% от нормальной, дальше она растёт до 50–70%. Всё это время компания платит полный оклад.
Параллельно новичка кто-то вводит в курс дела, и это время опытных инженеров, которые в эти часы не делают свою работу. В ИТ период адаптации длиннее среднего: чтобы разобраться в незадокументированной инфраструктуре, требуется от двух до четырёх месяцев.
Обучение и сертификация
Инженер, который годами обслуживает одну и ту же инфраструктуру, теряет квалификацию — просто потому, что не сталкивается с новыми задачами. Курсы, вендорские сертификации, конференции стоят от 50 до 150 тысяч рублей на человека в год, плюс рабочее время на само обучение.
Парадокс этой статьи в том, что экономия на ней ощущается не сразу. Первые год-два всё работает, а потом выясняется, что команда не может самостоятельно спроектировать переход на новую платформу, и приходится звать интеграторов на то, что могло быть внутренней задачей.
Рабочее место и социальный пакет
ДМС в 2026 году стоит от 15 000 до 120 000 рублей на сотрудника в год, и цены выросли на 7–15% за год — из-за медицинской инфляции в 12–15% и повышения НДС с 20 до 22% с января. Рабочее место в офисе обходится по-разному: фиксированное место в коворкинге в Петербурге стоит 14 000–18 000 рублей в месяц, в московских бизнес-центрах со всеми сервисами — 35 000–55 000.
Сюда же — техника, её обновление раз в три-четыре года, мобильная связь, корпоративные мероприятия. По отдельности мелочи, в сумме — сопоставимо с месячным окладом в год на человека.
Инструменты и лицензии
Собственный ИТ-отдел нуждается в собственном инструментарии: система мониторинга, helpdesk, инвентаризация активов, средства удалённого доступа, резервное копирование. Для небольшой команды это 150–250 тысяч рублей в год.
Подрядчик приходит со своим стеком, и эта статья в его счёте уже сидит. При сравнении вариантов её часто забывают добавить на сторону штата.
Читайте также
Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Переработки и дежурства
Аварии происходят ночью и в выходные. По Трудовому кодексу сверхурочная работа оплачивается в полуторном размере за первые два часа и в двойном за последующие, работа в выходной — в двойном размере. Если покрытие нужно шире, чем 8×5, это отдельная строка бюджета, и она редко закладывается заранее.
Альтернативный сценарий — люди работают в авральном режиме бесплатно, выгорают и увольняются. Тогда расходы просто переезжают в статью «подбор и замена».
Риск концентрации знаний
Единственный человек, который знает, как устроена сеть, — это не статья расходов, а отложенный риск. Пароли в его заметках, схема в его голове, договорённости с провайдером на его почте. Оценить эту величину можно через стоимость простоя: по данным BI.Zone за апрель 2026 года, час простоя после успешной кибератаки обходится ритейлу в 9,6 млн рублей, а компаниям из сферы профессиональных услуг — около 680 тысяч.
Расчёт на примере
Возьмём отдел из четырёх человек в компании среднего размера: руководитель ИТ, два инженера, один специалист первой линии. Покрытие — рабочие часы, пять дней в неделю.
Статья
Как считали
В год
Оклады
190 000 + 140 000 + 130 000 + 85 000 = 545 000 ₽/мес
6 540 000 ₽
Страховые взносы
30% в пределах предельной базы
1 962 000 ₽
Рабочие места и техника
200 000 ₽ на человека с учётом амортизации
800 000 ₽
Замена одного сотрудника
50% годового дохода инженера, одна замена в год
800 000 ₽
Обучение и сертификация
60 000 ₽ на человека
240 000 ₽
Инструменты и лицензии
Мониторинг, helpdesk, удалённый доступ
200 000 ₽
ДМС
40 000 ₽ на человека
160 000 ₽
Итого
Против 6 540 000 ₽, которые видны в ФОТ
10 702 000 ₽
Коэффициент к ФОТ
В этом расчёте полная стоимость превышает фонд оплаты труда в 1,64 раза. По нашему опыту работы с ИТ-бюджетами заказчиков рабочий диапазон — от 1,6 до 2,0 в зависимости от текучести, региона и того, нужно ли покрытие вне рабочих часов. Нижняя граница достигается при стабильной команде и скромном соцпакете, верхняя — там, где люди меняются часто и есть дежурства.
Практическое следствие: если руководитель называет цифру ФОТ, умножайте её минимум на 1,6, прежде чем сравнивать с чем бы то ни было. И помните, что расчёт выше описывает покрытие 8×5 и команду без узких специалистов — инженера по информационной безопасности или человека по виртуализации в этих 10,7 млн рублей нет.
«На аудитах мы почти всегда видим одну картину: в ИТ-бюджете лежит только ФОТ и лицензии, а подбор, ДМС, рабочие места и обучение живут в других статьях. Собрать их вместе — работа на один день, но именно после неё разговор о развитии ИТ начинает вестись в реальных цифрах, а не в тех, которые удобно показывать», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как посчитать у себя
Порядок действий, который занимает примерно день работы:
- выгрузить ФОТ ИТ-подразделения за прошлый год с премиями и надбавками;
- добавить страховые взносы по фактической ставке, проверив, применяется ли к вам льготный тариф в 2026 году;
- запросить у HR стоимость закрытия вакансий в ИТ за два-три года и количество замен за этот период;
- запросить у АХО стоимость рабочего места: аренда, техника, связь, обслуживание;
- собрать расходы на ДМС и остальной соцпакет по ИТ-сотрудникам;
- выписать все лицензии на инструменты, которыми пользуется только ИТ-отдел;
- посчитать переработки и дежурства за год в деньгах или в отгулах;
- отдельно зафиксировать, сколько задач за год пришлось отдать подрядчикам из-за нехватки компетенций внутри.
Последний пункт обычно и оказывается самым показательным: он показывает границу, до которой ваш отдел справляется, и стоимость всего, что за этой границей.
«Полезное упражнение — посчитать не только деньги, но и часы. Сколько времени за год ИТ-руководитель потратил на собеседования, ввод новых людей и разбор аварий вне графика. Обычно выясняется, что на развитие инфраструктуры у него остаётся четверть рабочего времени, и вот это чаще становится поводом что-то менять, чем сама сумма в таблице», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Что делать с этой цифрой
Подытоживая можно сказать, что полная стоимость штатного ИТ-отдела складывается из шести групп затрат: оклады, страховые взносы, содержание рабочих мест и соцпакет, подбор и адаптация, обучение, инструменты. К ним добавляются переработки и риск концентрации знаний. В сумме это в 1,6–2,0 раза больше фонда оплаты труда, на который обычно смотрят.
Сама по себе высокая цифра не означает, что отдел нужно сокращать. Она означает, что сравнение с альтернативами наконец стало корректным. Дальше возможны три сценария. Оставить всё как есть, если ИТ — часть вашего продукта и компетенции критичны. Передать эксплуатацию внешнему подрядчику целиком, если ИТ обслуживает офисные процессы. Или перейти на гибридную модель, где внутри остаются ИТ-директор и архитектура, а поддержка пользователей, администрирование серверов и сетей, мониторинг и дежурства уходят на ИТ-аутсорсинг.
Третий вариант в среднем и крупном бизнесе встречается чаще других, потому что снимает две самые дорогие статьи расчёта — подбор с адаптацией и переработки — и при этом не лишает компанию контроля над развитием инфраструктуры.
Если после подсчётов цифра оказалась выше ожидаемой, приходите на бесплатную консультацию: разберём структуру ваших затрат, посчитаем стоимость обслуживания под вашу инфраструктуру и честно скажем, в какой части штат выгоднее оставить.
Часто задаваемые вопросы (FAQ)
-
Как посчитать полную стоимость штатного ИТ-отдела?Сложить шесть групп затрат: фонд оплаты труда, страховые взносы, содержание рабочих мест и соцпакет, подбор с адаптацией, обучение и лицензии на инструменты ИТ-отдела. Отдельно учесть переработки и дежурства. Данные придётся собирать из трёх бюджетов — ИТ, HR и АХО, — потому что в ИТ-бюджете обычно лежит только ФОТ и лицензии.
-
Во сколько раз полная стоимость выше ФОТ?Рабочий диапазон — от 1,6 до 2,0. Нижняя граница характерна для стабильных команд со скромным соцпакетом и покрытием в рабочие часы. Верхняя — там, где высокая текучесть, дежурства вне графика и расширенный социальный пакет. В расчёте на отдел из четырёх человек с окладами 545 000 рублей в месяц полная стоимость составила 10,7 млн рублей в год против 6,5 млн по ФОТ.
-
Какая ставка страховых взносов действует в 2026 году?Для большинства компаний — 30% с выплат в пределах предельной базы 2 979 000 рублей на сотрудника в год и 15,1% с суммы сверх неё. Льготный тариф 15%, доступный ранее почти всему малому и среднему бизнесу, с января 2026 года сохранён только для компаний из правительственного перечня приоритетных отраслей. Проверить свою ставку стоит до планирования бюджета.
-
Сколько стоит замена ИТ-специалиста?По оценке SHRM, закрытие вакансии обходится в 50–60% годового дохода специалиста, а в ИТ из-за дефицита кадров может превысить его годовую зарплату. В сумму входят доступ к базам резюме и размещение вакансий, работа рекрутера или комиссия агентства, время руководителя на собеседования, потери от открытой позиции и период адаптации, в течение которого продуктивность составляет 0–50% от нормальной.
-
Сколько времени занимает закрытие ИТ-вакансии?По данным «Поток Рекрутмент», проанализировавшего 1762 ИТ-вакансии, медианный срок закрытия составляет 44,5 дня. На практике к этому добавляется период адаптации: чтобы разобраться в незадокументированной инфраструктуре, специалисту требуется от двух до четырёх месяцев. То есть от увольнения до полноценной замены проходит около полугода.
-
Какие расходы чаще всего забывают учесть?Подбор и адаптацию, потому что они лежат в бюджете HR. Стоимость рабочего места и ДМС — они в АХО и в соцпакете. Лицензии на инструменты самого ИТ-отдела: мониторинг, helpdesk, учёт активов. Переработки и дежурства, если они компенсируются отгулами, а не деньгами. И задачи, которые за год пришлось отдать подрядчикам из-за нехватки компетенций внутри команды.
-
Значит ли высокая цифра, что штат нужно сокращать?Нет. Она означает, что сравнение с альтернативами стало корректным. Если ИТ — часть продукта компании, а компетенции критичны, штат оправдан при любой стоимости. Вопрос обычно решается не в пользу одного из вариантов, а в пользу гибридной модели: управление и архитектура остаются внутри, эксплуатация уходит подрядчику.
-
Как сравнивать полную стоимость штата с предложением подрядчика?По сопоставимому объёму услуг, а не по сумме. Нужно выровнять режим поддержки: договор на 12×7 нельзя сравнивать со штатом, работающим 8×5. Нужно учесть, что подрядчик приходит со своим инструментарием и своими узкими специалистами. И нужно отдельно посчитать задачи, которые останутся внутри компании в любом сценарии — они из сравнения исключаются.
Когда финансовый директор спрашивает, во сколько компании обходится ИТ-отдел, обычно называют фонд оплаты труда. Иногда добавляют страховые взносы. На этом расчёт заканчивается, и дальше с этой цифрой сравнивают предложения подрядчиков, считают бюджет на следующий год и решают, можно ли позволить себе ещё одного инженера.
Проблема в том, что эта цифра занижена примерно вдвое. Остальные расходы живут в бюджетах HR, АХО и финансового блока, и ни один из них не подписан словом «ИТ». В результате компания принимает решения по числу, которое не отражает реальность.
Разберём полную структуру затрат на штатный ИТ-отдел, посчитаем конкретный пример и выведем коэффициент, на который стоит умножать оклады, чтобы получить честную цифру. Материал пригодится тем, кто готовит ИТ-бюджет или обосновывает его перед руководством.
Что входит в полную стоимость
Полная стоимость владения ИТ-отделом считается по простой формуле: прямые расходы на персонал плюс сопутствующие расходы на его содержание плюс потери от того, что люди не работают непрерывно.
Первую группу видит любой бухгалтер. Вторая размазана по другим статьям бюджета. Третья не отражается в учёте вообще, хотя стоит дороже первых двух в отдельные годы.
Прямые расходы: то, что видно
Оклады и реальный уровень рынка
Здесь компании чаще всего ошибаются в меньшую сторону, ориентируясь на зарплаты, которые платят сейчас, а не на те, за которые придётся нанимать замену.
По данным зарплатного исследования Хабр Карьеры за первое полугодие 2026 года, построенного на 45 226 зарплатах, медианный доход ИТ-специалиста в России составил 191 000 рублей: 235 000 в Москве, 200 000 в Санкт-Петербурге и 160 000 в остальных регионах. Для сравнения, по данным Росстата средняя зарплата по стране за тот же период — около 107 000 рублей.
Важная деталь: медиана по вакансиям и медиана по фактическим выплатам расходятся сильно. У hh.ru медианная зарплата в активных вакансиях системного администратора за 2025 год — 82 601 рубль, и эта цифра ниже реальных выплат по рынку, потому что в вакансиях указывают нижнюю границу вилки. Планируя бюджет по объявлениям конкурентов, вы закладываете сумму, на которую специалист нужной квалификации не придёт.
Рост при этом замедлился: те же 4% за полугодие при прогнозе инфляции ЦБ в 4,5–5,5%. Эпоха ежегодного пересмотра окладов на 20% закончилась, но индексацию в расчёт закладывать всё равно нужно.
Страховые взносы
С 2026 года большинство компаний платят 30% с выплат в пределах предельной базы 2 979 000 рублей на человека в год и 15,1% с суммы сверх неё. Льготный тариф 15%, которым раньше пользовалось подавляющее большинство малого и среднего бизнеса, с января 2026 года сохранился только для компаний из правительственного перечня приоритетных отраслей.
Для ИТ-бюджета это означает простую вещь: специалист подорожал примерно на 15% без всякого повышения оклада. Если бюджет на 2026 год верстался по прошлогодней логике, в нём дыра.
Скрытые расходы: то, что не попадает в ИТ-бюджет
Фактическое рабочее время
В году около 1970 рабочих часов. Из них 28 календарных дней уходит на отпуск, ещё несколько дней на больничные, плюс обучение, плюс государственные праздники, которые уже учтены в производственном календаре. Реально сотрудник доступен примерно 1750–1800 часов.
Это значит, что стоимость часа работы штатного специалиста примерно на 10–12% выше, чем получается при делении годового оклада на календарные рабочие часы. А если администратор в отделе один, эти дни инфраструктура живёт вообще без присмотра — и здесь начинается второй, скрытый счёт.
Подбор и замена
Самая недооценённая статья. По оценке SHRM, закрытие вакансии обходится в 50–60% годового дохода специалиста, а в ИТ из-за дефицита кадров стоимость замены может превысить его годовую зарплату.
Складывается она из доступа к базам резюме и размещения вакансий — минимальный бюджет на работные сайты для ИТ-подбора начинается от 45 000 рублей в месяц, — работы рекрутера, комиссии агентства при внешнем подборе, времени руководителя на собеседования и потерь от того, что позиция стоит открытой. А стоит она долго: по данным «Поток Рекрутмент», проанализировавшего 1762 ИТ-вакансии, медианный срок закрытия составляет 44,5 дня. На рынке, где Минтруд оценивает дефицит ИТ-специалистов в 740 тысяч — миллион человек, эти сроки не сокращаются.
Адаптация
Новый сотрудник выходит на полную производительность не сразу. В первые один-три месяца его продуктивность оценивают в 0–50% от нормальной, дальше она растёт до 50–70%. Всё это время компания платит полный оклад.
Параллельно новичка кто-то вводит в курс дела, и это время опытных инженеров, которые в эти часы не делают свою работу. В ИТ период адаптации длиннее среднего: чтобы разобраться в незадокументированной инфраструктуре, требуется от двух до четырёх месяцев.
Обучение и сертификация
Инженер, который годами обслуживает одну и ту же инфраструктуру, теряет квалификацию — просто потому, что не сталкивается с новыми задачами. Курсы, вендорские сертификации, конференции стоят от 50 до 150 тысяч рублей на человека в год, плюс рабочее время на само обучение.
Парадокс этой статьи в том, что экономия на ней ощущается не сразу. Первые год-два всё работает, а потом выясняется, что команда не может самостоятельно спроектировать переход на новую платформу, и приходится звать интеграторов на то, что могло быть внутренней задачей.
Рабочее место и социальный пакет
ДМС в 2026 году стоит от 15 000 до 120 000 рублей на сотрудника в год, и цены выросли на 7–15% за год — из-за медицинской инфляции в 12–15% и повышения НДС с 20 до 22% с января. Рабочее место в офисе обходится по-разному: фиксированное место в коворкинге в Петербурге стоит 14 000–18 000 рублей в месяц, в московских бизнес-центрах со всеми сервисами — 35 000–55 000.
Сюда же — техника, её обновление раз в три-четыре года, мобильная связь, корпоративные мероприятия. По отдельности мелочи, в сумме — сопоставимо с месячным окладом в год на человека.
Инструменты и лицензии
Собственный ИТ-отдел нуждается в собственном инструментарии: система мониторинга, helpdesk, инвентаризация активов, средства удалённого доступа, резервное копирование. Для небольшой команды это 150–250 тысяч рублей в год.
Подрядчик приходит со своим стеком, и эта статья в его счёте уже сидит. При сравнении вариантов её часто забывают добавить на сторону штата.
Читайте также
Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Переработки и дежурства
Аварии происходят ночью и в выходные. По Трудовому кодексу сверхурочная работа оплачивается в полуторном размере за первые два часа и в двойном за последующие, работа в выходной — в двойном размере. Если покрытие нужно шире, чем 8×5, это отдельная строка бюджета, и она редко закладывается заранее.
Альтернативный сценарий — люди работают в авральном режиме бесплатно, выгорают и увольняются. Тогда расходы просто переезжают в статью «подбор и замена».
Риск концентрации знаний
Единственный человек, который знает, как устроена сеть, — это не статья расходов, а отложенный риск. Пароли в его заметках, схема в его голове, договорённости с провайдером на его почте. Оценить эту величину можно через стоимость простоя: по данным BI.Zone за апрель 2026 года, час простоя после успешной кибератаки обходится ритейлу в 9,6 млн рублей, а компаниям из сферы профессиональных услуг — около 680 тысяч.
Расчёт на примере
Возьмём отдел из четырёх человек в компании среднего размера: руководитель ИТ, два инженера, один специалист первой линии. Покрытие — рабочие часы, пять дней в неделю.
|
Статья |
Как считали |
В год |
|
Оклады |
190 000 + 140 000 + 130 000 + 85 000 = 545 000 ₽/мес |
6 540 000 ₽ |
|
Страховые взносы |
30% в пределах предельной базы |
1 962 000 ₽ |
|
Рабочие места и техника |
200 000 ₽ на человека с учётом амортизации |
800 000 ₽ |
|
Замена одного сотрудника |
50% годового дохода инженера, одна замена в год |
800 000 ₽ |
|
Обучение и сертификация |
60 000 ₽ на человека |
240 000 ₽ |
|
Инструменты и лицензии |
Мониторинг, helpdesk, удалённый доступ |
200 000 ₽ |
|
ДМС |
40 000 ₽ на человека |
160 000 ₽ |
|
Итого |
Против 6 540 000 ₽, которые видны в ФОТ |
10 702 000 ₽ |
Коэффициент к ФОТ
В этом расчёте полная стоимость превышает фонд оплаты труда в 1,64 раза. По нашему опыту работы с ИТ-бюджетами заказчиков рабочий диапазон — от 1,6 до 2,0 в зависимости от текучести, региона и того, нужно ли покрытие вне рабочих часов. Нижняя граница достигается при стабильной команде и скромном соцпакете, верхняя — там, где люди меняются часто и есть дежурства.
Практическое следствие: если руководитель называет цифру ФОТ, умножайте её минимум на 1,6, прежде чем сравнивать с чем бы то ни было. И помните, что расчёт выше описывает покрытие 8×5 и команду без узких специалистов — инженера по информационной безопасности или человека по виртуализации в этих 10,7 млн рублей нет.
«На аудитах мы почти всегда видим одну картину: в ИТ-бюджете лежит только ФОТ и лицензии, а подбор, ДМС, рабочие места и обучение живут в других статьях. Собрать их вместе — работа на один день, но именно после неё разговор о развитии ИТ начинает вестись в реальных цифрах, а не в тех, которые удобно показывать», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Как посчитать у себя
Порядок действий, который занимает примерно день работы:
- выгрузить ФОТ ИТ-подразделения за прошлый год с премиями и надбавками;
- добавить страховые взносы по фактической ставке, проверив, применяется ли к вам льготный тариф в 2026 году;
- запросить у HR стоимость закрытия вакансий в ИТ за два-три года и количество замен за этот период;
- запросить у АХО стоимость рабочего места: аренда, техника, связь, обслуживание;
- собрать расходы на ДМС и остальной соцпакет по ИТ-сотрудникам;
- выписать все лицензии на инструменты, которыми пользуется только ИТ-отдел;
- посчитать переработки и дежурства за год в деньгах или в отгулах;
- отдельно зафиксировать, сколько задач за год пришлось отдать подрядчикам из-за нехватки компетенций внутри.
Последний пункт обычно и оказывается самым показательным: он показывает границу, до которой ваш отдел справляется, и стоимость всего, что за этой границей.
«Полезное упражнение — посчитать не только деньги, но и часы. Сколько времени за год ИТ-руководитель потратил на собеседования, ввод новых людей и разбор аварий вне графика. Обычно выясняется, что на развитие инфраструктуры у него остаётся четверть рабочего времени, и вот это чаще становится поводом что-то менять, чем сама сумма в таблице», — Кирилл Тимофеев, руководитель департамента информационных технологий ОБИТ.
Что делать с этой цифрой
Подытоживая можно сказать, что полная стоимость штатного ИТ-отдела складывается из шести групп затрат: оклады, страховые взносы, содержание рабочих мест и соцпакет, подбор и адаптация, обучение, инструменты. К ним добавляются переработки и риск концентрации знаний. В сумме это в 1,6–2,0 раза больше фонда оплаты труда, на который обычно смотрят.
Сама по себе высокая цифра не означает, что отдел нужно сокращать. Она означает, что сравнение с альтернативами наконец стало корректным. Дальше возможны три сценария. Оставить всё как есть, если ИТ — часть вашего продукта и компетенции критичны. Передать эксплуатацию внешнему подрядчику целиком, если ИТ обслуживает офисные процессы. Или перейти на гибридную модель, где внутри остаются ИТ-директор и архитектура, а поддержка пользователей, администрирование серверов и сетей, мониторинг и дежурства уходят на ИТ-аутсорсинг.
Третий вариант в среднем и крупном бизнесе встречается чаще других, потому что снимает две самые дорогие статьи расчёта — подбор с адаптацией и переработки — и при этом не лишает компанию контроля над развитием инфраструктуры.
Если после подсчётов цифра оказалась выше ожидаемой, приходите на бесплатную консультацию: разберём структуру ваших затрат, посчитаем стоимость обслуживания под вашу инфраструктуру и честно скажем, в какой части штат выгоднее оставить.
Часто задаваемые вопросы (FAQ)
-
Как посчитать полную стоимость штатного ИТ-отдела?Сложить шесть групп затрат: фонд оплаты труда, страховые взносы, содержание рабочих мест и соцпакет, подбор с адаптацией, обучение и лицензии на инструменты ИТ-отдела. Отдельно учесть переработки и дежурства. Данные придётся собирать из трёх бюджетов — ИТ, HR и АХО, — потому что в ИТ-бюджете обычно лежит только ФОТ и лицензии.
-
Во сколько раз полная стоимость выше ФОТ?Рабочий диапазон — от 1,6 до 2,0. Нижняя граница характерна для стабильных команд со скромным соцпакетом и покрытием в рабочие часы. Верхняя — там, где высокая текучесть, дежурства вне графика и расширенный социальный пакет. В расчёте на отдел из четырёх человек с окладами 545 000 рублей в месяц полная стоимость составила 10,7 млн рублей в год против 6,5 млн по ФОТ.
-
Какая ставка страховых взносов действует в 2026 году?Для большинства компаний — 30% с выплат в пределах предельной базы 2 979 000 рублей на сотрудника в год и 15,1% с суммы сверх неё. Льготный тариф 15%, доступный ранее почти всему малому и среднему бизнесу, с января 2026 года сохранён только для компаний из правительственного перечня приоритетных отраслей. Проверить свою ставку стоит до планирования бюджета.
-
Сколько стоит замена ИТ-специалиста?По оценке SHRM, закрытие вакансии обходится в 50–60% годового дохода специалиста, а в ИТ из-за дефицита кадров может превысить его годовую зарплату. В сумму входят доступ к базам резюме и размещение вакансий, работа рекрутера или комиссия агентства, время руководителя на собеседования, потери от открытой позиции и период адаптации, в течение которого продуктивность составляет 0–50% от нормальной.
-
Сколько времени занимает закрытие ИТ-вакансии?По данным «Поток Рекрутмент», проанализировавшего 1762 ИТ-вакансии, медианный срок закрытия составляет 44,5 дня. На практике к этому добавляется период адаптации: чтобы разобраться в незадокументированной инфраструктуре, специалисту требуется от двух до четырёх месяцев. То есть от увольнения до полноценной замены проходит около полугода.
-
Какие расходы чаще всего забывают учесть?Подбор и адаптацию, потому что они лежат в бюджете HR. Стоимость рабочего места и ДМС — они в АХО и в соцпакете. Лицензии на инструменты самого ИТ-отдела: мониторинг, helpdesk, учёт активов. Переработки и дежурства, если они компенсируются отгулами, а не деньгами. И задачи, которые за год пришлось отдать подрядчикам из-за нехватки компетенций внутри команды.
-
Значит ли высокая цифра, что штат нужно сокращать?Нет. Она означает, что сравнение с альтернативами стало корректным. Если ИТ — часть продукта компании, а компетенции критичны, штат оправдан при любой стоимости. Вопрос обычно решается не в пользу одного из вариантов, а в пользу гибридной модели: управление и архитектура остаются внутри, эксплуатация уходит подрядчику.
-
Как сравнивать полную стоимость штата с предложением подрядчика?По сопоставимому объёму услуг, а не по сумме. Нужно выровнять режим поддержки: договор на 12×7 нельзя сравнивать со штатом, работающим 8×5. Нужно учесть, что подрядчик приходит со своим инструментарием и своими узкими специалистами. И нужно отдельно посчитать задачи, которые останутся внутри компании в любом сценарии — они из сравнения исключаются.
ИТ-аутсорсинг
24.08.2026
Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
Array
(
    [ID] => 3522
    [~ID] => 3522
    [IBLOCK_ID] => 36
    [~IBLOCK_ID] => 36
    [IBLOCK_SECTION_ID] => 101
    [~IBLOCK_SECTION_ID] => 101
    [NAME] => Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
    [~NAME] => Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов
    [ACTIVE_FROM_X] => 2026-08-24 08:00:00
    [~ACTIVE_FROM_X] => 2026-08-24 08:00:00
    [ACTIVE_FROM] => 24.08.2026 08:00:00
    [~ACTIVE_FROM] => 24.08.2026 08:00:00
    [TIMESTAMP_X] => 25.08.2026 15:03:44
    [~TIMESTAMP_X] => 25.08.2026 15:03:44
    [DETAIL_PAGE_URL] => /blog/it-autsorsing/sistemy-monitoringa-it-infrastruktury/
    [~DETAIL_PAGE_URL] => /blog/it-autsorsing/sistemy-monitoringa-it-infrastruktury/
    [LIST_PAGE_URL] => /blog/
    [~LIST_PAGE_URL] => /blog/
    [DETAIL_TEXT] => Пока всё работает, ИТ-инфраструктуру не замечают. Замечают в момент, когда встал сайт, зависли платежи или сотрудники не могут войти в 1С. К этому моменту простой уже идёт, а причину ищут вручную по десяткам серверов и сетевых устройств. Системы мониторинга ИТ-инфраструктуры меняют этот сценарий: они непрерывно следят за состоянием серверов, сети, приложений и сервисов и сообщают о проблеме до того, как её заметят пользователи.

Полноценный мониторинг собирают из нескольких продуктов: система опроса и сбора метрик, хранилище данных, визуализация, оповещения, а в крупных инфраструктурах ещё и зонтичная платформа поверх них. Компоненты различаются архитектурой, глубиной наблюдения и ценой — разброс от бесплатного Zabbix до платформ, которые связывают состояние оборудования с бизнес-услугами.

В этой статье разберём, что и зачем отслеживают системы мониторинга, какие бывают платформы, по каким критериям их выбирать и как проходит внедрение. Материал будет полезен ИТ-директорам, системным администраторам и руководителям, которые оценивают, нужен ли компании мониторинг и с чего начать.

Что такое мониторинг ИТ-инфраструктуры

Мониторинг ИТ-инфраструктуры — это непрерывный сбор и анализ данных о состоянии всех компонентов ИТ: серверов, сетевого оборудования, систем хранения, операционных систем, баз данных, приложений и облачных сервисов. Система опрашивает эти компоненты, собирает метрики, сравнивает их с заданными порогами и оповещает специалистов, когда что-то выходит за норму.

Мониторинг отвечает на два вопроса: работает ли инфраструктура прямо сейчас и как она ведёт себя под нагрузкой. Перегретый диск, растущая задержка ответа сервера, переполненная память, недоступный канал связи — система замечает это раньше человека и до того, как проблема перерастёт в сбой.

Выделенная система мониторинга сводит данные в один интерфейс: вместо десятка разрозненных консолей администратор получает экран с состоянием всей инфраструктуры и очередью проблем, которые требуют внимания.

Когда компании нужен мониторинг

Мониторинг обычно нужен, если в компании есть хотя бы одна из ситуаций:
- о сбоях компания узнаёт от пользователей раньше, чем от ИТ-службы;
- при отказе уходит много времени на поиск причины среди серверов, сети и приложений;
- нет объективной статистики о нагрузке и доступности — сложно планировать модернизацию;
- инфраструктура разрослась по площадкам, филиалам и облакам — вручную за ней уже не уследить;
- бизнес зависит от доступности сервисов, а с клиентами есть соглашение об уровне услуг (SLA).
Совпадение хотя бы с одним пунктом — повод перейти к следующему вопросу: что именно система должна наблюдать.
Что отслеживает система мониторинга: объекты, метрики и протоколы
Чтобы понять возможности мониторинга, полезно разложить его на три вопроса: что наблюдают, какие показатели снимают и каким способом собирают данные.
Объекты мониторинга
Система охватывает инфраструктуру по слоям — от физического оборудования до бизнес-сервисов:
- Серверы — физические и виртуальные: загрузка процессора, память, диски, температура, состояние служб.
- Сетевое оборудование — маршрутизаторы, коммутаторы, межсетевые экраны, точки доступа: доступность, загрузка портов, объём трафика.
- Системы хранения — дисковые массивы, NAS и SAN: свободное место, состояние дисков, скорость операций ввода-вывода.
- Операционные системы и виртуализация — состояние гипервизоров, виртуальных машин, запущенных процессов.
- Базы данных — доступность, время отклика запросов, число подключений, репликация.
- Приложения и веб-сервисы — время ответа, доля ошибок, число запросов, работоспособность ключевых функций.
- Облачная инфраструктура и контейнеры — ресурсы виртуальных машин у провайдера, состояние кластеров Kubernetes, микросервисов.
Ключевые метрики
Метрики — числовые показатели, за которыми следит система. Базовый набор одинаков почти для любой инфраструктуры:
- загрузка процессора (CPU), использование оперативной памяти и дискового пространства;
- сетевой трафик и загрузка каналов;
- доступность (uptime) — работает узел или недоступен;
- задержка отклика (latency) — как быстро сервис отвечает на запрос;
- доля ошибок (error rate) — сколько запросов завершается неудачей;
- MTTD и MTTR — среднее время обнаружения и устранения сбоя.
Протоколы и способы сбора данных
Данные с оборудования и сервисов собирают по стандартным протоколам. SNMP снимает показатели с сетевого оборудования и серверов, ICMP проверяет доступность узла пингом, WMI собирает данные с Windows-систем, SSH — с Linux, IPMI — с аппаратной части серверов. Приложения чаще отдают метрики через HTTP и API.
По способу подключения мониторинг делят на два типа. Агентный — на наблюдаемый узел ставится небольшая программа-агент, которая собирает подробные данные изнутри. Безагентный — система опрашивает устройство снаружи по протоколам, ничего на него не устанавливая. Агентный даёт больше деталей, безагентный проще во внедрении и удобен там, где поставить агента нельзя, например на сетевом оборудовании. На практике их сочетают.
Читайте также
Протокол управления SNMP: упрощение управления сетью
Виды мониторинга: инфраструктурный, приложений и зонтичный
Системы мониторинга различаются уровнем, на котором они смотрят на инфраструктуру. Обычно выделяют три подхода, и в зрелой ИТ-службе они дополняют друг друга.
- Инфраструктурный (корневой) мониторинг. Базовый уровень: следит за оборудованием, сетью и операционными системами. Отвечает на вопрос, работает ли конкретный сервер, коммутатор или канал связи. С него начинают почти все.
- Мониторинг приложений (APM, Application Performance Monitoring). Наблюдает за работой программ: время отклика, ошибки, скорость транзакций, качество обслуживания пользователей. Сервер может быть в норме, а приложение при этом работать медленно — этот уровень фиксирует именно такие случаи.
- Зонтичный мониторинг. Верхний уровень, который связывает состояние инфраструктуры с бизнес-услугами. Он не опрашивает оборудование напрямую, а собирает данные из других систем мониторинга и учётных баз, опираясь на ресурсно-сервисную модель (РСМ) — карту того, какие компоненты влияют на какую услугу. Это позволяет сразу увидеть, что отказавший сервер затронул, например, приём онлайн-платежей.
Небольшой компании обычно достаточно инфраструктурного мониторинга. Чем крупнее и сложнее ИТ-ландшафт и чем сильнее бизнес зависит от ИТ, тем важнее подниматься на уровень приложений и бизнес-сервисов.
Мониторинг и наблюдаемость: в чём разница
Рядом с мониторингом используют термин «наблюдаемость» (observability), и эти два понятия часто путают. Разница в глубине понимания системы. Мониторинг показывает, что именно сломалось: метрика вышла за порог, сервис недоступен. Наблюдаемость помогает понять, почему это произошло, и разобраться в поведении системы, даже если заранее такой сбой никто не предвидел.
Наблюдаемость стоит на трёх источниках данных: метрики (числовые показатели), логи (записи о событиях) и трассировки (путь запроса через связанные сервисы). Вместе они дают полную картину и помогают восстановить причину нештатной ситуации в распределённой инфраструктуре.
Для большинства компаний классического мониторинга с грамотно настроенными оповещениями достаточно. Наблюдаемость нужна там, где много микросервисов и сложные распределённые приложения, а простого сигнала о недоступности сервера не хватает, чтобы понять корень проблемы.
Обзор платформ мониторинга ИТ-инфраструктуры
Рынок систем мониторинга делится на три группы: открытые решения, зарубежные коммерческие платформы и российские продукты. После ухода западных вендоров их стало сложно покупать, продлевать лицензии и получать поддержку вендора, поэтому дальше разбираем открытые и российские системы — они актуальны в текущих реалиях.
Решения с открытым кодом
Платформы с открытым кодом не требуют платы за лицензии, но нужна квалификация для настройки и сопровождения. Их чаще выбирают ИТ-команды с собственными специалистами.
|
Платформа |
Чем характерна |
Кому подходит |
|
Zabbix |
Универсальная система мониторинга. Агентный и безагентный сбор, поддержка SNMP, гибкие триггеры и оповещения. Подходит для мониторинга разнородной инфраструктуры, популярна на российском рынке, есть большое русскоязычное сообщество. |
Компаниям с разнородной инфраструктурой, которые сводят серверы, сеть и СХД в одну систему и держат администратора в штате |
|
Prometheus + Grafana |
Связка для облачных и контейнерных сред. Prometheus собирает метрики по pull-модели и изначально работает с Kubernetes, Grafana строит наглядные панели. Чаще всего применяется в микросервисных средах. |
Командам с контейнерами и микросервисами, где состав инфраструктуры часто меняется |
|
Nagios и Icinga |
Давно применяются для мониторинга доступности и состояния узлов. Icinga — форк Nagios с обновлённым интерфейсом и REST API. |
Компаниям, которым достаточно контроля доступности узлов, и площадкам, где Nagios уже развёрнут |
|
Netdata, VictoriaMetrics |
Netdata — лёгкий агент для детальной диагностики в реальном времени. VictoriaMetrics — хранилище метрик, рассчитанное на большие объёмы; часто используют как замену или дополнение Prometheus. |
Администраторам, которым нужна быстрая диагностика отдельного сервера, и командам, у которых объём метрик перерос хранилище Prometheus |
Российские системы и импортозамещение
Для госсектора, субъектов критической информационной инфраструктуры (КИИ) и компаний, которые переходят на отечественный стек, важны наличие продукта в реестре российского ПО Минцифры и совместимость с отечественными операционными системами. По большинству задач на российском рынке есть отработанные решения.
|
Решение |
Чем характерно |
Кому подходит |
|
Пульт (Инфосистемы Джет) |
Коммерческая платформа на основе Zabbix с поддержкой российских ОС. Ориентирована на крупную инфраструктуру и промышленную эксплуатацию. |
Компаниям, которым нужны коммерческий контракт и поддержка вендора вместо самостоятельного сопровождения Zabbix |
|
Naumen Network Manager и BSM |
Инфраструктурный и зонтичный мониторинг с анализом первопричин и связкой с процессами управления ИТ-услугами. |
Крупным ИТ-службам, у которых уже выстроены процессы управления ИТ-услугами |
|
Monq |
Платформа зонтичного мониторинга с автоматической корреляцией событий и элементами ИИ для анализа инцидентов. |
Командам эксплуатации, которые разбирают поток событий сразу из нескольких систем |
|
Platform V Monitor |
Модульная система с предиктивной аналитикой для больших объёмов метрик. |
Крупным ИТ-службам с высокой нагрузкой, которым нужен прогноз проблем до сбоя |
Универсально лучшего продукта нет. Решения с открытым кодом выигрывают по стоимости лицензий, но требуют своих специалистов. Российские коммерческие платформы дают поддержку на русском языке, соответствие требованиям регуляторов и готовность к промышленной эксплуатации. Выбор зависит от размера инфраструктуры, отраслевых требований и того, кто будет обслуживать систему.
Как выбрать систему мониторинга: критерии
Выбор системы начинается с оценки того, насколько она подходит вашей инфраструктуре и команде. На что смотреть в первую очередь:
- Поддерживаемые объекты и протоколы. Система должна уметь работать с вашим оборудованием и ПО. Проверьте поддержку SNMP, ICMP, WMI, SSH и наличие готовых шаблонов под ваши устройства, в том числе российские.
- Масштабируемость. Возможность нарастить мощность и подключить новые площадки без замены платформы.
- Гибкость оповещений. Настройка порогов, группировка и подавление повторяющихся уведомлений, доставка по нужным каналам — почте, в мессенджеры, по эскалации.
- Визуализация и отчётность. Понятные панели и отчёты для инженеров и для руководства, наглядная топология инфраструктуры.
- Интеграции. Связка с системами управления ИТ-услугами (ITSM) и учёта активов (ITAM), автоматическое создание заявок по оповещениям, анализ первопричин.
- Модель развёртывания. На своей площадке, в облаке или гибридно — выбор зависит от требований к данным и наличия собственной инфраструктуры.
- Реестр и сертификаты. Для госсектора и субъектов КИИ — наличие в реестре отечественного ПО и совместимость с российскими ОС.
- Стоимость владения (TCO). Кроме лицензии в бюджет входят серверы под саму систему, внедрение, сопровождение и часы своих администраторов.
Проверить систему по этим критериям надёжнее на живой инфраструктуре, чем по описанию у вендора.
Сколько стоит система мониторинга: структура затрат
Точную сумму считают после инвентаризации: цена зависит от числа объектов, глубины хранения метрик и модели лицензирования. Складывается бюджет из пяти статей:
- Лицензии. У решений с открытым кодом лицензий нет; в коммерческих платформах их считают по числу узлов, метрик или пользователей.
- Инфраструктура под саму систему. Сервер мониторинга и хранилище метрик: чем дольше хранится история и чем чаще идёт опрос, тем больше нужно дисков и памяти.
- Внедрение и настройка. Инвентаризация, шаблоны под оборудование, пороги, панели, маршруты оповещений, интеграция с системой заявок.
- Сопровождение. Разбор оповещений, корректировка порогов, подключение новых объектов по мере роста инфраструктуры.
- Время своих специалистов. В проектах на открытых решениях эту статью бюджета обычно не закладывают, хотя сопровождение системы забирает рабочие часы администратора.
Этапы внедрения мониторинга
Внедрение системы мониторинга — комплексный проект, который затрагивает серверы, сеть, приложения и процессы эксплуатации. Логика этапов почти одинакова для любой системы.
- Аудит и инвентаризация. Составляют перечень оборудования, сервисов и приложений, определяют, что критично для бизнеса и что нужно наблюдать в первую очередь.
- Проектирование. Выбирают систему под задачи, продумывают архитектуру сбора данных и, если нужен зонтичный мониторинг, описывают ресурсно-сервисную модель.
- Пилот. Разворачивают систему на части инфраструктуры и проверяют, что она корректно собирает данные и оповещает о проблемах.
- Промышленное внедрение. Подключают все объекты, устанавливают агенты и настраивают опрос по протоколам.
- Настройка порогов, оповещений и панелей. Задают пороги под реальную нагрузку, маршруты уведомлений и панели для разных ролей. От качества настройки на этом этапе зависит, сколько ложных срабатываний получит команда.
- Интеграция и сопровождение. Связывают систему с процессами обработки заявок, а дальше поддерживают: подключают новые объекты, корректируют пороги, дорабатывают правила.
Частые ошибки при выборе и внедрении мониторинга
Ошибки в мониторинге чаще всего закладываются на этапе выбора и настройки, а проявляются через несколько месяцев работы. Самые частые из них:
|
Ошибка |
Чем оборачивается |
|
Выбирают платформу по списку возможностей, без оглядки на свою команду |
Платформу разворачивают, но сопровождать её некому: настройки устаревают, доверие к системе падает |
|
Оставляют пороги по умолчанию |
Поток ложных срабатываний, на который команда перестаёт реагировать, и пропущенные реальные сбои |
|
Подключают всю инфраструктуру сразу |
Поток событий без приоритетов с первого дня, разбирать его некогда |
|
Не разделяют объекты по критичности для бизнеса |
Все узлы в системе равнозначны, и по оповещению непонятно, что чинить в первую очередь |
|
Не описывают регламент реакции и дежурства |
Система фиксирует проблему ночью, а реагируют на неё утром — выигрыш во времени пропадает |
|
Не закладывают рост инфраструктуры |
Система упирается в производительность, и проект внедрения повторяют заново |
Мониторинг как управляемый сервис
Мониторинг приносит пользу, только когда кто-то постоянно разбирает оповещения, реагирует на инциденты и обновляет настройки. У многих компаний на это не хватает людей: держать дежурную смену ради мониторинга дорого, а без неё система работает вхолостую.
Мониторинг и сопровождение инфраструктуры можно передать подрядчику. Внешняя команда следит за состоянием серверов, сети и сервисов, реагирует на инциденты и отвечает за согласованный уровень услуг. Вы получаете стабильную работу ИТ без затрат на штат эксплуатации. Мониторинг при этом удобно совмещать с контролем событий информационной безопасности, чтобы отслеживать и технические сбои, и подозрительную активность в едином контуре.
Часто задаваемые вопросы (FAQ)
-
Чем мониторинг отличается от наблюдаемости (observability)?Мониторинг показывает, что сломалось: он отслеживает заранее заданные метрики и сообщает, когда они выходят за порог. Наблюдаемость помогает понять, почему это произошло: она опирается на метрики, логи и трассировки и позволяет разобраться в причине сбоя, даже если его заранее не предвидели. Для большинства компаний достаточно классического мониторинга; наблюдаемость нужна при сложных распределённых приложениях.
-
В чём разница между Zabbix и Prometheus?Zabbix — универсальная система для мониторинга разнородной инфраструктуры: серверов, сети, оборудования по SNMP. Prometheus заточен под облачные и контейнерные среды, работает по pull-модели и изначально рассчитан на Kubernetes. Zabbix чаще выбирают для классической инфраструктуры, Prometheus в связке с Grafana — для микросервисов. Нередко их используют вместе, каждый на своём участке.
-
Что такое агентный и безагентный мониторинг?Разница в том, ставится ли что-то на сам наблюдаемый узел: агент собирает данные изнутри системы, безагентный опрос идёт снаружи по SNMP, ICMP и подобным протоколам. Выбирают по объекту: на серверы обычно ставят агента ради глубины данных, сетевое оборудование опрашивают снаружи. В большинстве инфраструктур работают оба способа одновременно.
-
Что такое зонтичный мониторинг и чем он отличается от инфраструктурного?Инфраструктурный мониторинг следит за отдельными компонентами: серверами, сетью, оборудованием. Зонтичный поднимается на уровень выше — он собирает данные из других систем мониторинга и связывает состояние компонентов с бизнес-услугами через ресурсно-сервисную модель. Это позволяет сразу увидеть, какую услугу затронул конкретный отказ.
-
Какие российские системы мониторинга подходят для импортозамещения?На российском рынке есть зрелые решения: Пульт от Инфосистемы Джет, Naumen Network Manager и BSM, Monq, Platform V Monitor. Для госсектора и субъектов КИИ важно, чтобы система была в реестре отечественного ПО Минцифры и работала с российскими операционными системами. Конкретный выбор зависит от размера инфраструктуры, требований регуляторов и бюджета.
-
Какие метрики важнее всего отслеживать?Базовый набор — загрузка процессора, использование памяти и дискового пространства, сетевой трафик, доступность узлов и задержка отклика. Для приложений добавляют долю ошибок и время ответа. Для оценки работы самой ИТ-службы важны MTTD и MTTR — среднее время обнаружения и устранения сбоя. Точный набор метрик зависит от того, что критично для конкретного бизнеса.
-
Можно ли мониторить облачную инфраструктуру и контейнеры?Да. Для облака и контейнеров применяют те же принципы, но с поправкой на динамику среды: узлы появляются и исчезают, поэтому объекты ставят на мониторинг автоматически. Для кластеров Kubernetes и микросервисов чаще всего используют связку Prometheus и Grafana. Облачные провайдеры дополнительно предлагают собственные сервисы мониторинга для ресурсов, размещённых у них.
-
Как снизить поток ложных оповещений?Ложные срабатывания возникают, когда пороги не адаптированы под реальную нагрузку. Помогает несколько мер: настройка порогов по фактическим показателям, группировка связанных оповещений в одно, подавление повторов и приоритизация по критичности. Цель — чтобы каждое оповещение требовало действия. Пороги уточняют по мере работы системы.
-
Сколько времени занимает внедрение системы мониторинга?Срок зависит от размера инфраструктуры и числа объектов. Пилот на части систем разворачивают за несколько недель, полноценное внедрение с подключением всех объектов и настройкой оповещений занимает от одного-двух месяцев. После запуска пороги и правила дорабатывают по мере роста инфраструктуры и появления новых сервисов.
-
Можно ли отдать мониторинг на аутсорс?Да, и это частый выбор для компаний без собственной дежурной смены. Подрядчик разворачивает систему и дальше сам разбирает оповещения, реагирует на инциденты и держит настройки в рабочем состоянии. Дежурство при этом не нужно закрывать своими людьми. Формат сотрудничества и объём работ согласуют под конкретную инфраструктуру.
С чего начать мониторинг ИТ-инфраструктуры
Система мониторинга сводит серверы, сеть и приложения в одну управляемую картину: о проблеме узнают раньше пользователей, а причину сбоя находят быстрее. Дальше всё зависит от понимания своей инфраструктуры: что критично для бизнеса, какие объекты наблюдать, кто будет обслуживать систему и какие требования регуляторов учесть.
Если вы выбираете систему мониторинга, мы поможем разобраться. Подбираем и внедряем решения под конкретную инфраструктуру, в том числе на базе российских продуктов, а при необходимости берём мониторинг и обслуживание на себя. Расскажите о своей инфраструктуре — предложим подходящий вариант и оценим объём работ.
[~DETAIL_TEXT] =>Пока всё работает, ИТ-инфраструктуру не замечают. Замечают в момент, когда встал сайт, зависли платежи или сотрудники не могут войти в 1С. К этому моменту простой уже идёт, а причину ищут вручную по десяткам серверов и сетевых устройств. Системы мониторинга ИТ-инфраструктуры меняют этот сценарий: они непрерывно следят за состоянием серверов, сети, приложений и сервисов и сообщают о проблеме до того, как её заметят пользователи.
Полноценный мониторинг собирают из нескольких продуктов: система опроса и сбора метрик, хранилище данных, визуализация, оповещения, а в крупных инфраструктурах ещё и зонтичная платформа поверх них. Компоненты различаются архитектурой, глубиной наблюдения и ценой — разброс от бесплатного Zabbix до платформ, которые связывают состояние оборудования с бизнес-услугами.
В этой статье разберём, что и зачем отслеживают системы мониторинга, какие бывают платформы, по каким критериям их выбирать и как проходит внедрение. Материал будет полезен ИТ-директорам, системным администраторам и руководителям, которые оценивают, нужен ли компании мониторинг и с чего начать.
Что такое мониторинг ИТ-инфраструктуры
Мониторинг ИТ-инфраструктуры — это непрерывный сбор и анализ данных о состоянии всех компонентов ИТ: серверов, сетевого оборудования, систем хранения, операционных систем, баз данных, приложений и облачных сервисов. Система опрашивает эти компоненты, собирает метрики, сравнивает их с заданными порогами и оповещает специалистов, когда что-то выходит за норму.
Мониторинг отвечает на два вопроса: работает ли инфраструктура прямо сейчас и как она ведёт себя под нагрузкой. Перегретый диск, растущая задержка ответа сервера, переполненная память, недоступный канал связи — система замечает это раньше человека и до того, как проблема перерастёт в сбой.
Выделенная система мониторинга сводит данные в один интерфейс: вместо десятка разрозненных консолей администратор получает экран с состоянием всей инфраструктуры и очередью проблем, которые требуют внимания.
Когда компании нужен мониторинг
Мониторинг обычно нужен, если в компании есть хотя бы одна из ситуаций:
- о сбоях компания узнаёт от пользователей раньше, чем от ИТ-службы;
- при отказе уходит много времени на поиск причины среди серверов, сети и приложений;
- нет объективной статистики о нагрузке и доступности — сложно планировать модернизацию;
- инфраструктура разрослась по площадкам, филиалам и облакам — вручную за ней уже не уследить;
- бизнес зависит от доступности сервисов, а с клиентами есть соглашение об уровне услуг (SLA).
Совпадение хотя бы с одним пунктом — повод перейти к следующему вопросу: что именно система должна наблюдать.
Что отслеживает система мониторинга: объекты, метрики и протоколы
Чтобы понять возможности мониторинга, полезно разложить его на три вопроса: что наблюдают, какие показатели снимают и каким способом собирают данные.
Объекты мониторинга
Система охватывает инфраструктуру по слоям — от физического оборудования до бизнес-сервисов:
- Серверы — физические и виртуальные: загрузка процессора, память, диски, температура, состояние служб.
- Сетевое оборудование — маршрутизаторы, коммутаторы, межсетевые экраны, точки доступа: доступность, загрузка портов, объём трафика.
- Системы хранения — дисковые массивы, NAS и SAN: свободное место, состояние дисков, скорость операций ввода-вывода.
- Операционные системы и виртуализация — состояние гипервизоров, виртуальных машин, запущенных процессов.
- Базы данных — доступность, время отклика запросов, число подключений, репликация.
- Приложения и веб-сервисы — время ответа, доля ошибок, число запросов, работоспособность ключевых функций.
- Облачная инфраструктура и контейнеры — ресурсы виртуальных машин у провайдера, состояние кластеров Kubernetes, микросервисов.
Ключевые метрики
Метрики — числовые показатели, за которыми следит система. Базовый набор одинаков почти для любой инфраструктуры:
- загрузка процессора (CPU), использование оперативной памяти и дискового пространства;
- сетевой трафик и загрузка каналов;
- доступность (uptime) — работает узел или недоступен;
- задержка отклика (latency) — как быстро сервис отвечает на запрос;
- доля ошибок (error rate) — сколько запросов завершается неудачей;
- MTTD и MTTR — среднее время обнаружения и устранения сбоя.
Протоколы и способы сбора данных
Данные с оборудования и сервисов собирают по стандартным протоколам. SNMP снимает показатели с сетевого оборудования и серверов, ICMP проверяет доступность узла пингом, WMI собирает данные с Windows-систем, SSH — с Linux, IPMI — с аппаратной части серверов. Приложения чаще отдают метрики через HTTP и API.
По способу подключения мониторинг делят на два типа. Агентный — на наблюдаемый узел ставится небольшая программа-агент, которая собирает подробные данные изнутри. Безагентный — система опрашивает устройство снаружи по протоколам, ничего на него не устанавливая. Агентный даёт больше деталей, безагентный проще во внедрении и удобен там, где поставить агента нельзя, например на сетевом оборудовании. На практике их сочетают.
Читайте также
Протокол управления SNMP: упрощение управления сетью
Виды мониторинга: инфраструктурный, приложений и зонтичный
Системы мониторинга различаются уровнем, на котором они смотрят на инфраструктуру. Обычно выделяют три подхода, и в зрелой ИТ-службе они дополняют друг друга.
- Инфраструктурный (корневой) мониторинг. Базовый уровень: следит за оборудованием, сетью и операционными системами. Отвечает на вопрос, работает ли конкретный сервер, коммутатор или канал связи. С него начинают почти все.
- Мониторинг приложений (APM, Application Performance Monitoring). Наблюдает за работой программ: время отклика, ошибки, скорость транзакций, качество обслуживания пользователей. Сервер может быть в норме, а приложение при этом работать медленно — этот уровень фиксирует именно такие случаи.
- Зонтичный мониторинг. Верхний уровень, который связывает состояние инфраструктуры с бизнес-услугами. Он не опрашивает оборудование напрямую, а собирает данные из других систем мониторинга и учётных баз, опираясь на ресурсно-сервисную модель (РСМ) — карту того, какие компоненты влияют на какую услугу. Это позволяет сразу увидеть, что отказавший сервер затронул, например, приём онлайн-платежей.
Небольшой компании обычно достаточно инфраструктурного мониторинга. Чем крупнее и сложнее ИТ-ландшафт и чем сильнее бизнес зависит от ИТ, тем важнее подниматься на уровень приложений и бизнес-сервисов.
Мониторинг и наблюдаемость: в чём разница
Рядом с мониторингом используют термин «наблюдаемость» (observability), и эти два понятия часто путают. Разница в глубине понимания системы. Мониторинг показывает, что именно сломалось: метрика вышла за порог, сервис недоступен. Наблюдаемость помогает понять, почему это произошло, и разобраться в поведении системы, даже если заранее такой сбой никто не предвидел.
Наблюдаемость стоит на трёх источниках данных: метрики (числовые показатели), логи (записи о событиях) и трассировки (путь запроса через связанные сервисы). Вместе они дают полную картину и помогают восстановить причину нештатной ситуации в распределённой инфраструктуре.
Для большинства компаний классического мониторинга с грамотно настроенными оповещениями достаточно. Наблюдаемость нужна там, где много микросервисов и сложные распределённые приложения, а простого сигнала о недоступности сервера не хватает, чтобы понять корень проблемы.
Обзор платформ мониторинга ИТ-инфраструктуры
Рынок систем мониторинга делится на три группы: открытые решения, зарубежные коммерческие платформы и российские продукты. После ухода западных вендоров их стало сложно покупать, продлевать лицензии и получать поддержку вендора, поэтому дальше разбираем открытые и российские системы — они актуальны в текущих реалиях.
Решения с открытым кодом
Платформы с открытым кодом не требуют платы за лицензии, но нужна квалификация для настройки и сопровождения. Их чаще выбирают ИТ-команды с собственными специалистами.
|
Платформа |
Чем характерна |
Кому подходит |
|
Zabbix |
Универсальная система мониторинга. Агентный и безагентный сбор, поддержка SNMP, гибкие триггеры и оповещения. Подходит для мониторинга разнородной инфраструктуры, популярна на российском рынке, есть большое русскоязычное сообщество. |
Компаниям с разнородной инфраструктурой, которые сводят серверы, сеть и СХД в одну систему и держат администратора в штате |
|
Prometheus + Grafana |
Связка для облачных и контейнерных сред. Prometheus собирает метрики по pull-модели и изначально работает с Kubernetes, Grafana строит наглядные панели. Чаще всего применяется в микросервисных средах. |
Командам с контейнерами и микросервисами, где состав инфраструктуры часто меняется |
|
Nagios и Icinga |
Давно применяются для мониторинга доступности и состояния узлов. Icinga — форк Nagios с обновлённым интерфейсом и REST API. |
Компаниям, которым достаточно контроля доступности узлов, и площадкам, где Nagios уже развёрнут |
|
Netdata, VictoriaMetrics |
Netdata — лёгкий агент для детальной диагностики в реальном времени. VictoriaMetrics — хранилище метрик, рассчитанное на большие объёмы; часто используют как замену или дополнение Prometheus. |
Администраторам, которым нужна быстрая диагностика отдельного сервера, и командам, у которых объём метрик перерос хранилище Prometheus |
Российские системы и импортозамещение
Для госсектора, субъектов критической информационной инфраструктуры (КИИ) и компаний, которые переходят на отечественный стек, важны наличие продукта в реестре российского ПО Минцифры и совместимость с отечественными операционными системами. По большинству задач на российском рынке есть отработанные решения.
|
Решение |
Чем характерно |
Кому подходит |
|
Пульт (Инфосистемы Джет) |
Коммерческая платформа на основе Zabbix с поддержкой российских ОС. Ориентирована на крупную инфраструктуру и промышленную эксплуатацию. |
Компаниям, которым нужны коммерческий контракт и поддержка вендора вместо самостоятельного сопровождения Zabbix |
|
Naumen Network Manager и BSM |
Инфраструктурный и зонтичный мониторинг с анализом первопричин и связкой с процессами управления ИТ-услугами. |
Крупным ИТ-службам, у которых уже выстроены процессы управления ИТ-услугами |
|
Monq |
Платформа зонтичного мониторинга с автоматической корреляцией событий и элементами ИИ для анализа инцидентов. |
Командам эксплуатации, которые разбирают поток событий сразу из нескольких систем |
|
Platform V Monitor |
Модульная система с предиктивной аналитикой для больших объёмов метрик. |
Крупным ИТ-службам с высокой нагрузкой, которым нужен прогноз проблем до сбоя |
Универсально лучшего продукта нет. Решения с открытым кодом выигрывают по стоимости лицензий, но требуют своих специалистов. Российские коммерческие платформы дают поддержку на русском языке, соответствие требованиям регуляторов и готовность к промышленной эксплуатации. Выбор зависит от размера инфраструктуры, отраслевых требований и того, кто будет обслуживать систему.
Как выбрать систему мониторинга: критерии
Выбор системы начинается с оценки того, насколько она подходит вашей инфраструктуре и команде. На что смотреть в первую очередь:
- Поддерживаемые объекты и протоколы. Система должна уметь работать с вашим оборудованием и ПО. Проверьте поддержку SNMP, ICMP, WMI, SSH и наличие готовых шаблонов под ваши устройства, в том числе российские.
- Масштабируемость. Возможность нарастить мощность и подключить новые площадки без замены платформы.
- Гибкость оповещений. Настройка порогов, группировка и подавление повторяющихся уведомлений, доставка по нужным каналам — почте, в мессенджеры, по эскалации.
- Визуализация и отчётность. Понятные панели и отчёты для инженеров и для руководства, наглядная топология инфраструктуры.
- Интеграции. Связка с системами управления ИТ-услугами (ITSM) и учёта активов (ITAM), автоматическое создание заявок по оповещениям, анализ первопричин.
- Модель развёртывания. На своей площадке, в облаке или гибридно — выбор зависит от требований к данным и наличия собственной инфраструктуры.
- Реестр и сертификаты. Для госсектора и субъектов КИИ — наличие в реестре отечественного ПО и совместимость с российскими ОС.
- Стоимость владения (TCO). Кроме лицензии в бюджет входят серверы под саму систему, внедрение, сопровождение и часы своих администраторов.
Проверить систему по этим критериям надёжнее на живой инфраструктуре, чем по описанию у вендора.
Сколько стоит система мониторинга: структура затрат
Точную сумму считают после инвентаризации: цена зависит от числа объектов, глубины хранения метрик и модели лицензирования. Складывается бюджет из пяти статей:
- Лицензии. У решений с открытым кодом лицензий нет; в коммерческих платформах их считают по числу узлов, метрик или пользователей.
- Инфраструктура под саму систему. Сервер мониторинга и хранилище метрик: чем дольше хранится история и чем чаще идёт опрос, тем больше нужно дисков и памяти.
- Внедрение и настройка. Инвентаризация, шаблоны под оборудование, пороги, панели, маршруты оповещений, интеграция с системой заявок.
- Сопровождение. Разбор оповещений, корректировка порогов, подключение новых объектов по мере роста инфраструктуры.
- Время своих специалистов. В проектах на открытых решениях эту статью бюджета обычно не закладывают, хотя сопровождение системы забирает рабочие часы администратора.
Этапы внедрения мониторинга
Внедрение системы мониторинга — комплексный проект, который затрагивает серверы, сеть, приложения и процессы эксплуатации. Логика этапов почти одинакова для любой системы.
- Аудит и инвентаризация. Составляют перечень оборудования, сервисов и приложений, определяют, что критично для бизнеса и что нужно наблюдать в первую очередь.
- Проектирование. Выбирают систему под задачи, продумывают архитектуру сбора данных и, если нужен зонтичный мониторинг, описывают ресурсно-сервисную модель.
- Пилот. Разворачивают систему на части инфраструктуры и проверяют, что она корректно собирает данные и оповещает о проблемах.
- Промышленное внедрение. Подключают все объекты, устанавливают агенты и настраивают опрос по протоколам.
- Настройка порогов, оповещений и панелей. Задают пороги под реальную нагрузку, маршруты уведомлений и панели для разных ролей. От качества настройки на этом этапе зависит, сколько ложных срабатываний получит команда.
- Интеграция и сопровождение. Связывают систему с процессами обработки заявок, а дальше поддерживают: подключают новые объекты, корректируют пороги, дорабатывают правила.
Частые ошибки при выборе и внедрении мониторинга
Ошибки в мониторинге чаще всего закладываются на этапе выбора и настройки, а проявляются через несколько месяцев работы. Самые частые из них:
|
Ошибка |
Чем оборачивается |
|
Выбирают платформу по списку возможностей, без оглядки на свою команду |
Платформу разворачивают, но сопровождать её некому: настройки устаревают, доверие к системе падает |
|
Оставляют пороги по умолчанию |
Поток ложных срабатываний, на который команда перестаёт реагировать, и пропущенные реальные сбои |
|
Подключают всю инфраструктуру сразу |
Поток событий без приоритетов с первого дня, разбирать его некогда |
|
Не разделяют объекты по критичности для бизнеса |
Все узлы в системе равнозначны, и по оповещению непонятно, что чинить в первую очередь |
|
Не описывают регламент реакции и дежурства |
Система фиксирует проблему ночью, а реагируют на неё утром — выигрыш во времени пропадает |
|
Не закладывают рост инфраструктуры |
Система упирается в производительность, и проект внедрения повторяют заново |
Мониторинг как управляемый сервис
Мониторинг приносит пользу, только когда кто-то постоянно разбирает оповещения, реагирует на инциденты и обновляет настройки. У многих компаний на это не хватает людей: держать дежурную смену ради мониторинга дорого, а без неё система работает вхолостую.
Мониторинг и сопровождение инфраструктуры можно передать подрядчику. Внешняя команда следит за состоянием серверов, сети и сервисов, реагирует на инциденты и отвечает за согласованный уровень услуг. Вы получаете стабильную работу ИТ без затрат на штат эксплуатации. Мониторинг при этом удобно совмещать с контролем событий информационной безопасности, чтобы отслеживать и технические сбои, и подозрительную активность в едином контуре.
Часто задаваемые вопросы (FAQ)
-
Чем мониторинг отличается от наблюдаемости (observability)?Мониторинг показывает, что сломалось: он отслеживает заранее заданные метрики и сообщает, когда они выходят за порог. Наблюдаемость помогает понять, почему это произошло: она опирается на метрики, логи и трассировки и позволяет разобраться в причине сбоя, даже если его заранее не предвидели. Для большинства компаний достаточно классического мониторинга; наблюдаемость нужна при сложных распределённых приложениях.
-
В чём разница между Zabbix и Prometheus?Zabbix — универсальная система для мониторинга разнородной инфраструктуры: серверов, сети, оборудования по SNMP. Prometheus заточен под облачные и контейнерные среды, работает по pull-модели и изначально рассчитан на Kubernetes. Zabbix чаще выбирают для классической инфраструктуры, Prometheus в связке с Grafana — для микросервисов. Нередко их используют вместе, каждый на своём участке.
-
Что такое агентный и безагентный мониторинг?Разница в том, ставится ли что-то на сам наблюдаемый узел: агент собирает данные изнутри системы, безагентный опрос идёт снаружи по SNMP, ICMP и подобным протоколам. Выбирают по объекту: на серверы обычно ставят агента ради глубины данных, сетевое оборудование опрашивают снаружи. В большинстве инфраструктур работают оба способа одновременно.
-
Что такое зонтичный мониторинг и чем он отличается от инфраструктурного?Инфраструктурный мониторинг следит за отдельными компонентами: серверами, сетью, оборудованием. Зонтичный поднимается на уровень выше — он собирает данные из других систем мониторинга и связывает состояние компонентов с бизнес-услугами через ресурсно-сервисную модель. Это позволяет сразу увидеть, какую услугу затронул конкретный отказ.
-
Какие российские системы мониторинга подходят для импортозамещения?На российском рынке есть зрелые решения: Пульт от Инфосистемы Джет, Naumen Network Manager и BSM, Monq, Platform V Monitor. Для госсектора и субъектов КИИ важно, чтобы система была в реестре отечественного ПО Минцифры и работала с российскими операционными системами. Конкретный выбор зависит от размера инфраструктуры, требований регуляторов и бюджета.
-
Какие метрики важнее всего отслеживать?Базовый набор — загрузка процессора, использование памяти и дискового пространства, сетевой трафик, доступность узлов и задержка отклика. Для приложений добавляют долю ошибок и время ответа. Для оценки работы самой ИТ-службы важны MTTD и MTTR — среднее время обнаружения и устранения сбоя. Точный набор метрик зависит от того, что критично для конкретного бизнеса.
-
Можно ли мониторить облачную инфраструктуру и контейнеры?Да. Для облака и контейнеров применяют те же принципы, но с поправкой на динамику среды: узлы появляются и исчезают, поэтому объекты ставят на мониторинг автоматически. Для кластеров Kubernetes и микросервисов чаще всего используют связку Prometheus и Grafana. Облачные провайдеры дополнительно предлагают собственные сервисы мониторинга для ресурсов, размещённых у них.
-
Как снизить поток ложных оповещений?Ложные срабатывания возникают, когда пороги не адаптированы под реальную нагрузку. Помогает несколько мер: настройка порогов по фактическим показателям, группировка связанных оповещений в одно, подавление повторов и приоритизация по критичности. Цель — чтобы каждое оповещение требовало действия. Пороги уточняют по мере работы системы.
-
Сколько времени занимает внедрение системы мониторинга?Срок зависит от размера инфраструктуры и числа объектов. Пилот на части систем разворачивают за несколько недель, полноценное внедрение с подключением всех объектов и настройкой оповещений занимает от одного-двух месяцев. После запуска пороги и правила дорабатывают по мере роста инфраструктуры и появления новых сервисов.
-
Можно ли отдать мониторинг на аутсорс?Да, и это частый выбор для компаний без собственной дежурной смены. Подрядчик разворачивает систему и дальше сам разбирает оповещения, реагирует на инциденты и держит настройки в рабочем состоянии. Дежурство при этом не нужно закрывать своими людьми. Формат сотрудничества и объём работ согласуют под конкретную инфраструктуру.
С чего начать мониторинг ИТ-инфраструктуры
Система мониторинга сводит серверы, сеть и приложения в одну управляемую картину: о проблеме узнают раньше пользователей, а причину сбоя находят быстрее. Дальше всё зависит от понимания своей инфраструктуры: что критично для бизнеса, какие объекты наблюдать, кто будет обслуживать систему и какие требования регуляторов учесть.
Если вы выбираете систему мониторинга, мы поможем разобраться. Подбираем и внедряем решения под конкретную инфраструктуру, в том числе на базе российских продуктов, а при необходимости берём мониторинг и обслуживание на себя. Расскажите о своей инфраструктуре — предложим подходящий вариант и оценим объём работ.
[DETAIL_TEXT_TYPE] => html [~DETAIL_TEXT_TYPE] => html [PREVIEW_TEXT] => В этой статье разберём, что и зачем отслеживают системы мониторинга, какие бывают платформы, по каким критериям их выбирать и как проходит внедрение. [~PREVIEW_TEXT] => В этой статье разберём, что и зачем отслеживают системы мониторинга, какие бывают платформы, по каким критериям их выбирать и как проходит внедрение. [PREVIEW_TEXT_TYPE] => text [~PREVIEW_TEXT_TYPE] => text [PREVIEW_PICTURE] => Array ( [ID] => 4059 [TIMESTAMP_X] => 25.08.2026 15:03:44 [MODULE_ID] => iblock [HEIGHT] => 525 [WIDTH] => 1130 [FILE_SIZE] => 78728 [CONTENT_TYPE] => image/jpeg [SUBDIR] => iblock/a3e [FILE_NAME] => esn5c9phn46q9b2bxu1ditya1255lon2.jpg [ORIGINAL_NAME] => sistemy-monitoringa-it-infrastruktury.jpg [DESCRIPTION] => Системы мониторинга ИТ-инфраструктуры [HANDLER_ID] => [EXTERNAL_ID] => ib7eyoqqgt9dm3subnorp50vlsqk7cx6 [VERSION_ORIGINAL_ID] => [META] => [SRC] => /upload/iblock/a3e/esn5c9phn46q9b2bxu1ditya1255lon2.jpg [UNSAFE_SRC] => /upload/iblock/a3e/esn5c9phn46q9b2bxu1ditya1255lon2.jpg [SAFE_SRC] => /upload/iblock/a3e/esn5c9phn46q9b2bxu1ditya1255lon2.jpg [ALT] => Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов [TITLE] => Системы мониторинга ИТ-инфраструктуры: как выбрать платформу и внедрить мониторинг серверов, сети и сервисов ) [~PREVIEW_PICTURE] => 4059 [LANG_DIR] => / [~LANG_DIR] => / [CODE] => sistemy-monitoringa-it-infrastruktury [~CODE] => sistemy-monitoringa-it-infrastruktury [EXTERNAL_ID] => 3522 [~EXTERNAL_ID] => 3522 [IBLOCK_TYPE_ID] => content [~IBLOCK_TYPE_ID] => content [IBLOCK_CODE] => [~IBLOCK_CODE] => [IBLOCK_EXTERNAL_ID] => [~IBLOCK_EXTERNAL_ID] => [LID] => s1 [~LID] => s1 [EDIT_LINK] => [DELETE_LINK] => [DISPLAY_ACTIVE_FROM] => 24.08.2026 [FIELDS] => Array ( ) [DISPLAY_PROPERTIES] => Array ( ) [IPROPERTY_VALUES] => Array ( [ELEMENT_META_TITLE] => Системы мониторинга ИТ-инфраструктуры: обзор и выбор | ОБИТ [ELEMENT_META_DESCRIPTION] => Что такое мониторинг ИТ-инфраструктуры, какие платформы бывают и как выбрать систему под серверы, сеть и сервисы. Обзор российских решений и внедрение от ОБИТ. ) ) 1 ЧитатьИТ-аутсорсинг
29.04.2026
VDI, или виртуальные рабочие места: что это, как работает технология и кому она подходит
Array
(
[ID] => 3368
[~ID] => 3368
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 111
[~IBLOCK_SECTION_ID] => 111
[NAME] => VDI, или виртуальные рабочие места: что это, как работает технология и кому она подходит
[~NAME] => VDI, или виртуальные рабочие места: что это, как работает технология и кому она подходит
[ACTIVE_FROM_X] => 2026-04-29 00:00:00
[~ACTIVE_FROM_X] => 2026-04-29 00:00:00
[ACTIVE_FROM] => 29.04.2026
[~ACTIVE_FROM] => 29.04.2026
[TIMESTAMP_X] => 25.08.2026 15:14:41
[~TIMESTAMP_X] => 25.08.2026 15:14:41
[DETAIL_PAGE_URL] => /blog/oblachnye-resheniya/vdi-ili-virtualnye-rabochie-mesta/
[~DETAIL_PAGE_URL] => /blog/oblachnye-resheniya/vdi-ili-virtualnye-rabochie-mesta/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] =>
VDI — это способ организовать рабочее место сотрудника не на офисном компьютере, а в серверной или облачной среде. Пользователь видит привычный рабочий стол, открывает файлы и приложения, но вычисления, данные и администрирование остаются в централизованном контуре.
Для бизнеса VDI — не только удобный доступ через интернет. Технология меняет подход к управлению рабочими местами: ускоряет подключение филиалов и удалённых сотрудников, снижает зависимость от пользовательских устройств, упрощает обновления и делает контроль доступа более предсказуемым.
VDI редко внедряют как изолированное решение. Чаще это часть облачной инфраструктуры и общей модели эксплуатации ИТ-сервисов. Поэтому важно понимать не только базовый принцип, но и ограничения, требования к инфраструктуре и логику выбора.
Что такое VDI
VDI, или Virtual Desktop Infrastructure, — это инфраструктура виртуальных рабочих столов. Рабочее место сотрудника запускается на серверной площадке, а пользователь подключается к нему с ноутбука, офисного ПК, тонкого клиента или личного устройства.
Снаружи это выглядит как обычный компьютер: тот же интерфейс операционной системы, те же приложения, те же документы. Разница в том, что конечное устройство становится точкой доступа, а сама рабочая среда находится в центре обработки данных или в облаке.
Важно не путать VDI с отдельной программой удалённого доступа. VDI — это не один сервис и не одна кнопка «подключиться», а целая архитектура: вычислительные ресурсы, система хранения, управление образами, доступами, сессиями, резервированием и мониторингом. Чтобы понять, где у такой схемы сильные стороны, нужно посмотреть, как она устроена на практике.
Как работает технология VDI
Базовый принцип VDI в том, что рабочая среда отделяется от конкретного устройства и переносится на централизованные ресурсы. Пользователь работает с удалённым рабочим столом, а его действия передаются в серверную среду, где и выполняются приложения.
В рабочем контуре VDI обычно есть несколько обязательных компонентов:
-
Платформа виртуализации, на которой запускаются рабочие столы и распределяются процессор, память, диски и при необходимости графические ресурсы
-
Образы рабочих столов с операционной системой, настройками и набором программ
-
Брокер подключений, который определяет, к какому рабочему столу подключить пользователя, и проверяет права доступа
-
Хранилище пользовательских профилей, документов и служебных данных
-
Контур безопасности с учётными записями, многофакторной аутентификацией, журналами событий, резервным копированием и административным контролем
Когда сотрудник входит в систему, брокер подключений выдаёт ему нужную среду. Между устройством и серверной площадкой в основном передаются изображение экрана, ввод с клавиатуры и мыши, а в ряде сценариев — ещё и данные периферии.
Поэтому выражение «VDI-сервер» в реальной эксплуатации обычно означает не один сервер, а набор взаимосвязанных компонентов. От их согласованной работы зависят производительность, доступность и удобство для пользователя.
Персональные и неперсональные рабочие столы
Обычно VDI строят по одной из двух моделей.
Персональный рабочий стол закреплён за конкретным сотрудником. Такой подход подходит там, где важны индивидуальные настройки, постоянная среда, особый набор приложений или расширенные права.
Неперсональный рабочий стол выдаётся из общего пула на время сессии. После завершения работы среда сбрасывается или пересобирается. Этот подход проще сопровождать, легче масштабировать и удобнее использовать для типовых офисных ролей, сменной работы и больших групп со стандартным набором приложений.
Выбор между этими моделями влияет на стоимость, сопровождение и пользовательский опыт. Отсюда следующий практический вопрос: в каких задачах бизнес действительно получает от VDI ощутимый эффект.
Зачем бизнесу виртуальное рабочее место
Главная ценность VDI — централизованное управление рабочими местами без жёсткой привязки к конкретному устройству. Это особенно заметно в распределённых компаниях, где сотрудники работают из разных офисов, из дома или подключаются как внешние исполнители.
Первый типовой сценарий — филиалы и удалённые команды. В такой модели проще выдавать доступ, подключать новых сотрудников и закрывать учётные записи после завершения проекта. Это быстрее и управляемее, чем каждый раз закупать, настраивать и доставлять отдельное устройство.
Второй сценарий — стандартизированные рабочие места. Если сотни сотрудников работают в одних и тех же системах, централизованные образы упрощают обновления, снижают число расхождений в настройках и уменьшают нагрузку на ИТ-команду.
Третий сценарий — повышенные требования к защите данных. VDI не заменяет полноценную информационную безопасность, но сокращает объём данных на конечных устройствах и упрощает контроль доступа, действий пользователей и административных полномочий. Для компаний с чувствительной информацией это часто важнее, чем сам факт удалённой работы.
Четвёртый сценарий — продление срока службы пользовательского оборудования. Если основные вычисления выполняются в центре обработки данных, требования к конечным устройствам обычно снижаются. Это не значит, что подойдёт любой старый компьютер, но парк рабочих мест действительно можно обновлять менее жёстко.
Есть и ещё один прикладной сценарий для российского рынка: пилоты по переходу на отечественное офисное программное обеспечение. В VDI удобнее тестировать совместимость документов, нагрузку на поддержку и пользовательские сценарии на ограниченной группе, не переводя сразу всю компанию. Но полезность технологии зависит от того, насколько профиль компании ей подходит.
Кому подходит VDI, а кому нет
Лучше всего VDI подходит компаниям, у которых есть хотя бы часть таких признаков: распределённая структура, филиалы, подрядчики, временные сотрудники, типовые рабочие места, высокие требования к управляемости и потребность быстро выдавать и отзывать доступ.
Чаще всего технология хорошо работает в контакт-центрах, административных подразделениях, бухгалтерии, службах поддержки, операционных командах и других ролях со стандартным набором приложений и предсказуемой нагрузкой. Там выигрыш в эксплуатации обычно выше, чем неудобства от перехода на новую модель.
VDI также полезен в сценариях, где важна изоляция среды. Это может быть доступ для внешних специалистов, стажёров, временных проектных команд или сотрудников, которые работают вне офиса, но должны использовать внутренние системы компании.
Но универсальным решением VDI не является. Осторожнее стоит подходить к проекту, если сотрудники часто работают без стабильного канала связи, используют специфическую локальную периферию, зависят от нестандартных USB-устройств или постоянно работают в тяжёлых графических приложениях. В таких случаях качество пользовательского опыта и экономика проекта зависят от точного подбора конфигурации, а ошибки в расчётах быстро становятся заметны.
Есть и ограничение по масштабу. Для небольшой команды с разнородными задачами и редким удалённым доступом полноценная VDI-инфраструктура может оказаться сложнее и дороже, чем более простой сценарий с обычными рабочими станциями и адресным удалённым доступом. Поэтому следующий шаг — выбрать модель поставки.
Своя инфраструктура или услуга
Здесь важно развести два понятия. VDI — это технология. DaaS, или Desktop as a Service, — это модель услуги, когда провайдер предоставляет виртуальные рабочие места в аренду. Иначе говоря, аренда виртуальных рабочих мест — это способ потреблять VDI без необходимости строить и сопровождать всю платформу самостоятельно.
Собственная инфраструктура обычно нужна там, где критичны полный контроль над архитектурой, нестандартные интеграции, особые требования к размещению данных или уже есть команда, способная поддерживать платформу виртуализации, хранилище, сетевой контур и средства защиты.
Модель услуги чаще выбирают компании, которым важны быстрый запуск, предсказуемые операционные расходы, понятный SLA и разграничение ответственности по договору. Для бизнеса это часто рациональнее, если цель — получить рабочие места и понятный сервис, а не разворачивать ещё один сложный ИТ-контур своими силами.
Независимо от модели, зоны ответственности лучше разделить заранее. Как правило, их удобно раскладывать по четырём слоям: платформа виртуализации, гостевые операционные системы и приложения, учётные записи и доступы, данные и резервное копирование. Если это не определить в начале, спор о причинах инцидента почти неизбежен. Чтобы избежать таких ситуаций, до старта проекта нужно проверить исходные условия.
Что проверить до запуска
Большинство проблем в проектах VDI связано не с самой технологией, а с неверными исходными допущениями. Поэтому до закупки или аренды ресурсов полезно собрать минимальный набор фактов.
-
какие группы пользователей будут работать в системе и как отличаются их профили нагрузки
-
какие приложения критичны для бизнеса, как они лицензируются и поддерживаются ли в виртуальной среде
-
нужны ли голос, видео, печать, сканеры, токены, USB-устройства, графическое ускорение и другие нестандартные сценарии
-
где будут храниться профили, документы и служебные данные
-
как будет работать резервное копирование и восстановление
-
хватает ли качества связи в офисах и у удалённых сотрудников
-
кто и как будет администрировать платформу, включая привилегированный доступ
Если по сети, приложениям и ролям пользователей нет объективной картины, лучше начать с аудита ИТ-инфраструктуры. Это дешевле, чем переделывать архитектуру после пилота или объяснять пользователям, почему часть сценариев не работает в эксплуатации.
Читайте также
Превентивная диагностика: когда и зачем нужен ИТ-аудит?
Что чаще всего ломает проект VDI
|
Риск |
Как проявляется |
Что делать |
|
Одна конфигурация для всех |
Одним сотрудникам не хватает ресурсов, другим компания переплачивает за избыточную мощность |
Разделить пользователей по профилям нагрузки до пилота |
|
Не проверили каналы связи |
Задержки, нестабильные сессии, плохое качество голоса и видео |
Измерить качество связи и протестировать реальные сценарии на площадках |
|
Безопасность подключили в конце |
Избыточные права, слабый контроль администраторов, неясные зоны ответственности |
Сразу проектировать роли, аутентификацию, журналы действий и защиту административного контура |
|
Не учли лицензии и периферию |
Пилот проходит, а при тиражировании возникают проблемы с печатью, токенами, сканерами или ограничениями ПО |
Проверять совместимость до запуска в промышленную эксплуатацию |
Когда исходные условия собраны, можно переходить к пилоту и проектированию целевой схемы.
Как обычно внедряют VDI
В проектах VDI лучше идти поэтапно. Массовый запуск без промежуточной проверки почти всегда дороже, чем короткий, но репрезентативный пилот.
-
Определяют цели проекта и сегменты пользователей. На этом этапе важно понять, кого переводят в VDI в первую очередь и какой эффект ожидают получить.
-
Собирают требования к приложениям, доступам, периферии, отказоустойчивости и поддержке.
-
Запускают пилот на репрезентативной группе пользователей. Проверять нужно не только вход в систему, но и реальные рабочие сценарии: документы, звонки, печать, обмен файлами, работу в пиковые часы и восстановление после сбоев.
-
По итогам пилота утверждают целевую архитектуру, правила масштабирования, резервного копирования и сопровождения.
-
После этого переходят к поэтапному тиражированию и эксплуатации.
Такой маршрут выглядит длиннее, но на практике именно он быстрее приводит к стабильной работе. После пилота уже можно предметно считать экономику.
От чего зависит стоимость VDI и где искать эффект
На вопрос «VDI дешевле или дороже обычных ПК» нет универсального ответа. Корректнее говорить, что технология меняет структуру затрат: часть капитальных расходов на парк рабочих мест и локальную инфраструктуру смещается в расходы на централизованные мощности, сопровождение, лицензии и сервис.
На стоимость влияют профиль пользователей, тип рабочих столов, объём вычислительных и дисковых ресурсов, потребность в графическом ускорении, требования к отказоустойчивости, глубина поддержки, меры защиты, объём хранилища и сроки хранения резервных копий. Чем больше персонализации и нестандартных сценариев, тем дороже одно рабочее место.
Экономический эффект обычно складывается из нескольких факторов: меньше ручной поддержки на местах, быстрее выдача и отзыв доступа, более предсказуемые обновления, мягче требования к части конечных устройств, проще подключение временной команды и замена сотрудника. Но считать стоит не только прямую экономию, а ещё и управляемость, снижение операционных рисков и скорость масштабирования.
Есть и обратная сторона. Для тяжёлых графических профилей, круглосуточной нагрузки, множества исключений и сложной периферии VDI может быть не инструментом экономии, а способом купить управляемость и контроль. Это тоже нормальный результат, если бизнес понимает, за что платит и какой эффект ожидает получить.
Что важно запомнить
VDI — это способ централизованно организовать рабочие места сотрудников и упростить управление доступом, приложениями и данными. Такой подход особенно полезен компаниям с филиалами, удалёнными командами, подрядчиками и типовыми рабочими местами, где важны единые настройки, безопасность и быстрое подключение пользователей.
Но VDI даёт эффект только в том случае, если перед запуском оценили реальные задачи бизнеса, требования к приложениям, качество связи, работу периферии и порядок поддержки. Поэтому внедрение лучше начинать не с выбора платформы, а с пилота и расчёта подходящей модели для вашей компании.
Если вы планируете внедрить виртуальные рабочие места, специалисты ОБИТ помогут оценить сценарии использования, подобрать подходящую модель и рассчитать конфигурацию под задачи бизнеса. Оставьте заявку, и мы предложим решение с учётом вашей инфраструктуры, требований к безопасности и нагрузки.
Часто задаваемые вопросы (FAQ)
-
VDI и удалённый рабочий стол — это одно и то же?Нет. Удалённый рабочий стол — это общий способ подключения к удалённой среде. VDI — это архитектура, в которой рабочие места централизованно развёрнуты, управляются и защищаются как отдельный инфраструктурный контур.
-
Что называют VDI-сервером?В разговорной речи так часто называют всю серверную часть решения. На практике это не один сервер, а совокупность вычислительных ресурсов, хранилища, брокера подключений, сетевого и защитного контура.
-
Можно ли подключаться к VDI с личного ноутбука?Да, во многих сценариях это штатный подход. Но его нужно отдельно проектировать с точки зрения аутентификации, политик доступа и требований к конечной точке.
-
Насколько безопасен VDI?Сам по себе VDI не повышает и не снижает безопасность автоматически. Его сильная сторона в другом: рабочие столы, данные и доступы можно централизованно контролировать, а значит, проще применять единые политики, многофакторную аутентификацию и журналирование действий. Риски обычно связаны не с технологией, а с ошибками в настройке доступа, сетевого контура и административных прав.
-
Какие ограничения и недостатки есть у VDI?У VDI есть понятные ограничения. Во-первых, качество работы напрямую зависит от канала связи и задержки. Во-вторых, для нормальной производительности нужно точно рассчитывать ресурсы под разные группы пользователей. В-третьих, сценарии с тяжёлыми приложениями, нестандартной периферией и отдельными USB-устройствами часто требуют дополнительной настройки и проверки ещё на этапе пилота.
-
Подходит ли VDI для малого бизнеса?Подходит, если у компании есть распределённые сотрудники, чувствительные данные, потребность в централизованном управлении или частая смена персонала и подрядчиков. Если команда небольшая, задачи сильно различаются, а удалённый доступ нужен редко, решение может оказаться избыточным.
-
Что обязательно проверить перед внедрением?Состав приложений, роли пользователей, качество каналов связи, поддержку периферии, схему резервного копирования, модель администрирования и требования безопасности. Без этого даже технически корректная платформа может оказаться неудобной для бизнеса.
Облачные решения
04.03.2026
Автоматизация бизнес-процессов: инструменты и этапы внедрения
Array
(
[ID] => 3279
[~ID] => 3279
[IBLOCK_ID] => 36
[~IBLOCK_ID] => 36
[IBLOCK_SECTION_ID] => 102
[~IBLOCK_SECTION_ID] => 102
[NAME] => Автоматизация бизнес-процессов: инструменты и этапы внедрения
[~NAME] => Автоматизация бизнес-процессов: инструменты и этапы внедрения
[ACTIVE_FROM_X] => 2026-03-04 00:00:00
[~ACTIVE_FROM_X] => 2026-03-04 00:00:00
[ACTIVE_FROM] => 04.03.2026
[~ACTIVE_FROM] => 04.03.2026
[TIMESTAMP_X] => 25.08.2026 15:20:46
[~TIMESTAMP_X] => 25.08.2026 15:20:46
[DETAIL_PAGE_URL] => /blog/avtomatizatsiya-biznesa/avtomatizatsiya-biznes-protsessov/
[~DETAIL_PAGE_URL] => /blog/avtomatizatsiya-biznesa/avtomatizatsiya-biznes-protsessov/
[LIST_PAGE_URL] => /blog/
[~LIST_PAGE_URL] => /blog/
[DETAIL_TEXT] => Автоматизация
бизнес-процессов помогает убрать ручные операции там, где они создают задержки, ошибки и
«невидимую» нагрузку на сотрудников. Для бизнеса это обычно про скорость выполнения работ, управляемость
и прогнозируемость результата. Для ИТ и ИБ это про корректную архитектуру, интеграции, доступы и контроль изменений.
В этой статье разберём, что именно считать автоматизацией, в каких ситуациях она действительно оправдана,
какие процессы выбирать первыми и какие инструменты для этого используют. Отдельно дадим практичный план: с чего
начать, что запросить у подрядчика, какие риски и типичные ошибки встречаются чаще всего.
Материал будет полезен, если вы планируете автоматизацию управленческих бизнес-процессов, клиентских
сценариев или внутренних операций и хотите заранее понимать, где будет эффект, а где проект может
«застрять» из-за данных, интеграций и ответственности.
В каких ситуациях автоматизация действительно оправдана
Автоматизация даёт результат там, где есть повторяемость, правила и понятный «выход» процесса.
Обычно повод выглядит так.
- Согласования и поручения растягиваются, потому что нет прозрачного статуса и
сроков.
- Ошибки из-за ручного ввода и переносов между таблицами и системами стали
регулярными.
- Заявки приходят из разных каналов, но нет единого учёта, очереди и контроля
сроков ответа.
- Процесс держится на конкретных людях, знания живут в переписках и личных
файлах.
- Нужна доказуемость: история согласований, журнал действий, единые маршруты,
контроль доступа.
Если у вас совпало хотя бы 2–3 пункта, автоматизация обычно даёт быстрый эффект. Следующий практический вопрос
— что автоматизировать первым, чтобы не распылиться.
Какие процессы автоматизировать в первую очередь
Приоритет лучше определять не «по важности», а по сочетанию эффекта и реализуемости. На старте
хорошо работают процессы, которые одновременно:
- часто повторяются;
- занимают заметное время у сотрудников;
- дают ошибки при ручной работе;
- имеют понятные правила и статусы;
- завязаны на клиентский опыт или деньги.
Типовые кандидаты на первый контур:
- клиентские обращения и заявки: регистрация, маршрутизация, контроль сроков, уведомления;
- управленческие согласования: закупки, поручения, заявки на изменения, бюджетные лимиты;
- документооборот: договоры, акты, кадровые документы, версии, статусы, согласование;
- финансы и контроль: сверки, реестры, дебиторская задолженность, закрытие периода.
Если процесс невозможно описать так, чтобы два разных сотрудника выполнили его одинаково, автоматизацию лучше начинать с упорядочивания правил и данных. Когда приоритет понятен, можно выбирать инструменты.
Технологии автоматизации бизнес-процессов: какие инструменты используют и что они делают
В реальных проектах почти всегда используется связка классов решений. Попытка закрыть документы, заявки, интеграции и аналитику одной «универсальной платформой» часто приводит к дорогим доработкам и сложной эксплуатации.
Ниже — практическая карта инструментов.
| Инструмент или класс решений | Что делает на практике | Типовой эффект | Что важно проверить до внедрения |
| BPM и workflow платформы | Управляют маршрутом задач: кто делает шаг, сроки, условия переходов, возвраты, эскалации | Прозрачные статусы, контроль сроков, единые правила | Владелец процесса, регламенты, роли, список исключений |
| Электронный документооборот | Хранение, версии, согласования, подписание, статусы документов | Сокращение цикла по договорам и актам, меньше потерь и «финальных версий» | Маршруты согласования, требования к хранению, права доступа, юридически значимые действия |
| CRM и сервисные системы заявок | Единый учёт обращений, очереди, категории, SLA, коммуникации, история | Меньше потерянных заявок, управляемые сроки ответа | Каналы входа, маршрутизация, база знаний, отчётность, интеграции |
| ERP и учётные системы | Сквозной учёт: финансы, закупки, склад, производство, планирование | Единые справочники, меньше ручных сверок, управляемость затрат | Качество справочников, источники данных, границы ответственности между системами |
| Интеграционные платформы и iPaaS | Обмен данными и событиями между системами, синхронизация статусов и справочников | Уходят ручные переносы, снижаются ошибки на стыках | Карта интеграций, «источник истины» по данным, мониторинг обмена, обработка ошибок |
| RPA роботизация | Повторяет действия пользователя в интерфейсах, когда нет API или интеграция сложна | Быстро снимает рутину в наследуемых системах | Стабильность интерфейсов, контроль ошибок робота, регламент сопровождения |
| Process mining и аналитика процессов | По журналам событий показывает реальную картину, отклонения, узкие места | Автоматизируют то, что реально происходит, а не то, что «на бумаге» | Наличие логов, корректные статусы и метки времени, единые трактовки метрик |
| ИИ в автоматизации | Классификация обращений, извлечение данных из документов, подсказки, ответы на типовые вопросы | Меньше ручной обработки текста и документов, быстрее реакция | Качество данных, контроль качества, разграничение доступа к данным |
Пример: как собрать «сквозной» процесс на практике
Сценарий: согласование закупки с контролем бюджета и документов.
- Заявка создаётся в сервисной системе или в форме workflow и сразу получает статус и ответственного.
- BPM или workflow ведёт маршрут согласований: руководитель, финансы, служба безопасности, закупки. Система ставит сроки и эскалации.
- Электронный документооборот хранит коммерческие предложения, договор, приложения, фиксирует версии и согласование.
- ERP проверяет лимиты бюджета и проводит закупочную операцию после утверждения.
- Интеграция синхронизирует статусы и ключевые поля между системами, чтобы не было ручного дублирования.
- Если часть действий живёт в старом интерфейсе без API, точечно подключают RPA для рутинного переноса данных.
- Для контроля улучшений используют аналитику процесса: где «зависают» согласования, сколько возвратов, кто перегружен.
- ИИ применяют точечно: извлечение реквизитов из КП и счетов, первичная классификация обращений, подсказки по заполнению.
Этот пример показывает главное: «правильность» автоматизации часто определяется тем, где вы строите маршрут и как обеспечиваете стыки между системами. Чтобы не ошибиться с масштабом, полезно выбрать подходящий уровень автоматизации.
Этапы автоматизации бизнес-процессов: от цели до устойчивой эксплуатации
Ниже — компактная схема, которая работает и для офисных процессов, и для клиентских сценариев. Логика простая: на каждом шаге должен появляться понятный результат, который можно проверить.
1) Цель и KPI
Фиксируете цель процесса для бизнеса и что считается успехом. Определяете границы: старт, финиш, участники, используемые системы. Выбираете 3–5 метрик, которые реально измерить до и после.
Результат шага: короткая карточка цели, границ и метрик.
Мостик: без этого описание процесса будет «у каждого своё», и проект начнёт спорить сам с собой.
2) Анализ текущего процесса
Собираете реальные шаги, роли, документы, исключения и проблемы. Отдельно фиксируете данные: откуда берутся, где теряются, где дублируются.
Результат шага: схема шагов, список исключений, перечень данных и документов.
Мостик: дальше можно улучшать процесс, а не переносить текущие обходы в систему.
3) Проект целевого процесса
Убираете лишние согласования, вводите статусы и правила, определяете точки контроля. Фиксируете, что делает система автоматически, а где остаётся человек и почему.
Результат шага: целевой маршрут, статусы, сроки на шаг, правила возврата и эскалации.
Мостик: теперь можно осмысленно выбирать класс решения, а не «по витрине функций».
4) Выбор решения и архитектуры
Решаете, что закрывается workflow или BPM, что уходит в документооборот, где нужна интеграция, где допустима роботизация. Параллельно фиксируете требования к доступности, резервному копированию, доступам и журналированию.
Результат шага: целевая схема систем и интеграций, список требований ИТ и ИБ.
Мостик: следующий риск — попасть в долгую разработку. Его снимает пилот.
5) Пилот и проверка эффекта
Запускаете один процесс или один участок, но с заранее заданными критериями. Проверяете маршруты, качество данных, стыки, нагрузку, удобство и регламенты поддержки.
Результат шага: решение «масштабируем или меняем», список доработок, уточнённая оценка сроков и
бюджета.
Мостик: дальше важна поэтапность, иначе контур будет тяжело запускать и поддерживать.
6) Внедрение по этапам и интеграции
Вводите контур частями, начиная с критичных шагов. Отдельно планируете миграцию данных, выравнивание справочников и мониторинг интеграций.
Результат шага: работающий контур, мониторинг стыков, понятная схема поддержки.
Мостик: если пользователи продолжают работать «в обход», эффект не закрепится. Значит, нужен управляемый
запуск.
7) Обучение и управление изменениями
Обучение должно отвечать на практические вопросы: как работать, что делать при ошибке, кто решает спорные ситуации, как оформлять исключение. Назначаются владельцы процесса и ответственные за изменения.
Результат шага: инструкции, правила обработки исключений, закреплённые роли.
Мостик: теперь можно считать эффект и управлять развитием, а не «тушить пожары».
8) Поддержка и улучшения
Вводите регулярный цикл улучшений: метрики, разбор узких мест, план изменений, релизы, контроль доступа и журналов.
Результат шага: процесс работает устойчиво и улучшается по данным, а не по ощущениям.
Мостик: чтобы это стало возможным, систему или сервис нужно выбрать правильно, а не только по списку критериев.
Типичные ошибки при автоматизации бизнес-процессов и как их избежать
| Риск | Как проявляется | Что сделать заранее |
| Автоматизация неописанного процесса | Рост исключений и доработок, спор требований | Зафиксировать «как есть», правила, исключения, «как должно быть» |
| Нет владельца процесса | Некому принимать решения по изменениям | Назначить владельца, закрепить метрики и полномочия |
| Плохое качество данных | Расхождение статусов, недостоверные отчёты | Определить источники данных, правила качества, единые справочники |
| Недооценка интеграций | Ручное дублирование, «полуавтоматизация» | Карта систем и данных, мониторинг обмена, ответственность за стыки |
| Слабое управление доступами | Лишние права, сложно расследовать инциденты | Ролевая модель, журналирование, регулярный пересмотр прав |
| Нет поддержки запуска | Пользователи обходят систему | Обучение, инструкции, правила обработки исключений |
| Попытка сделать всё сразу | Долгий проект без эффекта | Минимально полезный контур, пилот, поэтапное масштабирование |
Итоги
Автоматизация бизнес-процессов даёт эффект, когда опирается на понятные цели, владельцев процессов, описанные правила, качественные данные и измеримые показатели. Типовой путь выглядит так: выбрать приоритетные процессы, описать «как есть», спроектировать «как должно быть», подобрать подход и класс решений, сделать пилот, внедрить поэтапно и дальше улучшать на основе данных.
Если вы планируете проект автоматизации и хотите снизить риски на старте, практичный шаг — предпроектное обследование: зафиксировать процессы, интеграции, требования к доступности и безопасности, а затем собрать реалистичный план внедрения. Это можно обсудить с командой «ОБИТ» в формате консультации и подготовки дорожной карты.
Часто задаваемые вопросы (FAQ)
-
Можно ли автоматизировать процесс, если он постоянно меняется?Можно, но начинать стоит с фиксации стабильного «ядра» процесса: статусы, роли, минимальные правила. Меняющиеся части лучше оформлять как управляемые исключения и изменения через владельца процесса, иначе автоматизация превратится в бесконечные доработки.
-
Нужен ли владелец процесса и кто это должен быть?Нужен почти всегда. Это не роль ИТ. Владелец процесса должен быть со стороны бизнеса и иметь право менять правила, принимать компромиссы и отвечать за метрики результата.
-
Как не получить «полуавтоматизацию» с ручным дублированием?Заранее определить, где живёт «источник истины» по каждому типу данных, и синхронизировать статусы между системами. Если это не сделать, сотрудники начнут вручную выравнивать данные, и эффект исчезнет.
-
Как проверить, что решение соответствует требованиям ИБ?На пилоте проверить ролевую модель, журналирование, разделение прав, управление изменениями, требования к размещению и хранению данных. Важно, чтобы ответственность за доступы и аудит была определена до запуска, а не «по факту инцидента».
-
Реально ли обойтись без доработок?Да, в случае с простыми процессами в небольших компаниях. Но интеграции, сложные правила, нестандартные роли и требования ИБ часто требуют точечных доработок. Практичнее учитывать их.
-
Сколько обычно занимает пилот и что считать успешным пилотом?Пилот имеет смысл ограничивать одним процессом и заранее фиксировать 3–5 критериев успеха: достижение целевых сроков на шагах, корректность статусов, устойчивость интеграций, управляемость доступов, готовность поддержки. Без критериев пилот превращается в демонстрацию.
-
Как понять, что ИИ в процессе действительно нужен?Если существенная доля времени уходит на обработку текста и документов, а качество данных позволяет контролировать результат. ИИ лучше внедрять после того, как процесс и данные уже приведены к базовому порядку, иначе будет сложно объяснить, что именно улучшилось и почему.
Автоматизация бизнес-процессов помогает убрать ручные операции там, где они создают задержки, ошибки и «невидимую» нагрузку на сотрудников. Для бизнеса это обычно про скорость выполнения работ, управляемость и прогнозируемость результата. Для ИТ и ИБ это про корректную архитектуру, интеграции, доступы и контроль изменений.
В этой статье разберём, что именно считать автоматизацией, в каких ситуациях она действительно оправдана, какие процессы выбирать первыми и какие инструменты для этого используют. Отдельно дадим практичный план: с чего начать, что запросить у подрядчика, какие риски и типичные ошибки встречаются чаще всего.
Материал будет полезен, если вы планируете автоматизацию управленческих бизнес-процессов, клиентских сценариев или внутренних операций и хотите заранее понимать, где будет эффект, а где проект может «застрять» из-за данных, интеграций и ответственности.
В каких ситуациях автоматизация действительно оправдана
Автоматизация даёт результат там, где есть повторяемость, правила и понятный «выход» процесса. Обычно повод выглядит так.
- Согласования и поручения растягиваются, потому что нет прозрачного статуса и сроков.
- Ошибки из-за ручного ввода и переносов между таблицами и системами стали регулярными.
- Заявки приходят из разных каналов, но нет единого учёта, очереди и контроля сроков ответа.
- Процесс держится на конкретных людях, знания живут в переписках и личных файлах.
- Нужна доказуемость: история согласований, журнал действий, единые маршруты, контроль доступа.
Если у вас совпало хотя бы 2–3 пункта, автоматизация обычно даёт быстрый эффект. Следующий практический вопрос — что автоматизировать первым, чтобы не распылиться.
Какие процессы автоматизировать в первую очередь
Приоритет лучше определять не «по важности», а по сочетанию эффекта и реализуемости. На старте хорошо работают процессы, которые одновременно:
- часто повторяются;
- занимают заметное время у сотрудников;
- дают ошибки при ручной работе;
- имеют понятные правила и статусы;
- завязаны на клиентский опыт или деньги.
Типовые кандидаты на первый контур:
- клиентские обращения и заявки: регистрация, маршрутизация, контроль сроков, уведомления;
- управленческие согласования: закупки, поручения, заявки на изменения, бюджетные лимиты;
- документооборот: договоры, акты, кадровые документы, версии, статусы, согласование;
- финансы и контроль: сверки, реестры, дебиторская задолженность, закрытие периода.
Если процесс невозможно описать так, чтобы два разных сотрудника выполнили его одинаково, автоматизацию лучше начинать с упорядочивания правил и данных. Когда приоритет понятен, можно выбирать инструменты.
Технологии автоматизации бизнес-процессов: какие инструменты используют и что они делают
В реальных проектах почти всегда используется связка классов решений. Попытка закрыть документы, заявки, интеграции и аналитику одной «универсальной платформой» часто приводит к дорогим доработкам и сложной эксплуатации.
Ниже — практическая карта инструментов.
| Инструмент или класс решений | Что делает на практике | Типовой эффект | Что важно проверить до внедрения |
| BPM и workflow платформы | Управляют маршрутом задач: кто делает шаг, сроки, условия переходов, возвраты, эскалации | Прозрачные статусы, контроль сроков, единые правила | Владелец процесса, регламенты, роли, список исключений |
| Электронный документооборот | Хранение, версии, согласования, подписание, статусы документов | Сокращение цикла по договорам и актам, меньше потерь и «финальных версий» | Маршруты согласования, требования к хранению, права доступа, юридически значимые действия |
| CRM и сервисные системы заявок | Единый учёт обращений, очереди, категории, SLA, коммуникации, история | Меньше потерянных заявок, управляемые сроки ответа | Каналы входа, маршрутизация, база знаний, отчётность, интеграции |
| ERP и учётные системы | Сквозной учёт: финансы, закупки, склад, производство, планирование | Единые справочники, меньше ручных сверок, управляемость затрат | Качество справочников, источники данных, границы ответственности между системами |
| Интеграционные платформы и iPaaS | Обмен данными и событиями между системами, синхронизация статусов и справочников | Уходят ручные переносы, снижаются ошибки на стыках | Карта интеграций, «источник истины» по данным, мониторинг обмена, обработка ошибок |
| RPA роботизация | Повторяет действия пользователя в интерфейсах, когда нет API или интеграция сложна | Быстро снимает рутину в наследуемых системах | Стабильность интерфейсов, контроль ошибок робота, регламент сопровождения |
| Process mining и аналитика процессов | По журналам событий показывает реальную картину, отклонения, узкие места | Автоматизируют то, что реально происходит, а не то, что «на бумаге» | Наличие логов, корректные статусы и метки времени, единые трактовки метрик |
| ИИ в автоматизации | Классификация обращений, извлечение данных из документов, подсказки, ответы на типовые вопросы | Меньше ручной обработки текста и документов, быстрее реакция | Качество данных, контроль качества, разграничение доступа к данным |
Пример: как собрать «сквозной» процесс на практике
Сценарий: согласование закупки с контролем бюджета и документов.
- Заявка создаётся в сервисной системе или в форме workflow и сразу получает статус и ответственного.
- BPM или workflow ведёт маршрут согласований: руководитель, финансы, служба безопасности, закупки. Система ставит сроки и эскалации.
- Электронный документооборот хранит коммерческие предложения, договор, приложения, фиксирует версии и согласование.
- ERP проверяет лимиты бюджета и проводит закупочную операцию после утверждения.
- Интеграция синхронизирует статусы и ключевые поля между системами, чтобы не было ручного дублирования.
- Если часть действий живёт в старом интерфейсе без API, точечно подключают RPA для рутинного переноса данных.
- Для контроля улучшений используют аналитику процесса: где «зависают» согласования, сколько возвратов, кто перегружен.
- ИИ применяют точечно: извлечение реквизитов из КП и счетов, первичная классификация обращений, подсказки по заполнению.
Этот пример показывает главное: «правильность» автоматизации часто определяется тем, где вы строите маршрут и как обеспечиваете стыки между системами. Чтобы не ошибиться с масштабом, полезно выбрать подходящий уровень автоматизации.
Этапы автоматизации бизнес-процессов: от цели до устойчивой эксплуатации
Ниже — компактная схема, которая работает и для офисных процессов, и для клиентских сценариев. Логика простая: на каждом шаге должен появляться понятный результат, который можно проверить.
1) Цель и KPI
Фиксируете цель процесса для бизнеса и что считается успехом. Определяете границы: старт, финиш, участники, используемые системы. Выбираете 3–5 метрик, которые реально измерить до и после.
Результат шага: короткая карточка цели, границ и метрик.
Мостик: без этого описание процесса будет «у каждого своё», и проект начнёт спорить сам с собой.
2) Анализ текущего процесса
Собираете реальные шаги, роли, документы, исключения и проблемы. Отдельно фиксируете данные: откуда берутся, где теряются, где дублируются.
Результат шага: схема шагов, список исключений, перечень данных и документов.
Мостик: дальше можно улучшать процесс, а не переносить текущие обходы в систему.
3) Проект целевого процесса
Убираете лишние согласования, вводите статусы и правила, определяете точки контроля. Фиксируете, что делает система автоматически, а где остаётся человек и почему.
Результат шага: целевой маршрут, статусы, сроки на шаг, правила возврата и эскалации.
Мостик: теперь можно осмысленно выбирать класс решения, а не «по витрине функций».
4) Выбор решения и архитектуры
Решаете, что закрывается workflow или BPM, что уходит в документооборот, где нужна интеграция, где допустима роботизация. Параллельно фиксируете требования к доступности, резервному копированию, доступам и журналированию.
Результат шага: целевая схема систем и интеграций, список требований ИТ и ИБ.
Мостик: следующий риск — попасть в долгую разработку. Его снимает пилот.
5) Пилот и проверка эффекта
Запускаете один процесс или один участок, но с заранее заданными критериями. Проверяете маршруты, качество данных, стыки, нагрузку, удобство и регламенты поддержки.
Результат шага: решение «масштабируем или меняем», список доработок, уточнённая оценка сроков и
бюджета.
Мостик: дальше важна поэтапность, иначе контур будет тяжело запускать и поддерживать.
6) Внедрение по этапам и интеграции
Вводите контур частями, начиная с критичных шагов. Отдельно планируете миграцию данных, выравнивание справочников и мониторинг интеграций.
Результат шага: работающий контур, мониторинг стыков, понятная схема поддержки.
Мостик: если пользователи продолжают работать «в обход», эффект не закрепится. Значит, нужен управляемый
запуск.
7) Обучение и управление изменениями
Обучение должно отвечать на практические вопросы: как работать, что делать при ошибке, кто решает спорные ситуации, как оформлять исключение. Назначаются владельцы процесса и ответственные за изменения.
Результат шага: инструкции, правила обработки исключений, закреплённые роли.
Мостик: теперь можно считать эффект и управлять развитием, а не «тушить пожары».
8) Поддержка и улучшения
Вводите регулярный цикл улучшений: метрики, разбор узких мест, план изменений, релизы, контроль доступа и журналов.
Результат шага: процесс работает устойчиво и улучшается по данным, а не по ощущениям.
Мостик: чтобы это стало возможным, систему или сервис нужно выбрать правильно, а не только по списку критериев.
Типичные ошибки при автоматизации бизнес-процессов и как их избежать
| Риск | Как проявляется | Что сделать заранее |
| Автоматизация неописанного процесса | Рост исключений и доработок, спор требований | Зафиксировать «как есть», правила, исключения, «как должно быть» |
| Нет владельца процесса | Некому принимать решения по изменениям | Назначить владельца, закрепить метрики и полномочия |
| Плохое качество данных | Расхождение статусов, недостоверные отчёты | Определить источники данных, правила качества, единые справочники |
| Недооценка интеграций | Ручное дублирование, «полуавтоматизация» | Карта систем и данных, мониторинг обмена, ответственность за стыки |
| Слабое управление доступами | Лишние права, сложно расследовать инциденты | Ролевая модель, журналирование, регулярный пересмотр прав |
| Нет поддержки запуска | Пользователи обходят систему | Обучение, инструкции, правила обработки исключений |
| Попытка сделать всё сразу | Долгий проект без эффекта | Минимально полезный контур, пилот, поэтапное масштабирование |
Итоги
Автоматизация бизнес-процессов даёт эффект, когда опирается на понятные цели, владельцев процессов, описанные правила, качественные данные и измеримые показатели. Типовой путь выглядит так: выбрать приоритетные процессы, описать «как есть», спроектировать «как должно быть», подобрать подход и класс решений, сделать пилот, внедрить поэтапно и дальше улучшать на основе данных.
Если вы планируете проект автоматизации и хотите снизить риски на старте, практичный шаг — предпроектное обследование: зафиксировать процессы, интеграции, требования к доступности и безопасности, а затем собрать реалистичный план внедрения. Это можно обсудить с командой «ОБИТ» в формате консультации и подготовки дорожной карты.
Часто задаваемые вопросы (FAQ)
-
Можно ли автоматизировать процесс, если он постоянно меняется?Можно, но начинать стоит с фиксации стабильного «ядра» процесса: статусы, роли, минимальные правила. Меняющиеся части лучше оформлять как управляемые исключения и изменения через владельца процесса, иначе автоматизация превратится в бесконечные доработки.
-
Нужен ли владелец процесса и кто это должен быть?Нужен почти всегда. Это не роль ИТ. Владелец процесса должен быть со стороны бизнеса и иметь право менять правила, принимать компромиссы и отвечать за метрики результата.
-
Как не получить «полуавтоматизацию» с ручным дублированием?Заранее определить, где живёт «источник истины» по каждому типу данных, и синхронизировать статусы между системами. Если это не сделать, сотрудники начнут вручную выравнивать данные, и эффект исчезнет.
-
Как проверить, что решение соответствует требованиям ИБ?На пилоте проверить ролевую модель, журналирование, разделение прав, управление изменениями, требования к размещению и хранению данных. Важно, чтобы ответственность за доступы и аудит была определена до запуска, а не «по факту инцидента».
-
Реально ли обойтись без доработок?Да, в случае с простыми процессами в небольших компаниях. Но интеграции, сложные правила, нестандартные роли и требования ИБ часто требуют точечных доработок. Практичнее учитывать их.
-
Сколько обычно занимает пилот и что считать успешным пилотом?Пилот имеет смысл ограничивать одним процессом и заранее фиксировать 3–5 критериев успеха: достижение целевых сроков на шагах, корректность статусов, устойчивость интеграций, управляемость доступов, готовность поддержки. Без критериев пилот превращается в демонстрацию.
-
Как понять, что ИИ в процессе действительно нужен?Если существенная доля времени уходит на обработку текста и документов, а качество данных позволяет контролировать результат. ИИ лучше внедрять после того, как процесс и данные уже приведены к базовому порядку, иначе будет сложно объяснить, что именно улучшилось и почему.
Автоматизация бизнеса
30.07.2025
Проблемы выбора ИТ-поставщиков: как найти надежного партнера
Array
(
    [ID] => 2981
    [~ID] => 2981
    [IBLOCK_ID] => 36
    [~IBLOCK_ID] => 36
    [IBLOCK_SECTION_ID] => 101
    [~IBLOCK_SECTION_ID] => 101
    [NAME] => Проблемы выбора ИТ-поставщиков: как найти надежного партнера
    [~NAME] => Проблемы выбора ИТ-поставщиков: как найти надежного партнера
    [ACTIVE_FROM_X] => 2025-07-30 00:00:00
    [~ACTIVE_FROM_X] => 2025-07-30 00:00:00
    [ACTIVE_FROM] => 30.07.2025
    [~ACTIVE_FROM] => 30.07.2025
    [TIMESTAMP_X] => 25.08.2026 15:08:53
    [~TIMESTAMP_X] => 25.08.2026 15:08:53
    [DETAIL_PAGE_URL] => /blog/it-autsorsing/problemy-vybora-it-postavshchikov-kak-nayti-nadezhnogo-partnera/
    [~DETAIL_PAGE_URL] => /blog/it-autsorsing/problemy-vybora-it-postavshchikov-kak-nayti-nadezhnogo-partnera/
    [LIST_PAGE_URL] => /blog/
    [~LIST_PAGE_URL] => /blog/
    [DETAIL_TEXT] =>
Проблемы выбора ИТ-поставщиков: как найти надежного партнера

	 Спрос на комплексные ИТ-проекты для бизнеса вырос в 2,5 раза только за первое полугодие 2025 года. При этом мы подсчитали, что почти половина внедрений проходит неудачно. Каждая вторая компания вынуждена дорабатывать решения после предыдущих поставщиков или реализовывать проект заново.


	 Как не попасть в эту печальную статистику? Установить сотрудничество с ИТ-подрядчиком, который станет драйвером развития, а не опасным элементом для вашего бизнеса.


	 В новой статье разберем, как не попасть в ловушку пустых обещаний и найти честного ИТ-партнера.


Чем опасен неправильный выбор?

	 Передать работу над информационной системой на аутсорс, значит сместить фокус на стратегические задачи, получить доступ к экспертизе опытных специалистов и гибким сервисам и сэкономить на развертывании и содержании своей ИТ-инфраструктуры.


	 Однако повышенный спрос на аутсорсинг ведет к жесткой конкуренции между провайдерами. Отличить опытного партнера от среднего исполнителя не всегда легко, и бизнес рискует столкнуться с финансовыми, репутационными, технологическими и операционными потерями. Недобросовестный исполнитель может нарушить сроки, допустить ошибку, повысить ценник в ходе работы или проигнорировать требования безопасности. А после — оставить все образовавшиеся проблемы заказчику: выплаты штрафов, простой бизнеса, извинения перед клиентами и восстановление сервисов.


	 Звучит пугающе, но потенциальные риски — не повод отказываться от ИТ-аутсорса, а напоминание, что к вопросу необходимо подойти ответственно.


«Красные флаги» при выборе ИТ-подрядчика

Слишком низкая цена

	 Если предложение кажется неправдоподобно выгодным, не стоит спешить. Квалифицированному провайдеру незачем занижать стоимость работы, а вот новички и фрилансеры могут демпинговать цены, чтобы получить первые кейсы и «набить руку». Вам удастся сэкономить, но качество останется под вопросом.


	 Нередко хитрые поставщики предлагают минимальный ценник, заключают договор, а затем наращивают бюджет. Например, обнаруживают, что ваш случай «критически сложный» и требует дополнительных работ, тонких настроек и т. д. К слову, растущие траты не гарантируют высокий уровень исполнения.


	 Компании, особенно в сегменте малого и среднего бизнеса, могут соглашаться на такие условия из-за ограниченного бюджета. Но скупой, как мы знаем, платит дважды. Как итог: перерасход средств, сорванные сроки, недоработанная инфраструктура, требующая постоянных доработок и расходы на ИТ-«спасателей» и юристов.


Несбыточные обещания

	 Когда подрядчик уверенно заявляет «сделаем за неделю» — это не всегда повод для радости. В ИТ, как и в ремонте: быстро, дешево и качественно одновременно не бывает. Можно выбрать только 2 условия.


	 Например, для разработки модуля документооборота нужно 320 часов работы (по 160 на каждый блок), их может выполнить 1 разработчик и потратить больше времени. Также есть опция параллельно задействовать 2 специалистов и закрыть задачу быстрее, но с доплатой за скорость. Если вам обещают закончить за 48 часов без повышения цены — стоит ожидать либо нерабочий продукт, либо срыв установленных сроков.


	 Надежный поставщик честно оценивает объем работы и не занижает трудочасы. Если сроки все-таки требуется сдвинуть, команда заранее предупреждает о сложностях и предлагает клиенту временные альтернативы, чтобы не навредить рабочим процессам.


Фейковость или отсутствие кейсов

	 Случается, что исполнитель хвалится кейсами внедрения ИТ-решений для международного бизнеса, а на ваш запрос не может предоставить ни одного контакта бывшего клиента и ни строки в портфолио. Почему?


	 Все просто: релевантный опыт либо совершенно отсутствует, либо реальные результаты оставляют желать лучшего.


Чек-лист: 6 критериев хорошего поставщика ИТ-услуг

Уровень зрелости и реальные результаты

	 Как давно компания на рынке? Через какие этапы прошла? Какие кризисы пережила и как из них вышла? Изучите рейтинги от крупных СМИ: если имя вашего кандидата фигурирует (без приставки «анти-»), это говорит о наработанной репутации.


	 Обратите внимание на раздел с кейсами. Сколько проектов? За какой период? В каких отраслях? Хороший поставщик не прячется за отговоркой «не можем показать по NDA» и делится кейсами, цифрами и результатами. Смело просите представить похожий проект и рассказать, как решали задачу, сколько времени потратили, какие были сложности и как с ними справились. Если нужно — запрашивайте контакты лояльных клиентов, чтобы убедиться в честности поставщика.


	 Кейсы «ОБИТ» находятся в открытом доступе. Увидеть результаты нашей работы можно здесь!


Отраслевая экспертиза

	 Не каждый подрядчик широкого профиля справится с отраслевой задачей. Выбирайте тех, у кого есть релевантный опыт в e-commerce, финтехе или другой нужной сфере. Чем больше проектов в вашей сфере, тем выше вероятность, что задача будет решена грамотно и с учетом отраслевой специфики. Например, для автоматизации процессов в логистике провайдер должен иметь соответствующую клиентскую базу и понимать логику процессов, нюансы документооборота и типовых интеграций.


Прозрачность коммерческого предложения и сметы

	 Детализированная смета защищает вас от скрытых платежей.


	 Предложение «сделаем от 300 тысяч рублей» следует читать как «рассчитывайте на 500 тысяч». Запрашивайте детальную смету, где четко прописана полная разбивка по срокам работы, прямые и косвенные затраты (расходы на лицензии и сертификаты безопасности, домены и хостинги, обучение персонала), порядок изменения бюджета и условия пост-поддержки. Например, если вы заказываете разработку CRM за 350 тысяч рублей, вы должны знать, что в смету входит 3 месяца поддержки, интеграция с телефонией и 1С и обучение сотрудников.


Готовность к поддержке после запуска

	 Поставщик, который уходит после релиза, — это как строитель, который сдает дом без ключей. Уточните, включает ли цена ИТ-сопровождение и на какой срок? Как быстро команда реагирует на баги? Например, в SLA-договоре может быть прописано, что команда подрядчика приступает к устранению критичных ошибок в течение часа.


Квалификация команды

	 Анализируйте не только репутацию компании, но и конкретных исполнителей, которым доверят ваш проект. Узнайте, сколько специалистов в команде и какой у них опыт. Если возникнут сомнения, запросите CV или LinkedIn ведущих исполнителей и предыдущие кейсы такой же сложности.


Гибкость решений

	 Не тратьте время на подрядчиков, упрямо предлагающих конкретный продукт, несмотря на то, что он не отвечает вашим финансовым возможностям или очевидно не закрывает поставленные задачи. Грамотный ИТ-партнер свободно лавирует между комплексными и точечными решениями, предлагает разные модели масштабирования и тарифы, адаптирует сервисы под требования конкретной отрасли и бизнеса.


Наглядный пример

Как хорошо

	 Один из кейсов «ОБИТ» — услуга по повышению устойчивости информационных систем банка «Санкт-Петербург» с помощью внешнего резервного дата-центра.


	 Мы предоставили площадку под размещение центра обработки данных (ЦОД) площадью 1 000 кв. м, которая отвечала требованиям VISA, MasterCard и международным стандартам финансовой отрасли. Все этапы проекта от планирования до переезда мы реализовали в согласованные сроки. Ключевой показатель — нулевой простой при миграции: ни один бизнес-процесс не пришлось останавливать. Для финансового сектора, где каждая минута может стоить миллионы рублей, это критически важно.


Как плохо

	 Реальный пример — дело Промтрансбанка. Подрядчик разработал дополнительный функционал для сайта банка, но не прописал в договоре правила работы с персональными данными. По вине одного из сотрудников подрядчика в сеть утек файл с данными клиентов Промтрансбанка. Банк получил штраф, а затем подал в суд на подрядчика и, конечно, выиграл дело, но понес репутационные потери.


Как найти подрядчика: пошаговая инструкция

	 Искать поставщика ИТ-услуг для бизнеса можно через:
-
рейтинги и каталоги российских ИТ-компаний (Рейтинг Рунета, ИТ-маркетплейс.рф);
-
рекомендации коллег и партнеров;
-
тендерные и электронные площадки (Сбербанк-АСТ, B2B-Center, РТС-тендер);
-
профессиональные сообщества: ИТ-рубрики на vc.ru, «Хабр», Telegram-чаты по теме (Digital, EdTech, логистика), где публикуют кейсы и обсуждают подрядчиков.
Когда список кандидатов составлен, переходите к составлению предложения:
1) Сформулируйте задачу. Не «нам нужен CRM», а «нам нужен ИТ-сервис для онлайн-записи клиентов, чтобы снизить нагрузку на колл-центр и повысить конверсию».
2) Проверьте реалистичность запроса. Для этого проведите небольшой бенчмарк (сравнение с аналогичными решениями на рынке) или мини-опрос среди знакомых предпринимателей. Это поможет понять, насколько ваш бюджет, сроки и ожидания соответствуют реальности.
3) Подготовьте техническое задание (ТЗ). Составьте короткий и структурированный документ с описанием задачи, базовыми требованиями и предполагаемыми KPI (ключевыми показателями эффективности). Например: «повысить скорость обработки заказов на складе на 30%», минимизировать ручной труд в воронке продаж».
4) Отправьте запрос выбранным компаниям. В запросе кратко изложите суть проекта, сроки, ограничения, а также укажите, какую информацию хотите получить в ответ: примеры кейсов, состав команды, примерные этапы работ и стоимость.
5) Проведите интервью с предполагаемыми партнерами. Пригласите на звонок не только менеджера по продажам, но и проектного менеджера и технического специалиста. По итогам нескольких встреч сравните цены, подход к реализации, сроки и условия поддержки.
6) Заключите детальный контракт с этапами и метриками. Обезопасьте свой бизнес, указав конкретные этапы работ, сроки, условия приема и ответственность каждый из сторон. Включите требования по защите информации, особенно если планируется работа с персональными данными, внутренними системами или финансовыми потоками.
Надежный ИТ для бизнеса — инвестиция в устойчивость
Выбор ИТ-поставщика во многом определяет, насколько безопасно и стабильно будет развиваться организация в цифровых условиях. Опирайтесь на опыт, прозрачность и готовность к диалогу и не экономьте на экспертизе. Надежный партнер поможет не только реализовать проект, но и обеспечит информационную безопасность для вашего бизнеса.
Команда «ОБИТ» уже 23 года помогает компаниям добиваться максимального результата в самых разных отраслях. Из небольшого провайдера мы выросли в многофункционального ИТ-оператора с глубокой телеком-экспертизой. В нашем портфеле более 800 федеральных и международных проектов, а в штате — более 500 квалифицированных специалистов. Мы знаем, как сделать сложное — простым. Обращайтесь за бесплатной консультацией!
[~DETAIL_TEXT] =>Проблемы выбора ИТ-поставщиков: как найти надежного партнера
Спрос на комплексные ИТ-проекты для бизнеса вырос в 2,5 раза только за первое полугодие 2025 года. При этом мы подсчитали, что почти половина внедрений проходит неудачно. Каждая вторая компания вынуждена дорабатывать решения после предыдущих поставщиков или реализовывать проект заново.
Как не попасть в эту печальную статистику? Установить сотрудничество с ИТ-подрядчиком, который станет драйвером развития, а не опасным элементом для вашего бизнеса.
В новой статье разберем, как не попасть в ловушку пустых обещаний и найти честного ИТ-партнера.
Чем опасен неправильный выбор?
Передать работу над информационной системой на аутсорс, значит сместить фокус на стратегические задачи, получить доступ к экспертизе опытных специалистов и гибким сервисам и сэкономить на развертывании и содержании своей ИТ-инфраструктуры.
Однако повышенный спрос на аутсорсинг ведет к жесткой конкуренции между провайдерами. Отличить опытного партнера от среднего исполнителя не всегда легко, и бизнес рискует столкнуться с финансовыми, репутационными, технологическими и операционными потерями. Недобросовестный исполнитель может нарушить сроки, допустить ошибку, повысить ценник в ходе работы или проигнорировать требования безопасности. А после — оставить все образовавшиеся проблемы заказчику: выплаты штрафов, простой бизнеса, извинения перед клиентами и восстановление сервисов.
Звучит пугающе, но потенциальные риски — не повод отказываться от ИТ-аутсорса, а напоминание, что к вопросу необходимо подойти ответственно.
«Красные флаги» при выборе ИТ-подрядчика
Слишком низкая цена
Если предложение кажется неправдоподобно выгодным, не стоит спешить. Квалифицированному провайдеру незачем занижать стоимость работы, а вот новички и фрилансеры могут демпинговать цены, чтобы получить первые кейсы и «набить руку». Вам удастся сэкономить, но качество останется под вопросом.
Нередко хитрые поставщики предлагают минимальный ценник, заключают договор, а затем наращивают бюджет. Например, обнаруживают, что ваш случай «критически сложный» и требует дополнительных работ, тонких настроек и т. д. К слову, растущие траты не гарантируют высокий уровень исполнения.
Компании, особенно в сегменте малого и среднего бизнеса, могут соглашаться на такие условия из-за ограниченного бюджета. Но скупой, как мы знаем, платит дважды. Как итог: перерасход средств, сорванные сроки, недоработанная инфраструктура, требующая постоянных доработок и расходы на ИТ-«спасателей» и юристов.
Несбыточные обещания
Когда подрядчик уверенно заявляет «сделаем за неделю» — это не всегда повод для радости. В ИТ, как и в ремонте: быстро, дешево и качественно одновременно не бывает. Можно выбрать только 2 условия.
Например, для разработки модуля документооборота нужно 320 часов работы (по 160 на каждый блок), их может выполнить 1 разработчик и потратить больше времени. Также есть опция параллельно задействовать 2 специалистов и закрыть задачу быстрее, но с доплатой за скорость. Если вам обещают закончить за 48 часов без повышения цены — стоит ожидать либо нерабочий продукт, либо срыв установленных сроков.
Надежный поставщик честно оценивает объем работы и не занижает трудочасы. Если сроки все-таки требуется сдвинуть, команда заранее предупреждает о сложностях и предлагает клиенту временные альтернативы, чтобы не навредить рабочим процессам.
Фейковость или отсутствие кейсов
Случается, что исполнитель хвалится кейсами внедрения ИТ-решений для международного бизнеса, а на ваш запрос не может предоставить ни одного контакта бывшего клиента и ни строки в портфолио. Почему?
Все просто: релевантный опыт либо совершенно отсутствует, либо реальные результаты оставляют желать лучшего.
Чек-лист: 6 критериев хорошего поставщика ИТ-услуг
Уровень зрелости и реальные результаты
Как давно компания на рынке? Через какие этапы прошла? Какие кризисы пережила и как из них вышла? Изучите рейтинги от крупных СМИ: если имя вашего кандидата фигурирует (без приставки «анти-»), это говорит о наработанной репутации.
Обратите внимание на раздел с кейсами. Сколько проектов? За какой период? В каких отраслях? Хороший поставщик не прячется за отговоркой «не можем показать по NDA» и делится кейсами, цифрами и результатами. Смело просите представить похожий проект и рассказать, как решали задачу, сколько времени потратили, какие были сложности и как с ними справились. Если нужно — запрашивайте контакты лояльных клиентов, чтобы убедиться в честности поставщика.
Кейсы «ОБИТ» находятся в открытом доступе. Увидеть результаты нашей работы можно здесь!
Отраслевая экспертиза
Не каждый подрядчик широкого профиля справится с отраслевой задачей. Выбирайте тех, у кого есть релевантный опыт в e-commerce, финтехе или другой нужной сфере. Чем больше проектов в вашей сфере, тем выше вероятность, что задача будет решена грамотно и с учетом отраслевой специфики. Например, для автоматизации процессов в логистике провайдер должен иметь соответствующую клиентскую базу и понимать логику процессов, нюансы документооборота и типовых интеграций.
Прозрачность коммерческого предложения и сметы
Детализированная смета защищает вас от скрытых платежей.
Предложение «сделаем от 300 тысяч рублей» следует читать как «рассчитывайте на 500 тысяч». Запрашивайте детальную смету, где четко прописана полная разбивка по срокам работы, прямые и косвенные затраты (расходы на лицензии и сертификаты безопасности, домены и хостинги, обучение персонала), порядок изменения бюджета и условия пост-поддержки. Например, если вы заказываете разработку CRM за 350 тысяч рублей, вы должны знать, что в смету входит 3 месяца поддержки, интеграция с телефонией и 1С и обучение сотрудников.
Готовность к поддержке после запуска
Поставщик, который уходит после релиза, — это как строитель, который сдает дом без ключей. Уточните, включает ли цена ИТ-сопровождение и на какой срок? Как быстро команда реагирует на баги? Например, в SLA-договоре может быть прописано, что команда подрядчика приступает к устранению критичных ошибок в течение часа.
Квалификация команды
Анализируйте не только репутацию компании, но и конкретных исполнителей, которым доверят ваш проект. Узнайте, сколько специалистов в команде и какой у них опыт. Если возникнут сомнения, запросите CV или LinkedIn ведущих исполнителей и предыдущие кейсы такой же сложности.
Гибкость решений
Не тратьте время на подрядчиков, упрямо предлагающих конкретный продукт, несмотря на то, что он не отвечает вашим финансовым возможностям или очевидно не закрывает поставленные задачи. Грамотный ИТ-партнер свободно лавирует между комплексными и точечными решениями, предлагает разные модели масштабирования и тарифы, адаптирует сервисы под требования конкретной отрасли и бизнеса.
Наглядный пример
Как хорошо
Один из кейсов «ОБИТ» — услуга по повышению устойчивости информационных систем банка «Санкт-Петербург» с помощью внешнего резервного дата-центра.
Мы предоставили площадку под размещение центра обработки данных (ЦОД) площадью 1 000 кв. м, которая отвечала требованиям VISA, MasterCard и международным стандартам финансовой отрасли. Все этапы проекта от планирования до переезда мы реализовали в согласованные сроки. Ключевой показатель — нулевой простой при миграции: ни один бизнес-процесс не пришлось останавливать. Для финансового сектора, где каждая минута может стоить миллионы рублей, это критически важно.
Как плохо
Реальный пример — дело Промтрансбанка. Подрядчик разработал дополнительный функционал для сайта банка, но не прописал в договоре правила работы с персональными данными. По вине одного из сотрудников подрядчика в сеть утек файл с данными клиентов Промтрансбанка. Банк получил штраф, а затем подал в суд на подрядчика и, конечно, выиграл дело, но понес репутационные потери.
Как найти подрядчика: пошаговая инструкция
Искать поставщика ИТ-услуг для бизнеса можно через:
-
рейтинги и каталоги российских ИТ-компаний (Рейтинг Рунета, ИТ-маркетплейс.рф);
-
рекомендации коллег и партнеров;
-
тендерные и электронные площадки (Сбербанк-АСТ, B2B-Center, РТС-тендер);
-
профессиональные сообщества: ИТ-рубрики на vc.ru, «Хабр», Telegram-чаты по теме (Digital, EdTech, логистика), где публикуют кейсы и обсуждают подрядчиков.
Когда список кандидатов составлен, переходите к составлению предложения:
1) Сформулируйте задачу. Не «нам нужен CRM», а «нам нужен ИТ-сервис для онлайн-записи клиентов, чтобы снизить нагрузку на колл-центр и повысить конверсию».
2) Проверьте реалистичность запроса. Для этого проведите небольшой бенчмарк (сравнение с аналогичными решениями на рынке) или мини-опрос среди знакомых предпринимателей. Это поможет понять, насколько ваш бюджет, сроки и ожидания соответствуют реальности.
3) Подготовьте техническое задание (ТЗ). Составьте короткий и структурированный документ с описанием задачи, базовыми требованиями и предполагаемыми KPI (ключевыми показателями эффективности). Например: «повысить скорость обработки заказов на складе на 30%», минимизировать ручной труд в воронке продаж».
4) Отправьте запрос выбранным компаниям. В запросе кратко изложите суть проекта, сроки, ограничения, а также укажите, какую информацию хотите получить в ответ: примеры кейсов, состав команды, примерные этапы работ и стоимость.
5) Проведите интервью с предполагаемыми партнерами. Пригласите на звонок не только менеджера по продажам, но и проектного менеджера и технического специалиста. По итогам нескольких встреч сравните цены, подход к реализации, сроки и условия поддержки.
6) Заключите детальный контракт с этапами и метриками. Обезопасьте свой бизнес, указав конкретные этапы работ, сроки, условия приема и ответственность каждый из сторон. Включите требования по защите информации, особенно если планируется работа с персональными данными, внутренними системами или финансовыми потоками.
Надежный ИТ для бизнеса — инвестиция в устойчивость
Выбор ИТ-поставщика во многом определяет, насколько безопасно и стабильно будет развиваться организация в цифровых условиях. Опирайтесь на опыт, прозрачность и готовность к диалогу и не экономьте на экспертизе. Надежный партнер поможет не только реализовать проект, но и обеспечит информационную безопасность для вашего бизнеса.
Команда «ОБИТ» уже 23 года помогает компаниям добиваться максимального результата в самых разных отраслях. Из небольшого провайдера мы выросли в многофункционального ИТ-оператора с глубокой телеком-экспертизой. В нашем портфеле более 800 федеральных и международных проектов, а в штате — более 500 квалифицированных специалистов. Мы знаем, как сделать сложное — простым. Обращайтесь за бесплатной консультацией!
[DETAIL_TEXT_TYPE] => html [~DETAIL_TEXT_TYPE] => html [PREVIEW_TEXT] => Спрос на комплексные ИТ-проекты для бизнеса вырос в 2,5 раза только за первое полугодие 2025 года. При этом мы подсчитали, что почти половина внедрений проходит неудачно. Каждая вторая компания вынуждена дорабатывать решения после предыдущих поставщиков или реализовывать проект заново. [~PREVIEW_TEXT] => Спрос на комплексные ИТ-проекты для бизнеса вырос в 2,5 раза только за первое полугодие 2025 года. При этом мы подсчитали, что почти половина внедрений проходит неудачно. Каждая вторая компания вынуждена дорабатывать решения после предыдущих поставщиков или реализовывать проект заново. [PREVIEW_TEXT_TYPE] => text [~PREVIEW_TEXT_TYPE] => text [PREVIEW_PICTURE] => [~PREVIEW_PICTURE] => [LANG_DIR] => / [~LANG_DIR] => / [CODE] => problemy-vybora-it-postavshchikov-kak-nayti-nadezhnogo-partnera [~CODE] => problemy-vybora-it-postavshchikov-kak-nayti-nadezhnogo-partnera [EXTERNAL_ID] => 2981 [~EXTERNAL_ID] => 2981 [IBLOCK_TYPE_ID] => content [~IBLOCK_TYPE_ID] => content [IBLOCK_CODE] => [~IBLOCK_CODE] => [IBLOCK_EXTERNAL_ID] => [~IBLOCK_EXTERNAL_ID] => [LID] => s1 [~LID] => s1 [EDIT_LINK] => [DELETE_LINK] => [DISPLAY_ACTIVE_FROM] => 30.07.2025 [FIELDS] => Array ( ) [DISPLAY_PROPERTIES] => Array ( ) [IPROPERTY_VALUES] => Array ( ) ) 1 ЧитатьИТ-аутсорсинг
04.03.2025
Тренды автоматизации бизнеса в 2026: что эффективно сейчас?
Array
(
    [ID] => 2805
    [~ID] => 2805
    [IBLOCK_ID] => 36
    [~IBLOCK_ID] => 36
    [IBLOCK_SECTION_ID] => 102
    [~IBLOCK_SECTION_ID] => 102
    [NAME] => Тренды автоматизации бизнеса в 2026: что эффективно сейчас?
    [~NAME] => Тренды автоматизации бизнеса в 2026: что эффективно сейчас?
    [ACTIVE_FROM_X] => 2025-03-04 00:00:00
    [~ACTIVE_FROM_X] => 2025-03-04 00:00:00
    [ACTIVE_FROM] => 04.03.2025
    [~ACTIVE_FROM] => 04.03.2025
    [TIMESTAMP_X] => 25.09.2026 13:54:11
    [~TIMESTAMP_X] => 25.09.2026 13:54:11
    [DETAIL_PAGE_URL] => /blog/avtomatizatsiya-biznesa/trendy-avtomatizatsii-biznesa-v-2025-chto-effektivno-seychas/
    [~DETAIL_PAGE_URL] => /blog/avtomatizatsiya-biznesa/trendy-avtomatizatsii-biznesa-v-2025-chto-effektivno-seychas/
    [LIST_PAGE_URL] => /blog/
    [~LIST_PAGE_URL] => /blog/
    [DETAIL_TEXT] => Тренды автоматизации бизнеса

	 Автоматизация перестала быть прерогативой крупных корпораций с миллионными бюджетами. В 2026 году она стала стандартом даже для малого и среднего бизнеса: компании внедряют ИИ-ассистентов, автоматизируют документооборот и используют RPA-системы для ускорения рутинных процессов. Причина проста – растущая конкуренция, дефицит квалифицированных кадров и необходимость оптимизировать расходы. Те, кто игнорирует тренд, теряют время и деньги, тогда как их конкуренты уже используют технологии для повышения эффективности.


	 Оператор ИТ-решений «Обит» проанализировал, как развивается отрасль, и выбрал самые важные и интересные веяния. Какие технологии действительно работают и помогают бизнесу экономить? Как компании автоматизируют ключевые процессы и какие ошибки совершают при внедрении? Разберем главные тренды автоматизации, проверенные на практике.

Автоматизация 2026: гонка технологий и новые возможности

	 Автоматизация бизнеса сегодня не только способ оптимизировать процессы, а стратегическая необходимость. В условиях роста издержек компании ищут решения, которые помогут им работать быстрее, эффективнее и с меньшими затратами. Производители программного обеспечения, в свою очередь, активно конкурируют за внимание клиентов, предлагая всё более продвинутые технологии. Искусственный интеллект, машинное обучение и роботизация позволяют автоматизировать задачи, которые раньше казались исключительно прерогативой человека.


	 Количество новых решений растёт с каждым годом: появляются платформы, ускоряющие документооборот, ИИ-ассистенты, помогающие в аналитике и прогнозировании, голосовые боты, заменяющие операторов колл-центров. При этом многие разработки действительно выглядят революционными: ещё несколько лет назад мало кто мог представить, что искусственный интеллект сможет полноценно анализировать финансовые отчёты или автоматически генерировать сложные юридические документы.


	 Но автоматизация – это не только новые технологии. Уже известные продукты эволюционируют, становясь удобнее и мощнее. Например, недавняя интеграция ИИ в «Битрикс24» значительно упростила работу с CRM: теперь система самостоятельно обрабатывает входящие заявки, анализирует поведение клиентов и предлагает персонализированные сценарии взаимодействия. Такие обновления делают автоматизацию не просто полезной, а максимально доступной для бизнеса любого масштаба.

Как автоматизация меняет бизнес

	 Развитие автоматизированных технологий меняет не только бизнес-процессы, но и саму структуру занятости. Всё больше рутинных задач передаётся алгоритмам и роботизированным системам, позволяя компаниям сокращать расходы и повышать производительность. Но автоматизация – это не только про экономию, но и про доступ к новым возможностям, которые раньше были прерогативой только крупных игроков.

Сокращение затрат на персонал: алгоритмы вместо людей

	 Одним из самых очевидных эффектов автоматизации стало снижение затрат на фонд оплаты труда. Компании всё чаще отказываются от вспомогательного персонала, передавая его функции цифровым решениям. Например, ИИ-системы теперь:
-
сортируют электронную почту и автоматически распределяют входящие запросы;
-
проверяют документы, анализируют их содержимое и выявляют ошибки без участия человека;
-
обрабатывают звонки, направляя клиентов сразу к нужному специалисту или предоставляя готовые ответы;
-
используют компьютерное зрение для выявления брака на производстве и сортировки продукции.
Роботизированные системы работают быстрее, не устают, не ошибаются из-за невнимательности и не требуют ежемесячной зарплаты. Поэтому неудивительно, что компании массово переходят на такие решения, высвобождая бюджеты для других направлений. В ближайшие годы эта тенденция только усилится: бизнес стремится минимизировать человеческий фактор там, где он не даёт конкурентных преимуществ.
Экономия времени и ресурсов на бизнес-задачи
Автоматизация затронула и интеллектуальную работу. Задачи, которые раньше требовали часов и даже дней работы специалистов, теперь выполняются за секунды. Искусственный интеллект уже успешно справляется с:
-
генерацией текстов, изображений и презентаций, создавая контент для маркетинга и внутренней документации;
-
анализом больших массивов данных, выявляя тренды, аномалии и закономерности;
-
поиском информации, ускоряя подготовку отчётов и стратегических решений.
Этот подход выгоден сразу в двух направлениях: сотрудники тратят меньше времени на рутину и могут сосредоточиться на более важных задачах, а компании экономят деньги, сокращая потребность в подрядчиках. Например, если раньше бизнесу нужно было заказывать рекламные тексты или графику у сторонних специалистов, то теперь это можно сделать с помощью автоматизированных инструментов – быстро и без дополнительных затрат.
Новые возможности для малого бизнеса
Раньше индивидуальные предприниматели и небольшие компании не могли позволить себе сложные маркетинговые кампании, персонализированное обслуживание клиентов или регулярную аналитику. Всё это требовало значительных вложений и квалифицированных специалистов. Но с появлением автоматизированных сервисов ситуация изменилась.
Теперь малый бизнес может:
-
за несколько минут создать сайт с помощью генераторов на основе ИИ, не привлекая разработчиков;
-
запустить рекламу, которую алгоритмы автоматически адаптируют под целевую аудиторию;
-
анализировать конкурентов и получать персонализированные рекомендации для продвижения;
-
использовать виртуальных ассистентов вместо штатных секретарей, снижая административные расходы.
Это значит, что технологии уравнивают шансы: даже небольшие компании теперь могут конкурировать с крупными бизнесами, используя те же инструменты, но без больших бюджетов.
Как итог современные инструменты автоматизации снижают издержки, ускоряет выполнение задач и делает бизнес-процессы доступнее для всех. Если раньше эффективность компании зависела от количества нанятых сотрудников, то теперь она определяется тем, насколько грамотно внедрены цифровые решения.
Ключевые направления автоматизации бизнеса и эффективные инструменты
Рассмотрим основные направления и популярные инструменты, применяемые в России.
Маркетинг
Современные инструменты существенно облегчили задачи маркетологов, позволяя справляться с ними быстрее и без необходимости привлекать дополнительных сотрудников. Давайте рассмотрим наиболее популярные решения:
Создание контента
Благодаря нейросетям процесс создания текстов, изображений, видео и аудиодорожек стал значительно проще. Теперь для этого не обязательно иметь профессиональные навыки, нанимать копирайтера, дизайнера или монтажёра – нейросети справляются с этими задачами самостоятельно.
Для текстов. Могут создавать статьи для блогов, посты для мессенджеров, карточки товаров для маркетплейсов, описания товаров и услуг, а также делать анализ больших текстов, генерировать идеи для новых продуктов, услуг, рекламных кампаний, писать адаптированные под ЦА коммерческие предложения, тексты лэндингов и многое, многое другое:
-
ChatGPT – универсальная, самая мощная и популярная языковая модель ИИ для генерации идей, написания статей, рекламных текстов и сценариев. Использование продукта платное.
-
DeepSeek и GigaChat – хотя и не такие мощные, но бесплатные аналоги.
Для изображений:
-
Midjourney и Stable Diffusion – наиболее мощные и популярные нейросети для создания очень качественного визуального контента.
-
Kandinsky и Шедеврум – российские бесплатные аналоги, также позволяющие генерировать качественные изображения по описанию.
Для видео и аудио:
-
Sora, Runway ML и Kling – сервисы для генерации видео на основе текста и статичных изображений. Позволяют визуализировать различные идеи и использовать их на сайте, соц. сетях или в рекламе.
-
ElevenLabs – инструмент для создания синтетической речи. Позволяет клонировать голос либо использовать заготовленный из библиотеки. Подойдёт для озвучки рекламных роликов, видеоинструкций, закадрового голоса и т.д.
Мониторинг репутации и отзывов
Автоматизированный мониторинг отзывов позволяет полностью отказаться от ручной проверки благодаря специализированным сервисам, отслеживающим репутацию в сети. Такие платформы собирают данные со всех ресурсов, где упоминается ваша компания, и предоставляют детализированные аналитические отчёты, включая анализ тональности и содержания отзывов. Такой инструмент особенно востребован среди крупных организаций. Одними из таких сервисов являются: Reputometer, Brand Analytics и YouScan.
Создание сайтов
Современные нейросети позволяют создавать сайты буквально за несколько минут, просто на основе текстового описания. Эти инструменты подходят, когда нет времени или навыков для самостоятельной верстки, но требуется быстро запустить лендинг на нужную тематику. Примеры сервисов: Mixo, Durable AI и Craftum AI.
ИИ-инструменты для генерации сайтов значительно упрощают процесс создания веб-страниц, позволяя компаниям быстро запускать маркетинговые кампании без привлечения специалистов.
Документооборот
В последние годы автоматизация документооборота вышла на новый уровень благодаря инновационным стартапам, предлагающим решения для автоматической генерации, редактирования и юридической проверки документов.
Системы этой категории помогают создавать, редактировать и проверять документы, используя заранее настроенные шаблоны.
-
QForm – сервис автоматической генерации счетов, договоров и актов. Позволяет настраивать шаблоны с динамическими полями и получать готовые документы за секунды без необходимости вручную вводить одни и те же данные.
-
Юрайт – предлагают инструмент для автоматической сборки документов по заданным шаблонам. Подходит для автоматизации отчетности и быстрой подготовки различных юридических и бухгалтерских документов.
-
Contract (Embedika) – платформа, использующая ИИ для проверки документов с юридической стороны. Определяет рисковые формулировки, предлагает корректировки и помогает минимизировать правовые ошибки. Отлично подходит, если у вас нет возможности содержать в штате собственного юриста.
HR (Управление персоналом)
Одни из основных инструментов автоматизации HR в последние годы – HRM и ATS системы. Они позволяют автоматизировать, а также сделать гораздо более удобным и эффективным процесс подбора, обучения и развития персонала внутри компании.
- HRM-системы.
Направлены на автоматизацию работы с текущим персоналом. Позволяют эффективно управлять циклом сотрудников с этапа устройства до увольнения сотрудника. Популярные на рынке решения: Битрикс24.HRM, SimpleOne HRMS и Mirapolis.
- ATS-системы.
Системы автоматизации рекрутинга помогают HR-отделам быстро обрабатывать отклики, анализировать резюме и управлять процессом найма. Среди них: Huntflow, Талантикс и Сберподбор.
- Системы развития персонала и корпоративного обучения.
Платформы этой категории помогают обучать сотрудников, контролировать их профессиональный рост и внедрять программы повышения квалификации. Здесь можно выделить: iSpring Learn и Skillslace.
Интеграция этих инструментов в HR-процессы позволяет компаниям не только оптимизировать административные задачи, но и создать благоприятные условия для привлечения, удержания и развития талантливых специалистов, что в конечном итоге способствует достижению стратегических целей бизнеса.
Бухгалтерия и финансовый учёт
Сервисы, предлагающие ИИ-решения для автоматизации бухгалтерии, учёта финансов, автоматического ведения и отправки отчётности:
-
Эльба – сервис для автоматизации бух. учёта в небольших организациях. Подходит для людей, которые не разбираются в бухгалтерии;
-
Контур. Бухгалтерия – подходит для более крупных компаний и представляет собой комплексный инструмент для автоматизации бухгалтерского, налогового и кадрового учёта. Широкий функционал охватывает направления от расчёта зарплаты, больничных и отпускных до учёта производства с оформлением выпуска и продажи продукции;
-
Финолог – платформа для управления финансами малого и среднего бизнеса, применяющая ИИ для анализа денежных потоков и прогнозирования бюджета.
Телефония
Приём и обработка звонков — то, с чем сталкивается большинство организаций. При большом количестве обращений встаёт вопрос об оптимизации и повышении эффективности данного процесса. Вкратце разберём основные инструменты для закрытия этой задачи:
-
АТС-система. Это первоочередная вещь для организации контакт-центра. АТС необходима если вам требуется распределять звонки между сотрудниками, вести их учёт и аналитику, а также использовать голосовых помощников. Последние годы всё большую популярность приобретают виртуальные (облачные) АТС. Они максимально просты в интеграции, и не требуют покупки дорогостоящего оборудования, а также затрат на обслуживание, по сравнению с традиционным вариантом АТС, что делает их гибким и экономным вариантом. ВАТС от «Обит» разработана на базе нашего собственного ПО, и отличается отказоустойчивостью, масштабируемостью и гибкостью, что делает её одной из лучших систем на рынке.
-
ПО для автоматизации контактных центров. Позволяет объединить все коммуникации (звонки, голосовой чат, SMS и другие) в рамках одной платформы, сократить время обслуживания клиента, назначить сценарии обработки звонков, планировать нагрузку и вести удобную отчётность. Своим клиентам мы предлагаем и интегрируем ПО от Naumen, как одно из самых эффективных решений на рынке.
-
Речевая аналитика. Системы, предназначенные для автоматического анализа и контроля качества коммуникации сотрудников с клиентами. Позволяют оценивать эффективность используемых скриптов, выявлять скрытые потребности клиентов или негатив при общении. Подробнее о решении можно прочитать на странице.
Управление запасами
Современные технологии стремительно трансформируют процессы управления запасами, делая их более эффективными и интеллектуальными. Особое внимание заслуживают SRM-системы (Supplier Relationship Management), которые позволяют автоматизировать закупки на всех этапах и обеспечивать оптимальные условия поставок.
На рынке в данный момент представлено множество SRM систем, но можно выделить наиболее популярные: AGORA SRM, Лот Эксперт и Comindware.
Система анализирует большие объемы данных, предсказывает потребности и выбирает оптимальных поставщиков, что приводит к снижению затрат и улучшению качества управления запасами.
Выводы
Успех автоматизации зависит не только от технологий, но и от правильного подхода к их внедрению. Важно четко определить бизнес-задачи, которые она должна решить, выбрать надежных партнеров и провести обучение сотрудников. Специалисты «Обит» считают, что компании, которые подошли к этому процессу комплексно и стратегически, получили максимальный эффект и избежали распространенных ошибок. В 2026 такие инструменты автоматизации становятся всё более эффективными, и это самое подходящее время, чтобы внедрять их в новые процессы.
[~DETAIL_TEXT] =>Тренды автоматизации бизнеса
Автоматизация перестала быть прерогативой крупных корпораций с миллионными бюджетами. В 2026 году она стала стандартом даже для малого и среднего бизнеса: компании внедряют ИИ-ассистентов, автоматизируют документооборот и используют RPA-системы для ускорения рутинных процессов. Причина проста – растущая конкуренция, дефицит квалифицированных кадров и необходимость оптимизировать расходы. Те, кто игнорирует тренд, теряют время и деньги, тогда как их конкуренты уже используют технологии для повышения эффективности.
Оператор ИТ-решений «Обит» проанализировал, как развивается отрасль, и выбрал самые важные и интересные веяния. Какие технологии действительно работают и помогают бизнесу экономить? Как компании автоматизируют ключевые процессы и какие ошибки совершают при внедрении? Разберем главные тренды автоматизации, проверенные на практике.
Автоматизация 2026: гонка технологий и новые возможности
Автоматизация бизнеса сегодня не только способ оптимизировать процессы, а стратегическая необходимость. В условиях роста издержек компании ищут решения, которые помогут им работать быстрее, эффективнее и с меньшими затратами. Производители программного обеспечения, в свою очередь, активно конкурируют за внимание клиентов, предлагая всё более продвинутые технологии. Искусственный интеллект, машинное обучение и роботизация позволяют автоматизировать задачи, которые раньше казались исключительно прерогативой человека.
Количество новых решений растёт с каждым годом: появляются платформы, ускоряющие документооборот, ИИ-ассистенты, помогающие в аналитике и прогнозировании, голосовые боты, заменяющие операторов колл-центров. При этом многие разработки действительно выглядят революционными: ещё несколько лет назад мало кто мог представить, что искусственный интеллект сможет полноценно анализировать финансовые отчёты или автоматически генерировать сложные юридические документы.
Но автоматизация – это не только новые технологии. Уже известные продукты эволюционируют, становясь удобнее и мощнее. Например, недавняя интеграция ИИ в «Битрикс24» значительно упростила работу с CRM: теперь система самостоятельно обрабатывает входящие заявки, анализирует поведение клиентов и предлагает персонализированные сценарии взаимодействия. Такие обновления делают автоматизацию не просто полезной, а максимально доступной для бизнеса любого масштаба.
Как автоматизация меняет бизнес
Развитие автоматизированных технологий меняет не только бизнес-процессы, но и саму структуру занятости. Всё больше рутинных задач передаётся алгоритмам и роботизированным системам, позволяя компаниям сокращать расходы и повышать производительность. Но автоматизация – это не только про экономию, но и про доступ к новым возможностям, которые раньше были прерогативой только крупных игроков.
Сокращение затрат на персонал: алгоритмы вместо людей
Одним из самых очевидных эффектов автоматизации стало снижение затрат на фонд оплаты труда. Компании всё чаще отказываются от вспомогательного персонала, передавая его функции цифровым решениям. Например, ИИ-системы теперь:
-
сортируют электронную почту и автоматически распределяют входящие запросы;
-
проверяют документы, анализируют их содержимое и выявляют ошибки без участия человека;
-
обрабатывают звонки, направляя клиентов сразу к нужному специалисту или предоставляя готовые ответы;
-
используют компьютерное зрение для выявления брака на производстве и сортировки продукции.
Роботизированные системы работают быстрее, не устают, не ошибаются из-за невнимательности и не требуют ежемесячной зарплаты. Поэтому неудивительно, что компании массово переходят на такие решения, высвобождая бюджеты для других направлений. В ближайшие годы эта тенденция только усилится: бизнес стремится минимизировать человеческий фактор там, где он не даёт конкурентных преимуществ.
Экономия времени и ресурсов на бизнес-задачи
Автоматизация затронула и интеллектуальную работу. Задачи, которые раньше требовали часов и даже дней работы специалистов, теперь выполняются за секунды. Искусственный интеллект уже успешно справляется с:
-
генерацией текстов, изображений и презентаций, создавая контент для маркетинга и внутренней документации;
-
анализом больших массивов данных, выявляя тренды, аномалии и закономерности;
-
поиском информации, ускоряя подготовку отчётов и стратегических решений.
Этот подход выгоден сразу в двух направлениях: сотрудники тратят меньше времени на рутину и могут сосредоточиться на более важных задачах, а компании экономят деньги, сокращая потребность в подрядчиках. Например, если раньше бизнесу нужно было заказывать рекламные тексты или графику у сторонних специалистов, то теперь это можно сделать с помощью автоматизированных инструментов – быстро и без дополнительных затрат.
Новые возможности для малого бизнеса
Раньше индивидуальные предприниматели и небольшие компании не могли позволить себе сложные маркетинговые кампании, персонализированное обслуживание клиентов или регулярную аналитику. Всё это требовало значительных вложений и квалифицированных специалистов. Но с появлением автоматизированных сервисов ситуация изменилась.
Теперь малый бизнес может:
-
за несколько минут создать сайт с помощью генераторов на основе ИИ, не привлекая разработчиков;
-
запустить рекламу, которую алгоритмы автоматически адаптируют под целевую аудиторию;
-
анализировать конкурентов и получать персонализированные рекомендации для продвижения;
-
использовать виртуальных ассистентов вместо штатных секретарей, снижая административные расходы.
Это значит, что технологии уравнивают шансы: даже небольшие компании теперь могут конкурировать с крупными бизнесами, используя те же инструменты, но без больших бюджетов.
Как итог современные инструменты автоматизации снижают издержки, ускоряет выполнение задач и делает бизнес-процессы доступнее для всех. Если раньше эффективность компании зависела от количества нанятых сотрудников, то теперь она определяется тем, насколько грамотно внедрены цифровые решения.
Ключевые направления автоматизации бизнеса и эффективные инструменты
Рассмотрим основные направления и популярные инструменты, применяемые в России.
Маркетинг
Современные инструменты существенно облегчили задачи маркетологов, позволяя справляться с ними быстрее и без необходимости привлекать дополнительных сотрудников. Давайте рассмотрим наиболее популярные решения:
Создание контента
Благодаря нейросетям процесс создания текстов, изображений, видео и аудиодорожек стал значительно проще. Теперь для этого не обязательно иметь профессиональные навыки, нанимать копирайтера, дизайнера или монтажёра – нейросети справляются с этими задачами самостоятельно.
Для текстов. Могут создавать статьи для блогов, посты для мессенджеров, карточки товаров для маркетплейсов, описания товаров и услуг, а также делать анализ больших текстов, генерировать идеи для новых продуктов, услуг, рекламных кампаний, писать адаптированные под ЦА коммерческие предложения, тексты лэндингов и многое, многое другое:
-
ChatGPT – универсальная, самая мощная и популярная языковая модель ИИ для генерации идей, написания статей, рекламных текстов и сценариев. Использование продукта платное.
-
DeepSeek и GigaChat – хотя и не такие мощные, но бесплатные аналоги.
Для изображений:
-
Midjourney и Stable Diffusion – наиболее мощные и популярные нейросети для создания очень качественного визуального контента.
-
Kandinsky и Шедеврум – российские бесплатные аналоги, также позволяющие генерировать качественные изображения по описанию.
Для видео и аудио:
-
Sora, Runway ML и Kling – сервисы для генерации видео на основе текста и статичных изображений. Позволяют визуализировать различные идеи и использовать их на сайте, соц. сетях или в рекламе.
-
ElevenLabs – инструмент для создания синтетической речи. Позволяет клонировать голос либо использовать заготовленный из библиотеки. Подойдёт для озвучки рекламных роликов, видеоинструкций, закадрового голоса и т.д.
Мониторинг репутации и отзывов
Автоматизированный мониторинг отзывов позволяет полностью отказаться от ручной проверки благодаря специализированным сервисам, отслеживающим репутацию в сети. Такие платформы собирают данные со всех ресурсов, где упоминается ваша компания, и предоставляют детализированные аналитические отчёты, включая анализ тональности и содержания отзывов. Такой инструмент особенно востребован среди крупных организаций. Одними из таких сервисов являются: Reputometer, Brand Analytics и YouScan.
Создание сайтов
Современные нейросети позволяют создавать сайты буквально за несколько минут, просто на основе текстового описания. Эти инструменты подходят, когда нет времени или навыков для самостоятельной верстки, но требуется быстро запустить лендинг на нужную тематику. Примеры сервисов: Mixo, Durable AI и Craftum AI.
ИИ-инструменты для генерации сайтов значительно упрощают процесс создания веб-страниц, позволяя компаниям быстро запускать маркетинговые кампании без привлечения специалистов.
Документооборот
В последние годы автоматизация документооборота вышла на новый уровень благодаря инновационным стартапам, предлагающим решения для автоматической генерации, редактирования и юридической проверки документов.
Системы этой категории помогают создавать, редактировать и проверять документы, используя заранее настроенные шаблоны.
-
QForm – сервис автоматической генерации счетов, договоров и актов. Позволяет настраивать шаблоны с динамическими полями и получать готовые документы за секунды без необходимости вручную вводить одни и те же данные.
-
Юрайт – предлагают инструмент для автоматической сборки документов по заданным шаблонам. Подходит для автоматизации отчетности и быстрой подготовки различных юридических и бухгалтерских документов.
-
Contract (Embedika) – платформа, использующая ИИ для проверки документов с юридической стороны. Определяет рисковые формулировки, предлагает корректировки и помогает минимизировать правовые ошибки. Отлично подходит, если у вас нет возможности содержать в штате собственного юриста.
HR (Управление персоналом)
Одни из основных инструментов автоматизации HR в последние годы – HRM и ATS системы. Они позволяют автоматизировать, а также сделать гораздо более удобным и эффективным процесс подбора, обучения и развития персонала внутри компании.
- HRM-системы.
Направлены на автоматизацию работы с текущим персоналом. Позволяют эффективно управлять циклом сотрудников с этапа устройства до увольнения сотрудника. Популярные на рынке решения: Битрикс24.HRM, SimpleOne HRMS и Mirapolis.
- ATS-системы.
Системы автоматизации рекрутинга помогают HR-отделам быстро обрабатывать отклики, анализировать резюме и управлять процессом найма. Среди них: Huntflow, Талантикс и Сберподбор.
- Системы развития персонала и корпоративного обучения.
Платформы этой категории помогают обучать сотрудников, контролировать их профессиональный рост и внедрять программы повышения квалификации. Здесь можно выделить: iSpring Learn и Skillslace.
Интеграция этих инструментов в HR-процессы позволяет компаниям не только оптимизировать административные задачи, но и создать благоприятные условия для привлечения, удержания и развития талантливых специалистов, что в конечном итоге способствует достижению стратегических целей бизнеса.
Бухгалтерия и финансовый учёт
Сервисы, предлагающие ИИ-решения для автоматизации бухгалтерии, учёта финансов, автоматического ведения и отправки отчётности:
-
Эльба – сервис для автоматизации бух. учёта в небольших организациях. Подходит для людей, которые не разбираются в бухгалтерии;
-
Контур. Бухгалтерия – подходит для более крупных компаний и представляет собой комплексный инструмент для автоматизации бухгалтерского, налогового и кадрового учёта. Широкий функционал охватывает направления от расчёта зарплаты, больничных и отпускных до учёта производства с оформлением выпуска и продажи продукции;
-
Финолог – платформа для управления финансами малого и среднего бизнеса, применяющая ИИ для анализа денежных потоков и прогнозирования бюджета.
Телефония
Приём и обработка звонков — то, с чем сталкивается большинство организаций. При большом количестве обращений встаёт вопрос об оптимизации и повышении эффективности данного процесса. Вкратце разберём основные инструменты для закрытия этой задачи:
-
АТС-система. Это первоочередная вещь для организации контакт-центра. АТС необходима если вам требуется распределять звонки между сотрудниками, вести их учёт и аналитику, а также использовать голосовых помощников. Последние годы всё большую популярность приобретают виртуальные (облачные) АТС. Они максимально просты в интеграции, и не требуют покупки дорогостоящего оборудования, а также затрат на обслуживание, по сравнению с традиционным вариантом АТС, что делает их гибким и экономным вариантом. ВАТС от «Обит» разработана на базе нашего собственного ПО, и отличается отказоустойчивостью, масштабируемостью и гибкостью, что делает её одной из лучших систем на рынке.
-
ПО для автоматизации контактных центров. Позволяет объединить все коммуникации (звонки, голосовой чат, SMS и другие) в рамках одной платформы, сократить время обслуживания клиента, назначить сценарии обработки звонков, планировать нагрузку и вести удобную отчётность. Своим клиентам мы предлагаем и интегрируем ПО от Naumen, как одно из самых эффективных решений на рынке.
-
Речевая аналитика. Системы, предназначенные для автоматического анализа и контроля качества коммуникации сотрудников с клиентами. Позволяют оценивать эффективность используемых скриптов, выявлять скрытые потребности клиентов или негатив при общении. Подробнее о решении можно прочитать на странице.
Управление запасами
Современные технологии стремительно трансформируют процессы управления запасами, делая их более эффективными и интеллектуальными. Особое внимание заслуживают SRM-системы (Supplier Relationship Management), которые позволяют автоматизировать закупки на всех этапах и обеспечивать оптимальные условия поставок.
На рынке в данный момент представлено множество SRM систем, но можно выделить наиболее популярные: AGORA SRM, Лот Эксперт и Comindware.
Система анализирует большие объемы данных, предсказывает потребности и выбирает оптимальных поставщиков, что приводит к снижению затрат и улучшению качества управления запасами.
Выводы
Успех автоматизации зависит не только от технологий, но и от правильного подхода к их внедрению. Важно четко определить бизнес-задачи, которые она должна решить, выбрать надежных партнеров и провести обучение сотрудников. Специалисты «Обит» считают, что компании, которые подошли к этому процессу комплексно и стратегически, получили максимальный эффект и избежали распространенных ошибок. В 2026 такие инструменты автоматизации становятся всё более эффективными, и это самое подходящее время, чтобы внедрять их в новые процессы.
[DETAIL_TEXT_TYPE] => html [~DETAIL_TEXT_TYPE] => html [PREVIEW_TEXT] => Автоматизация перестала быть прерогативой крупных корпораций с миллионными бюджетами. В 2026 году она стала стандартом даже для малого и среднего бизнеса: компании внедряют ИИ-ассистентов, автоматизируют документооборот и используют RPA-системы для ускорения рутинных процессов. Причина проста – растущая конкуренция, дефицит квалифицированных кадров и необходимость оптимизировать расходы. Те, кто игнорирует тренд, теряют время и деньги, тогда как их конкуренты уже используют технологии для повышения эффективности. [~PREVIEW_TEXT] => Автоматизация перестала быть прерогативой крупных корпораций с миллионными бюджетами. В 2026 году она стала стандартом даже для малого и среднего бизнеса: компании внедряют ИИ-ассистентов, автоматизируют документооборот и используют RPA-системы для ускорения рутинных процессов. Причина проста – растущая конкуренция, дефицит квалифицированных кадров и необходимость оптимизировать расходы. Те, кто игнорирует тренд, теряют время и деньги, тогда как их конкуренты уже используют технологии для повышения эффективности. [PREVIEW_TEXT_TYPE] => text [~PREVIEW_TEXT_TYPE] => text [PREVIEW_PICTURE] => [~PREVIEW_PICTURE] => [LANG_DIR] => / [~LANG_DIR] => / [CODE] => trendy-avtomatizatsii-biznesa-v-2025-chto-effektivno-seychas [~CODE] => trendy-avtomatizatsii-biznesa-v-2025-chto-effektivno-seychas [EXTERNAL_ID] => 2805 [~EXTERNAL_ID] => 2805 [IBLOCK_TYPE_ID] => content [~IBLOCK_TYPE_ID] => content [IBLOCK_CODE] => [~IBLOCK_CODE] => [IBLOCK_EXTERNAL_ID] => [~IBLOCK_EXTERNAL_ID] => [LID] => s1 [~LID] => s1 [EDIT_LINK] => [DELETE_LINK] => [DISPLAY_ACTIVE_FROM] => 04.03.2025 [FIELDS] => Array ( ) [DISPLAY_PROPERTIES] => Array ( ) [IPROPERTY_VALUES] => Array ( [ELEMENT_META_DESCRIPTION] => Эффективные инструменты автоматизации в 2025 ) ) 1 ЧитатьАвтоматизация бизнеса